작은 공개 모델 Gemma 4에 식물 DNA 전문 모델을 붙였더니… 멜론 돌연변이 후보 2,494개에서 정답을 1위로
파리의 AI 생물학 연구소 Living Models가 Gemma 4 E4B와 식물 유전체 모델 BOTANIC-1을 묶어, 이미 실험으로 밝혀진 멜론 돌연변이를 다시 찾아내는 시험을 했어요. 멜론 한 가지 사례를 20번 반복한 결과이고, 만든 곳이 직접 잰 값이에요.
- Living Models는 글을 다루는 작은 공개 모델 Gemma 4 E4B가 작업 순서를 짜고, 식물 320종의 DNA로 미리 학습한 전문 모델 BOTANIC-1이 돌연변이 후보에 점수를 매기는 구조를 시험했어요. NVIDIA L4 GPU 한 장에서 Ollama로 돌려요.
- 멜론 꽃의 성별을 바꾸는 CmEIN3 유전자의 돌연변이(이미 실험으로 확인된 정답)를 2번 염색체 후보 2,494개 가운데 동점 없이 1위로 골랐어요. 정답을 1위로 올린 비율은 20번 가운데 18번(0.90)이고, 기존 분석 도구만 쓴 경우는 0.15였어요.
- 멜론 한 가지 사례이고 답을 이미 아는 문제를 다시 푼 시험이에요. 논문은 아직 심사를 거치지 않았고 저자 모두 Living Models 소속이에요. BOTANIC-1은 Hugging Face에서 받지만 비상업 연구용으로만 쓸 수 있어요.
글을 다루는 모델이 못 읽는 자료(숫자 표, 신호, DNA처럼 글이 아닌 것)를 다뤄야 할 때, 큰 모델 하나에 다 맡기지 않고 '작은 모델이 순서를 짜고 전문 모델이 점수를 매기는' 구조를 참고할 수 있어요. 공식 글에 구성 그림이 있어요.
식물 유전체를 다루지 않는다면 당장 할 일은 없어요. '작은 공개 모델도 전문 도구를 쥐여 주면 큰 모델 없이 전문 작업을 한다'는 흐름만 알아 두면 돼요.
자동화 도구를 직접 만드는 분이라면, 모델 하나에 전부 시키기 전에 '지휘는 작은 모델, 판정은 전문 도구'로 일을 나누는 구조를 한 번 떠올려 보면 좋을 것 같아요. 식물 연구를 하지 않는다면 읽고 넘어가도 괜찮아 보여요.
구글의 공개 모델 Gemma 공식 계정이 10월 8일(한국 시간) 파리의 AI 생물학 연구소 Living Models의 사례를 소개했어요. 글을 다루는 작은 모델 Gemma 4 E4B와 식물 DNA만 학습한 전문 모델 BOTANIC-1을 이어 붙여, 작물의 특징을 만드는 돌연변이를 찾는 시험이에요.
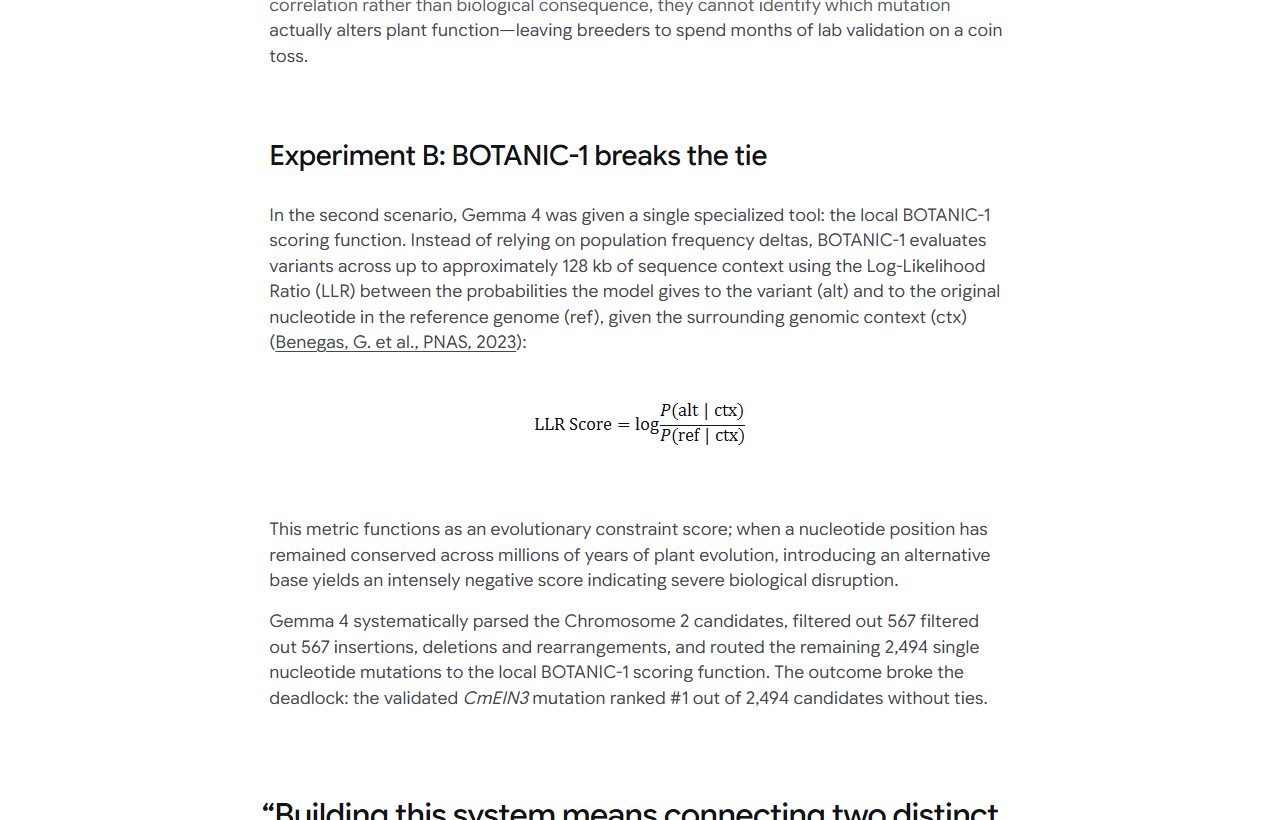
어떤 구조인가 — 역할을 둘로 나눴어요. Gemma 4 E4B는 분석 순서를 짜고 명령어를 실행하는 지휘 역할을 해요. BOTANIC-1은 식물 320종의 유전체(생물이 가진 DNA 전체)로 미리 학습한 모델로, 돌연변이 하나하나에 '이 자리의 글자가 바뀌면 얼마나 이상한가'를 점수로 매겨요. 오랜 진화 동안 바뀌지 않은 자리일수록 바뀌었을 때 점수가 크게 나빠져요. 공식 글은 더 큰 모델을 써도 정확도는 오르지 않고 운영 부담만 늘었다며, E4B를 NVIDIA L4 GPU 한 장에서 Ollama(내 컴퓨터에서 모델을 돌리는 프로그램)로 돌렸다고 설명해요.
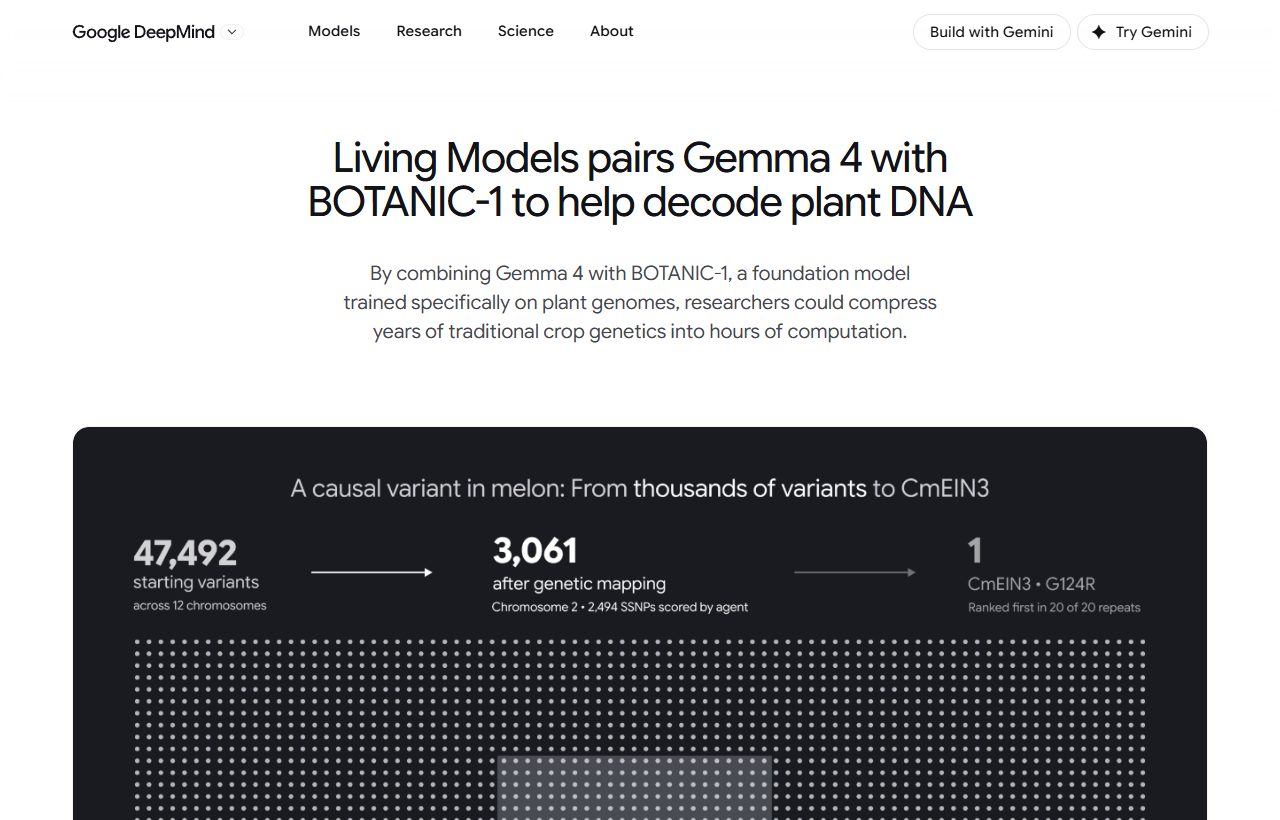
무엇을 시험했나 — 멜론이에요. CmEIN3라는 유전자 안의 DNA 글자 하나가 바뀌면 멜론 꽃이 암꽃에서 양성화(암술과 수술이 함께 있는 꽃)로 바뀌는데, 이것은 프랑스 국립 농업·식품·환경 연구소(INRAE)의 Adnane Boualem 박사 연구진이 이미 실험으로 밝혀 둔 사실이에요. 즉 답을 아는 문제를 AI가 다시 맞히는지 본 거예요. 기존 유전 분석으로는 유전체 전체의 변이 47,492개를 2번 염색체의 후보 3,061개까지 줄일 수 있었지만, 후보들이 한 덩어리로 같이 유전돼 통계만으로는 더 가려낼 수 없었어요.
결과 — Gemma가 후보 3,061개에서 삽입·삭제 같은 변이 567개를 걸러 내고, 남은 글자 하나짜리 변이 2,494개를 BOTANIC-1에 보내 점수를 매겼어요. 원문 표현으로는 정답이 "ranked #1 out of 2,494 candidates without ties"(2,494개 가운데 동점 없이 1위)였어요. 같은 시험을 20번 반복했을 때 정답을 1위로 올린 비율은 0.90(20번 가운데 18번)이에요. 도구 없이 Gemma만 쓰면 0.00, 기존 분석 도구를 쥐여 주면 0.15였어요. 없는 변이를 지어낸 실행은 BOTANIC-1을 쓴 20번 가운데 0번이었어요.
다만 — 멜론의 한 유전자, 한 가지 사례예요. 숫자는 Living Models가 직접 잰 값이고, 논문은 bioRxiv에 올라온 심사 전 원고이며 저자 모두 Living Models 소속이에요. 공식 글 안에서도 숫자가 한 군데 엇갈려요. 본문은 0.90이라고 쓰는데 맨 위 그림에는 '20번 모두 1위'라고 적혀 있어요. 공개된 실행 기록 집계는 20번 가운데 18번이에요.
더 넓은 시험 — 논문에서는 실험으로 확인된 식물 돌연변이 500개 이상으로도 시험했어요. 이쪽은 여러 사례의 비율이에요. 진짜 원인 돌연변이를 후보 상위 0.1% 안에 넣은 경우가 15.9%(유전체 모델이 아닌 방법 가운데 최고는 4.6%), 상위 1% 안에 넣은 경우가 48.8%(기존 분석 방식 33.9%)였어요. 뒤집어 보면 절반가량은 상위 1% 안에 들지 못했다는 뜻이기도 해요.
받는 곳과 라이선스 — BOTANIC-1은 Hugging Face에 S(0.3B)·M(0.7B)·L(2B) 세 크기로 올라와 있어요. 비상업 연구용으로만 쓸 수 있고, 받으려면 약관에 동의해야 해요(동의하면 바로 열리고, Hugging Face 아이디와 이메일이 Living Models에 전달돼요). 조건마다 20번씩 돌린 실행 기록을 단계별로 읽어 볼 수 있는 데모 페이지도 함께 공개됐어요. 데모는 녹화된 기록을 보여 주는 것이라, 열어도 모델이 실제로 돌지는 않아요.
X 게시물 보기 · https://x.com/googlegemma/status/2107848642518454428