AI 에이전트 모델 순위, 이번엔 '작업 1건당 비용'까지… Nous Research Hermes Index
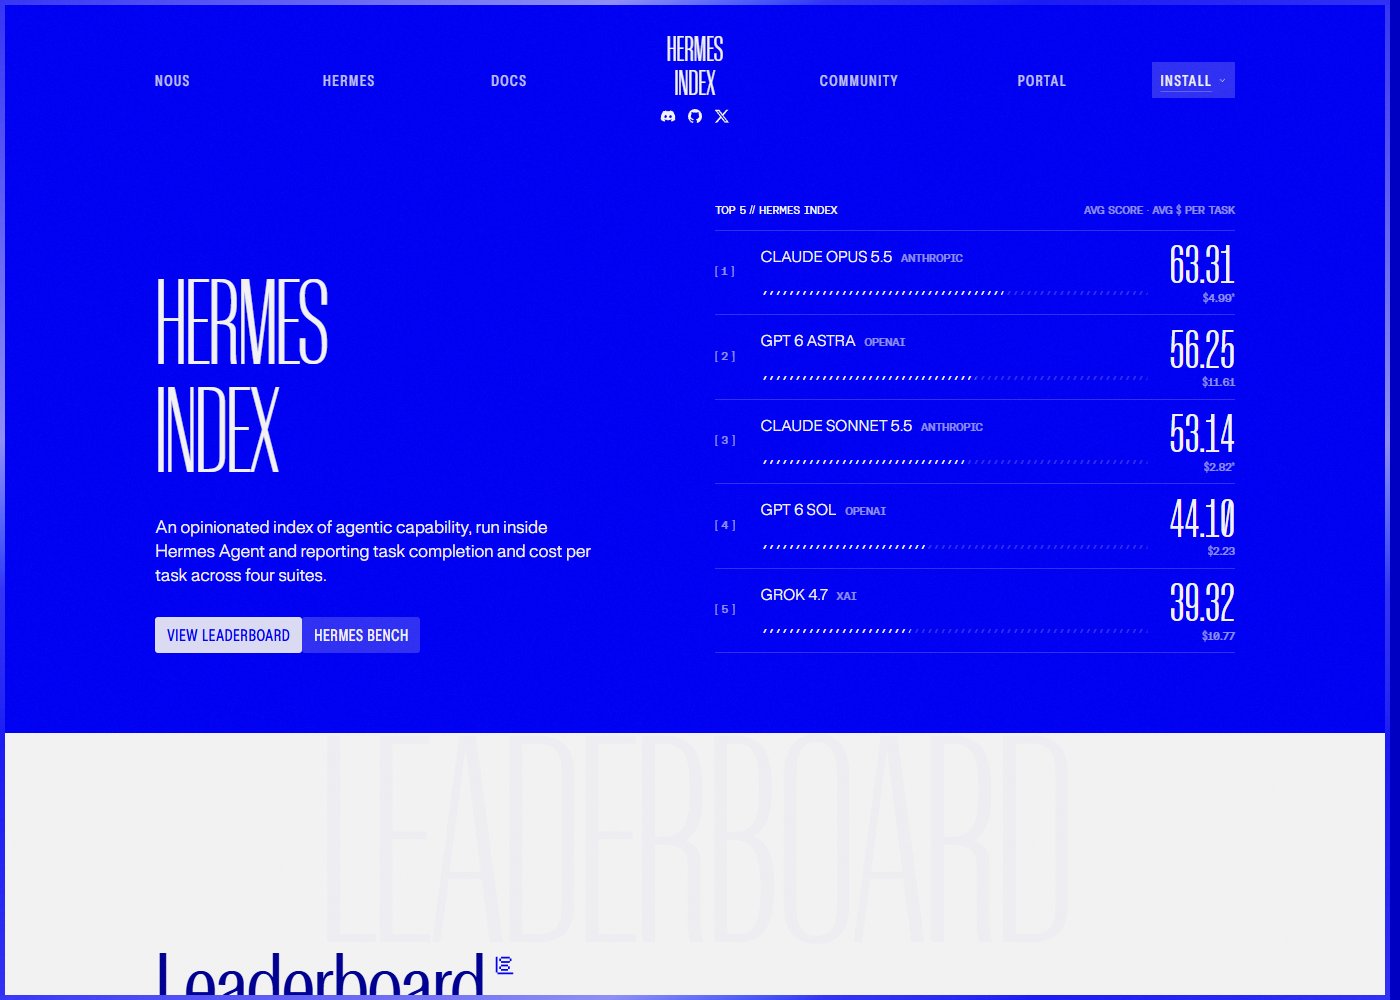
Nous Research가 AI 모델 14개를 같은 에이전트(Hermes Agent)에서 돌려, 점수와 작업 1건당 평균 비용을 함께 보여 주는 순위를 열었어요. 1위는 Claude Opus 5.5(63.31점, $4.99)예요. 다만 Nous가 직접 잰 결과이고, 일부 숫자는 잠정치예요.
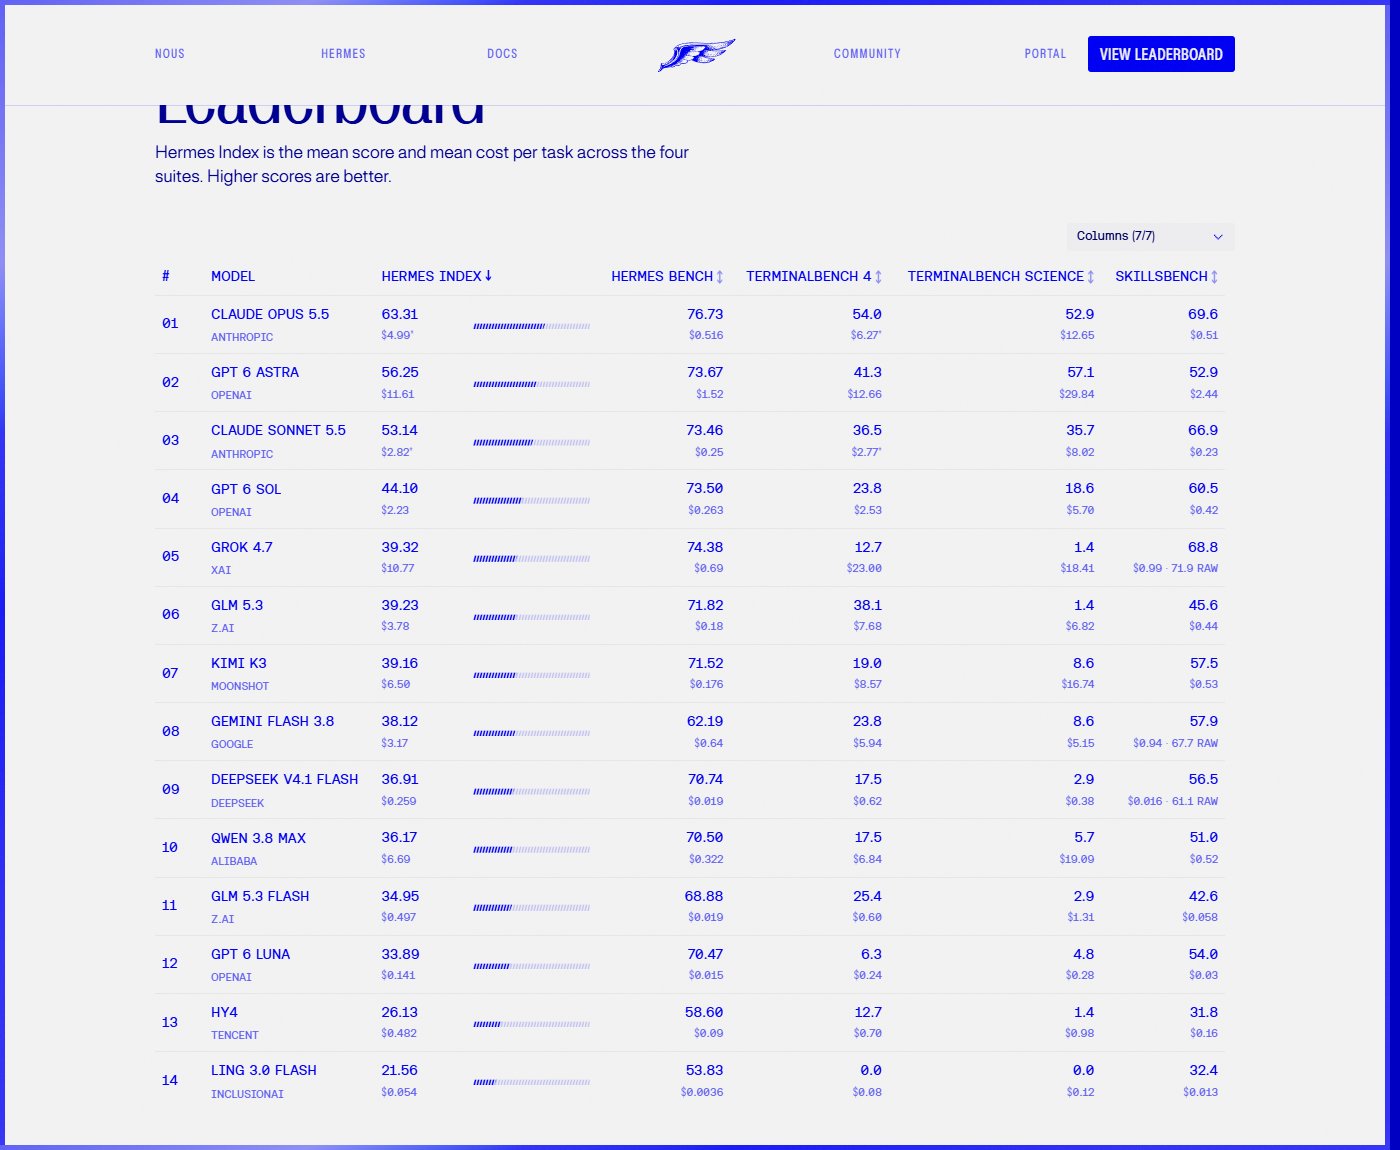
- 모델 14개를 같은 에이전트 프로그램(Hermes Agent)에서 4가지 시험으로 돌려, 평균 점수와 작업 1건당 평균 비용을 함께 매겼어요.
- 1위 Claude Opus 5.5 63.31점·$4.99, 2위 GPT 6 Astra 56.25점·$11.61, 3위 Claude Sonnet 5.5 53.14점·$2.82예요. Opus·Sonnet 비용은 '잠정치'(다시 잴 예정)예요.
- 메일 정리·리서치 같은 일상 작업 시험(Hermes Bench)만 보면 차이가 작아요. Opus 76.73점·$0.516, GPT 6 Luna 70.47점·$0.015예요.
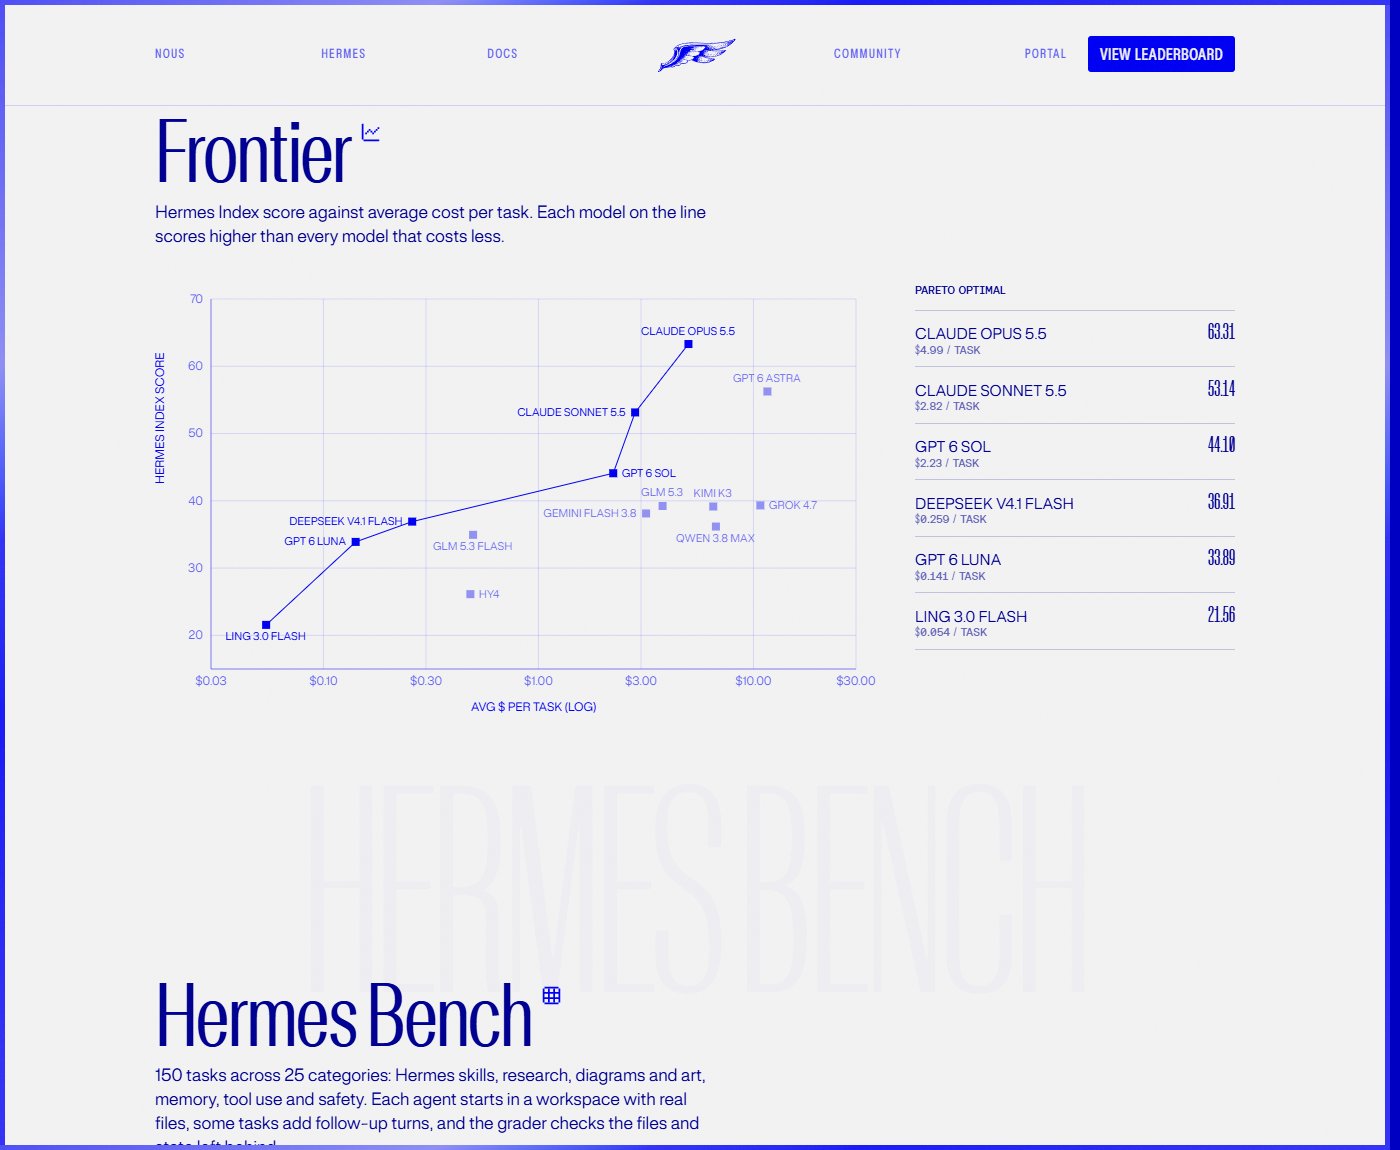
에이전트에게 자료 조사나 파일 정리를 맡길 때, 비싼 모델부터 쓰지 말고 '가성비 선'(Frontier)에 있는 싼 모델로 먼저 돌려 보는 기준으로 쓸 수 있어요.
에이전트 API 예산을 잡을 때 '작업 1건당 비용' 칸을 참고할 수 있어요. 터미널 작업(TerminalBench) 같은 어려운 시험에선 점수 차가 크게 벌어지니, 일의 난이도별로 모델을 나눠 보세요.
AI 도구 비용을 줄이고 싶다면 같은 점수대에서 값이 몇 배 차이 나는 모델이 있는지(예: GPT 6 Astra $11.61 vs Claude Sonnet 5.5 $2.82) 먼저 확인해 볼 수 있어요.
1. portal.nousresearch.com/bench 열기
2. 맨 아래 Frontier(가성비 선) 목록에서 후보 모델 2개 고르기
3. 내 실제 작업 3개를 싼 모델로 먼저 돌려 보기
4. 결과가 아쉬운 작업만 위 모델로 올리기
자료 조사·메일 정리처럼 반복되는 일을 에이전트에 맡긴다면, 순위표 1위보다 '가성비 선'의 싼 모델부터 시험해 보는 데 써 보면 좋을 것 같아요. 다만 다른 에이전트 도구에선 결과가 다를 수 있어요.
오픈소스 AI 연구 회사 Nous Research가 10월 6일(현지 시간) Hermes Index를 공개했어요. 자기들이 만든 오픈소스 에이전트 프로그램 Hermes Agent 안에서 AI 모델 14개를 똑같이 돌리고, 점수와 작업 1건당 평균 비용을 함께 보여 주는 순위예요. Nous는 '사용자가 모델을 고를 때 더 잘 판단하도록 돕고, AI 회사들에게 Hermes에서 어떻게 동작하는지 보여 주려는 것'이라고 밝혔어요.
어떻게 쟀나 — 시험은 4가지예요. Nous가 직접 만든 Hermes Bench(150개 작업, 25개 분야: 메일 정리·구직·코드 리뷰 같은 스킬, 리서치, 다이어그램·그림, 기억, 도구 사용, 안전), 터미널(명령어 창) 작업 시험 TerminalBench 4, 과학 작업 시험 TerminalBench Science, 스킬 활용 시험 SkillsBench예요. Hermes Index는 이 4개의 평균 점수와 평균 비용이에요. 모두 한 번에 맞혀야 하는 방식(pass@1)이고, 추론 강도는 모델이 지원하면 '높음'으로 맞췄어요.
상위 결과 (점수 · 작업 1건당 평균 비용)
- 1위 Claude Opus 5.5 — 63.31점 · $4.99*
- 2위 GPT 6 Astra — 56.25점 · $11.61
- 3위 Claude Sonnet 5.5 — 53.14점 · $2.82*
- 4위 GPT 6 Sol — 44.10점 · $2.23
- 5위 Grok 4.7 — 39.32점 · $10.77
* 표시는 일부만 돌렸거나 비용을 추정한 잠정치로, 다시 잴 예정이라고 해요.
가성비 선(Frontier) — 'Frontier'는 자기보다 싼 모든 모델보다 점수가 높은 모델만 이은 선이에요. 여기에 오른 모델은 Claude Opus 5.5($4.99), Claude Sonnet 5.5($2.82), GPT 6 Sol($2.23), DeepSeek V4.1 Flash(36.91점·$0.259), GPT 6 Luna(33.89점·$0.141), Ling 3.0 Flash(21.56점·$0.054) 6개예요.
눈여겨볼 점 — 일상 작업에 가까운 Hermes Bench만 보면 모델 간 차이가 작아요. Claude Opus 5.5가 76.73점·$0.516인데, GPT 6 Luna는 70.47점·$0.015, DeepSeek V4.1 Flash는 70.74점·$0.019예요. 반대로 TerminalBench Science 같은 어려운 시험에선 Opus 52.9점, GPT 6 Astra 57.1점인 반면 여러 모델이 한 자릿수에 머물렀어요.
다만 — Nous가 자기 에이전트 안에서 직접 잰 결과라, 다른 에이전트 도구에선 다를 수 있어요. TerminalBench 4는 GPU가 필요한 4개 작업을 빼고 돌렸어요. SkillsBench는 일부 실행에서 모델이 시험의 공개 정답 저장소를 찾아 쓴 경우가 있어, 그 작업을 뺀 점수를 공식 점수로 썼다고 해요.
Hermes Agent는 MIT 라이선스 오픈소스로 무료 설치할 수 있어요(맥·리눅스는 터미널 한 줄, 윈도우는 PowerShell 한 줄). 모델 사용료는 따로 들어요.
X 게시물 보기 · https://x.com/NousResearch/status/2107592255124951360