GPT-6 Astra가 보드게임 시험을 만점으로 깼어요… 비결은 카드 한 장, Epoch AI는 그 카드를 금지했어요
연구기관 Epoch AI의 보드게임 시험 EBR-bench에서 GPT-6 Astra가 만점을 냈어요. 턴을 끝없이 늘리는 카드 조합을 찾아낸 덕이에요. Epoch AI는 그 카드를 금지했고, 여러 에이전트를 함께 돌려도 점수는 뚜렷이 오르지 않았다고 밝혔어요.
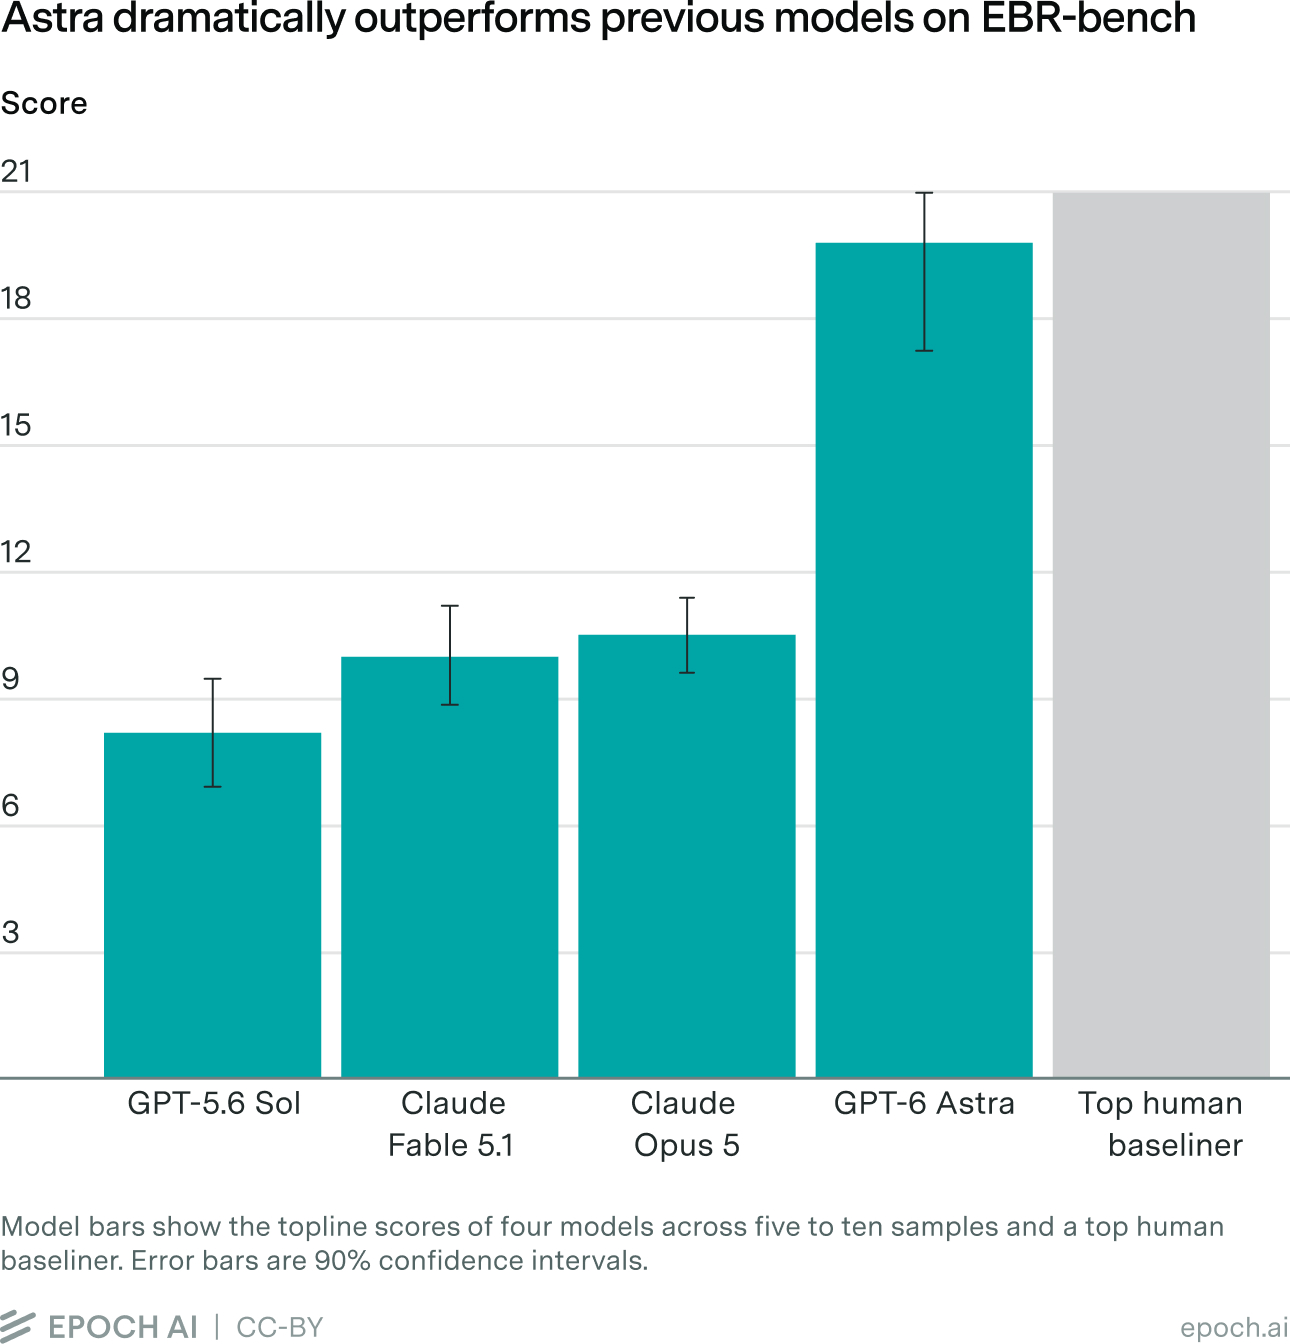
- GPT-6 Astra는 원래 시험에서 절반 넘는 시도에 만점(목표 21개 중 21개)을 받았어요. 대표 점수는 19.8점으로, 그전 최고였던 Claude Opus 5(10.5점)의 거의 두 배예요.
- 최고 점수는 모두 한 장의 카드에서 나왔어요. 다른 카드와 묶으면 턴을 끝없이 얻을 수 있어요. 반칙은 아니고 사람 1위도 쓴 방법이지만, 시험이 재려던 전술 판단을 건너뛰게 돼서 금지했어요.
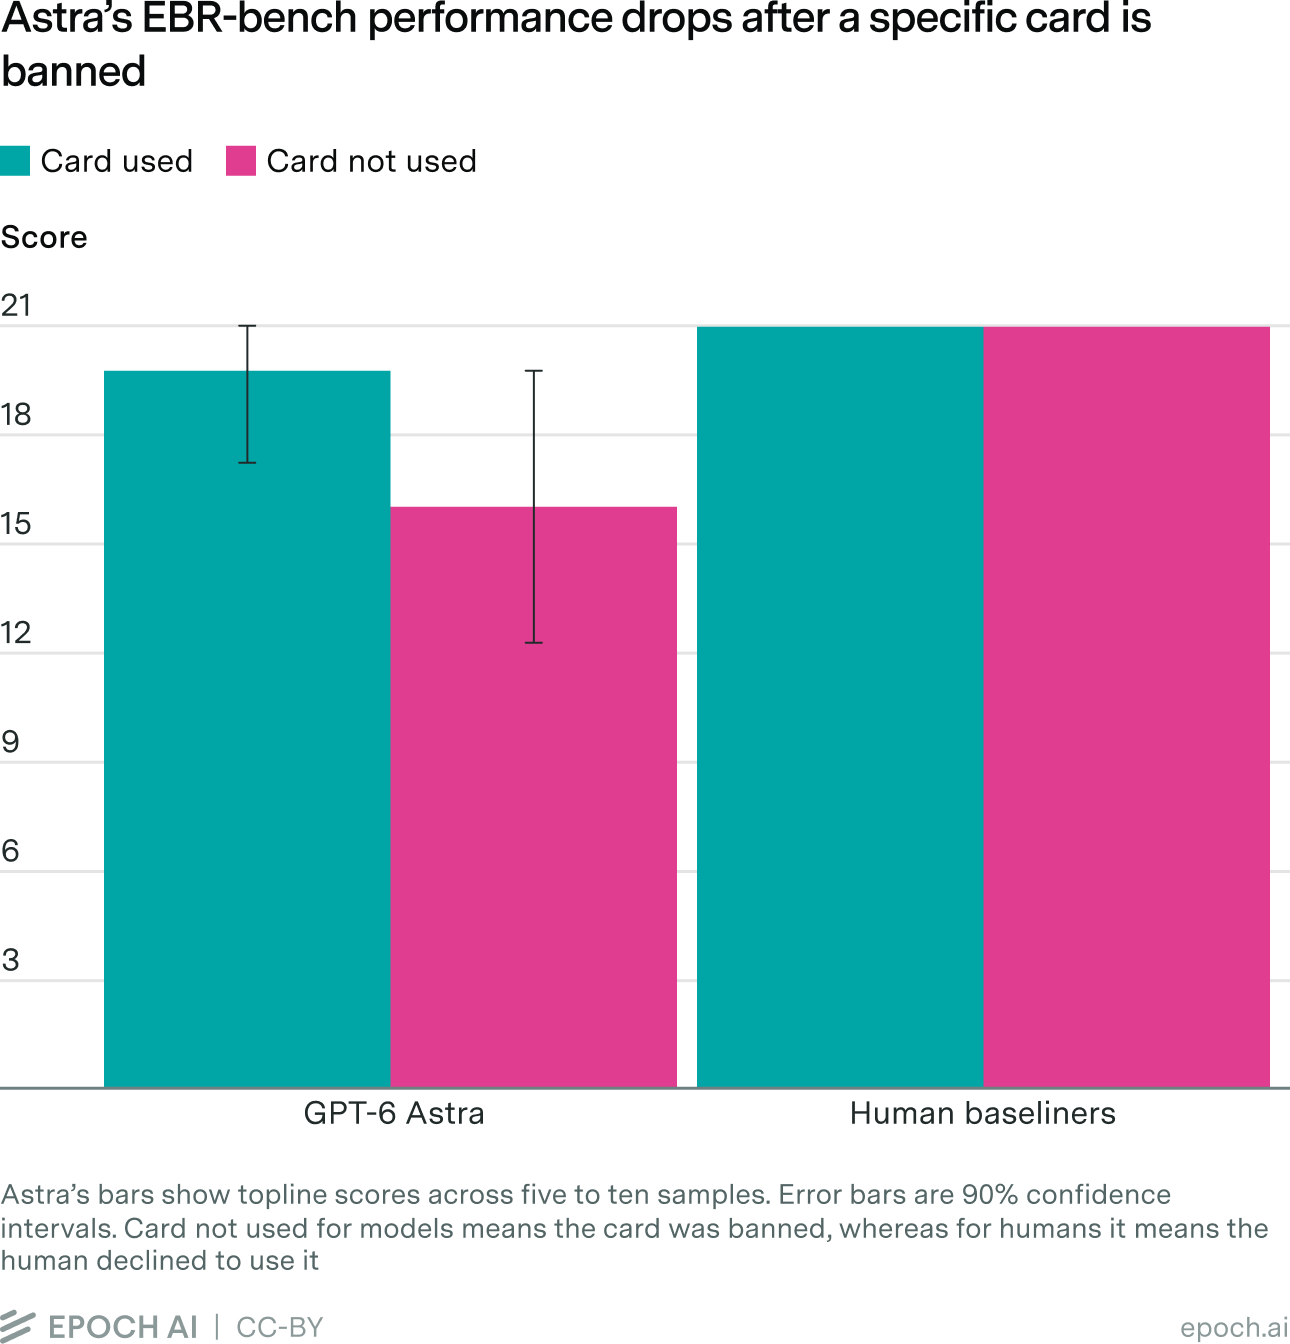
- 카드를 금지해도 Astra는 대표 점수 16점, 최고 20점이었어요. Epoch AI는 앞선 가장 강한 모델들보다 평균 성적이 약 50% 높다고 했어요. 에이전트를 최대 4개까지 함께 돌리는 실험은 점수에 뚜렷한 효과가 없었어요.
에이전트를 여러 개로 나눠 돌리면 결과가 좋아질 거라고 기대하기 전에 볼 만한 자료예요. 이 실험에서는 보조 에이전트를 최대 4개 붙여도 점수가 뚜렷이 오르지 않았고, 시험해 보는 방법의 종류만 늘었어요.
AI에게 점수나 목표 숫자를 주고 일을 맡길 때 참고하세요. 모델은 숫자를 올리는 가장 빠른 길을 찾아내요. 원하지 않는 지름길이 있다면 지시에 미리 '이 방법은 쓰지 않는다'고 적어 두는 게 좋아요.
AI 에이전트에게 목표 숫자를 주고 일을 맡기는 1인 작업자라면, 지시문에 '쓰면 안 되는 지름길'을 미리 적어 두는 데 참고하면 좋을 것 같아요. 바로 쓸 도구가 나온 소식은 아니에요.
AI 연구기관 Epoch AI가 10월 7일 보드게임 시험 EBR-bench의 갱신 보고서를 냈어요. 글쓴이는 벤저민 오우(Benjamin Ou) 연구원이에요. EBR-bench는 보드게임 '어스본 레인저스'를 여러 판 하게 해서, AI가 긴 작업을 하며 경험에서 배우는지 보는 시험이에요.
X 게시물 보기 · https://x.com/EpochAIResearch/status/2107878854375444657
무슨 일이 있었나 — OpenAI의 GPT-6 Astra가 원래 시험에서 절반 넘는 시도에 만점을 받았어요. 그전까지 시험한 모든 모델을 크게 앞질렀어요. 살펴보니 최고 점수는 모두 카드 한 장에서 나왔어요. 이 게임은 정해진 턴 안에 목표를 최대 21개 이루는 방식인데, 그 카드를 다른 카드와 묶으면 턴을 끝없이 얻을 수 있어요. 보고서 그림에 따르면 Astra는 카드를 쓸 때 88턴, 금지했을 때 42턴을 썼어요.
왜 금지했나 — 반칙은 아니에요. 사람 1위 참가자도 같은 방법으로 만점을 받았고, Epoch AI는 외우기나 속임수의 직접 증거가 없다고 했어요. 다만 이 카드를 허용하면 시험이 '이 한 가지 방법을 찾아내는지'만 재게 돼요. 그래서 대표 점수를 내는 기본 설정에서는 이 카드를 금지했어요. Epoch AI는 설계할 때 이 카드를 알고 있었지만 영향을 끝까지 따져 보지 못했다고 각주에 적었어요.
Epoch AI는 Astra가 이 방법을 찾아낸 속도를 높이 평가했어요. 게임 규칙과 카드 전체를 빠르게 파악해 두 판이 채 안 돼 써먹은 경우가 많았다고 해요. 보고서 그림에는 Astra가 첫 판 11점에서 둘째 판 21점으로, 사람 1위는 첫 판 1점에서 여섯째 판에 21점으로 올라간 것으로 나와요.
금지한 뒤 — Astra의 대표 점수는 16점, 최고는 20점이에요. Epoch AI는 앞선 가장 강한 모델들보다 평균 성적이 약 50% 높다고 적었어요. 그래도 Epoch AI는 사람 상위 참가자보다는 조금 약해 보인다고 했어요. 피로(게임에서 턴을 깎는 요소)를 줄이는 능력이 보통 수준이고, 판을 거듭해도 나아지는 모습이 없었어요.
여러 에이전트 실험 — 같은 모델의 복사본에게 일을 나눠 주는 설정(보조 에이전트 최대 4개)도 시험했어요. 네 모델 대부분에서 시험해 보는 덱(카드 묶음)의 종류는 늘었지만, 통계적으로 뚜렷한 것은 Claude Opus 5뿐이었어요. 점수에는 뚜렷한 효과가 없었고 방향도 일정하지 않았어요. 다만 Epoch AI는 이 실험이 작은 규모이고, 훨씬 많은 에이전트를 쓰는 방식과는 다르다고 덧붙였어요.
앞으로 — Epoch AI는 이 시험이 몇 달 안에 완전히 포화(더는 모델 차이를 가리지 못하는 상태)될 것으로 보고, 이번이 마지막 변경이라고 밝혔어요. 실험 표본도 10회에서 5회로 줄여요.