OpenAI, 내부 AI가 쓴 수학 원고 722편을 GitHub에 공개… 모델은 아직 비공개
아직 출시하지 않은 OpenAI 내부 모델이 미해결 연구 문제를 풀며 쓴 원고 722편(372개 묶음)이 공개됐어요. 결과 하나에 평균 'ChatGPT Pro 생각 3시간' 분량의 계산을 썼어요.
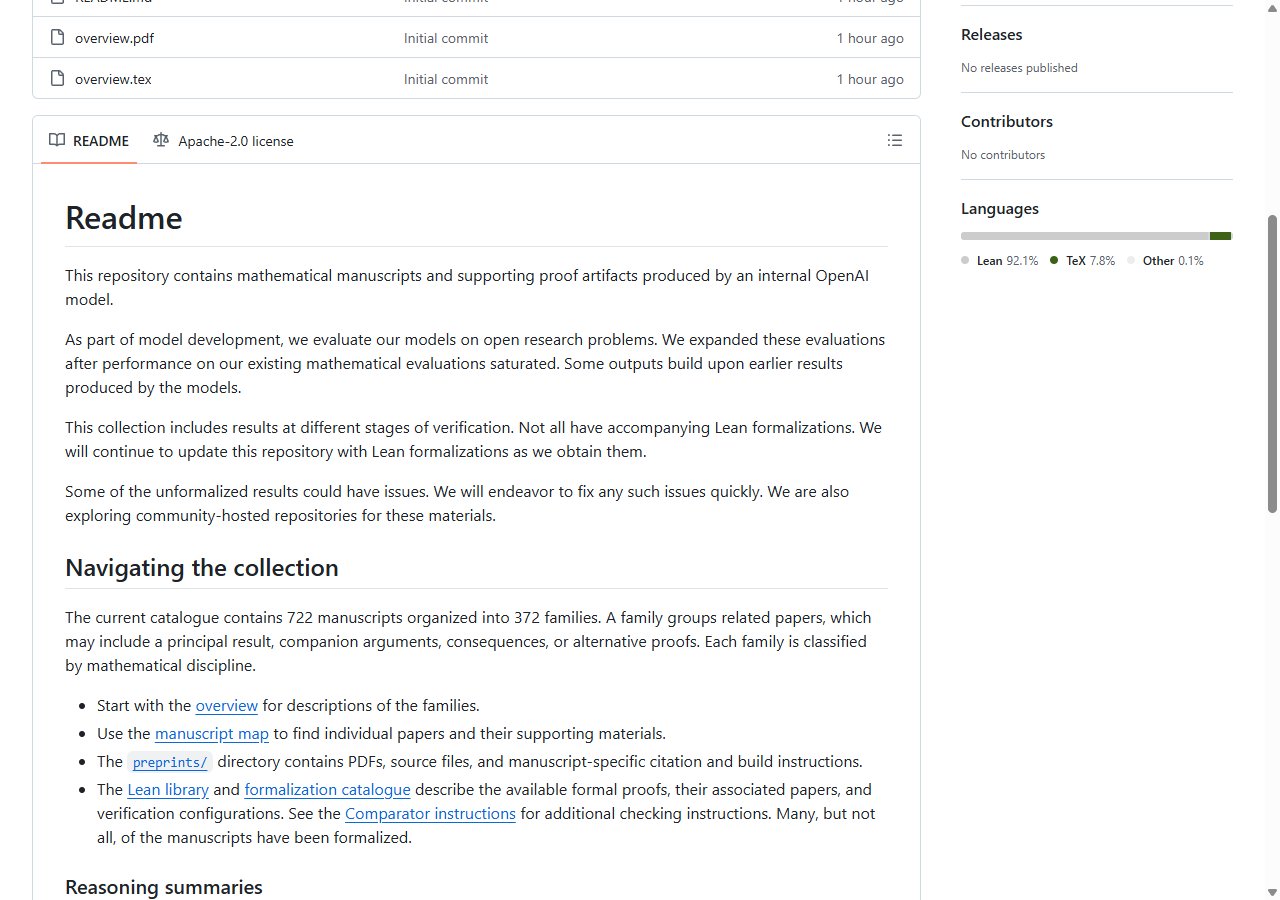
- OpenAI가 출시 전 내부 모델이 만든 수학 원고 722편(372개 묶음)과 증명 자료를 GitHub 저장소 openai/math에 Apache-2.0으로 공개했어요.
- 모델에게 약 4,000개 문제를 냈고, 결과 하나에 평균 ChatGPT Pro 생각 모드 약 3시간 분량의 계산이 들었다고 밝혔어요.
- 많은 증명을 Lean(컴퓨터가 증명을 검사하는 언어)으로 옮겼지만 전부는 아니에요. OpenAI 스스로 '형식화하지 않은 결과엔 문제가 있을 수 있다'고 적었어요.
관심 분야 원고를 overview.pdf에서 찾아 읽고, Lean 증명이 붙은 결과는 직접 돌려 검사해 볼 수 있어요. 모델 생각 요약 10개는 '어려운 문제를 AI가 어떤 순서로 파고드는지' 보는 자료로 좋아요.
"AI가 수학 난제를 풀었다"는 제목 대신 '722편 중 검증이 끝난 것과 아닌 것'을 나눠 설명하는 해설 콘텐츠 소재로 쓸 만해요.
지금 당장 쓸 수 있는 도구는 없어요. 다만 결과를 낼 때 '검증 단계·계산량·실패 포함 시도 수'를 함께 밝히는 방식은 AI로 만든 보고서에 그대로 가져다 쓸 수 있어요.
1. github.com/openai/math 에서 overview.pdf를 열어 분야별 묶음 목록을 훑어요.
2. CONTENTS.md(원고 지도)에서 관심 있는 결과의 요약과 PDF를 찾아요.
3. reasoning_traces 폴더의 생각 요약 하나를 골라 AI가 접근한 순서를 읽어 봐요.
4. lean/formalization.yaml에서 그 결과에 Lean 증명이 있는지 확인해요. 없으면 '검증 전'으로 봐요.
AI가 만든 결과를 소개할 때 '검증된 것 / 아직 검증 전인 것'을 나눠 보여 주는 이 방식은, AI로 조사한 내용을 글이나 영상으로 정리하는 크리에이터에게도 좋은 기준이 될 것 같아요. 모델 자체는 출시 소식이 나오면 그때 다시 보는 게 좋을 것 같아요.
무슨 일이야?
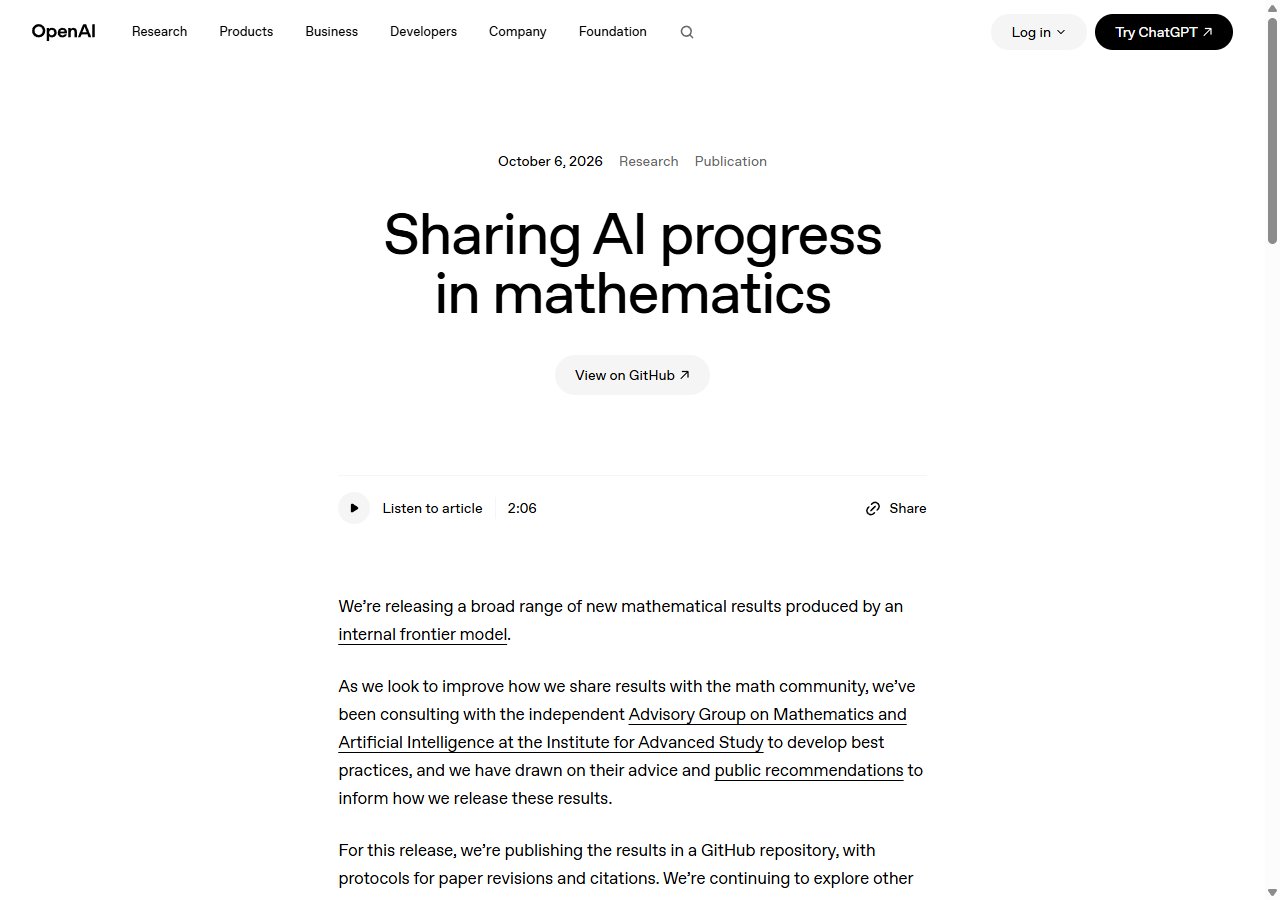
OpenAI가 10월 6일(현지 시간) 내부 프런티어 모델(아직 출시하지 않은 가장 앞선 모델)이 만든 수학 연구 결과를 한꺼번에 공개했어요. 결과는 논문 사이트가 아니라 GitHub 저장소 openai/math에 올렸고, 라이선스는 Apache-2.0이에요.
OpenAI는 기존 수학 평가에서 점수가 꽉 차서(포화), 아직 답이 없는 실제 연구 문제로 평가를 넓혔다고 설명했어요. 공개 방식은 미국 고등연구소(IAS)의 독립 자문 그룹 '수학과 AI 자문 그룹'의 권고를 참고했다고 해요.
X 게시물 보기 · https://x.com/OpenAI/status/2107596713791767021
무엇이 들어 있나
- 원고 722편, 372개 묶음 — 묶음(패밀리)은 핵심 결과 하나와 딸린 논증·따름 결과·다른 증명을 모은 단위예요. 분야별로 나뉘어 있어요.
- Lean 증명 — Lean은 컴퓨터가 증명이 맞는지 하나하나 검사하는 언어예요. 많은 원고에 붙어 있지만 전부는 아니고, 앞으로 더 채우겠다고 했어요.
- 모델 생각 요약 10개 — π의 무리수 지수, 캐플런스키 추측(표수 2), 자유군 인자의 동형 문제 등 10개 결과에 대해 모델이 어떻게 생각했는지 줄인 요약이에요.
- 계산량과 시도 수 — 모델에게 약 4,000개 문제를 냈고, 결과 하나에 평균 ChatGPT Pro 생각 약 3시간 분량의 계산이 들었어요. 이 중 의미 있는 수준의 결과만 묶어 목록을 만들었어요.
조심해서 볼 점
- OpenAI는 저장소에 "결과마다 검증 단계가 다르고, 형식화(Lean 증명)하지 않은 결과에는 문제가 있을 수 있다"고 직접 적었어요. 고칠 땐 새 버전으로 남기고 이전 버전도 볼 수 있게 한대요.
- 대부분은 같은 절차로 만들었지만, 리만 제타 함수의 영점 없는 영역과 CM 아벨 다양체의 호지 추측 증명은 예외라고 밝혔어요. 리만 제타 쪽 원고 하나는 사람이 읽기 쉽게 다듬었어요.
- 모델 이름·성능 비교는 이번 발표에 없어요. 발표 글의 '내부 프런티어 모델' 링크는 9월 8일 나비에–스토크스 발표로 이어지는데, 그 글에선 "GPT-6 Astra보다 성능이 크게 뛰어난 내부 모델"을 썼다고 했어요.
앞으로
OpenAI는 이 결과를 만든 모델을 책임 있게 공개하는 방법을 준비 중이라고 했고, AI가 낸 주요 결과를 이해하기 위한 워크숍·학회·특별 프로그램을 지원하겠다고 밝혔어요. 구체적인 출시 일정은 없어요.