Meta, 816B 오픈 웨이트 모델 Muse Spark Open 공개 — 42B 활성 파라미터, Mac Studio 두 대로 돌린다
Meta가 816B(활성 42B) MoE 구조의 멀티모달(텍스트·이미지·영상·오디오 입력) 오픈 웨이트 모델 Muse Spark Open을 공개했어요. 코딩·에이전트 작업에 맞춰 설계했고, Apple M5 Ultra Mac Studio 두 대에서 로컬로 돌릴 수 있다고 해요.
- Muse Spark Open은 816B 전체·42B 활성 파라미터의 MoE(혼합 전문가) 구조 멀티모달 모델이에요(입력: 텍스트·이미지·영상·오디오, 출력: 텍스트). 문맥 창은 100만 토큰이고, 코딩과 에이전트 작업에 맞춰 만들었다고 해요.
- Apple M5 Ultra Mac Studio 두 대(각 512GB 통합 메모리, 1.2TB/s 대역폭)로 로컬 실행이 가능해요. MLX 프레임워크를 쓰고, BF16과 NVFP4 가중치를 제공해요.
- 라이선스는 Muse Model License예요. 회사(계열사 포함) 12개월 매출이 2,000만 달러를 넘으면서 '모델을 서비스로(MaaS)' 제공할 경우 Meta에 별도 통보·계약이 필요해요. 상업적 사용 자체는 무료예요.
SGLang·vLLM으로 서버를 띄워 에이전트 백엔드로 쓸 수 있어요. SGLang에 들어간 Helion 커널이 NVIDIA·AMD GPU에서 1.03~3.95배 커널 속도를 낸다고 해요.
이미지·영상·오디오와 텍스트를 함께 넣는 멀티모달 작업(제품 사진 설명, 시안 피드백)에 API로 바로 써 볼 수 있어요. Together AI·Fireworks·Groq 등에서 호스팅돼요.
M5 Ultra Mac Studio를 갖고 있다면 인터넷 없이 로컬에서 100만 토큰 문맥 모델을 돌릴 수 있어요. 민감한 데이터를 외부에 보내지 않아도 돼요.
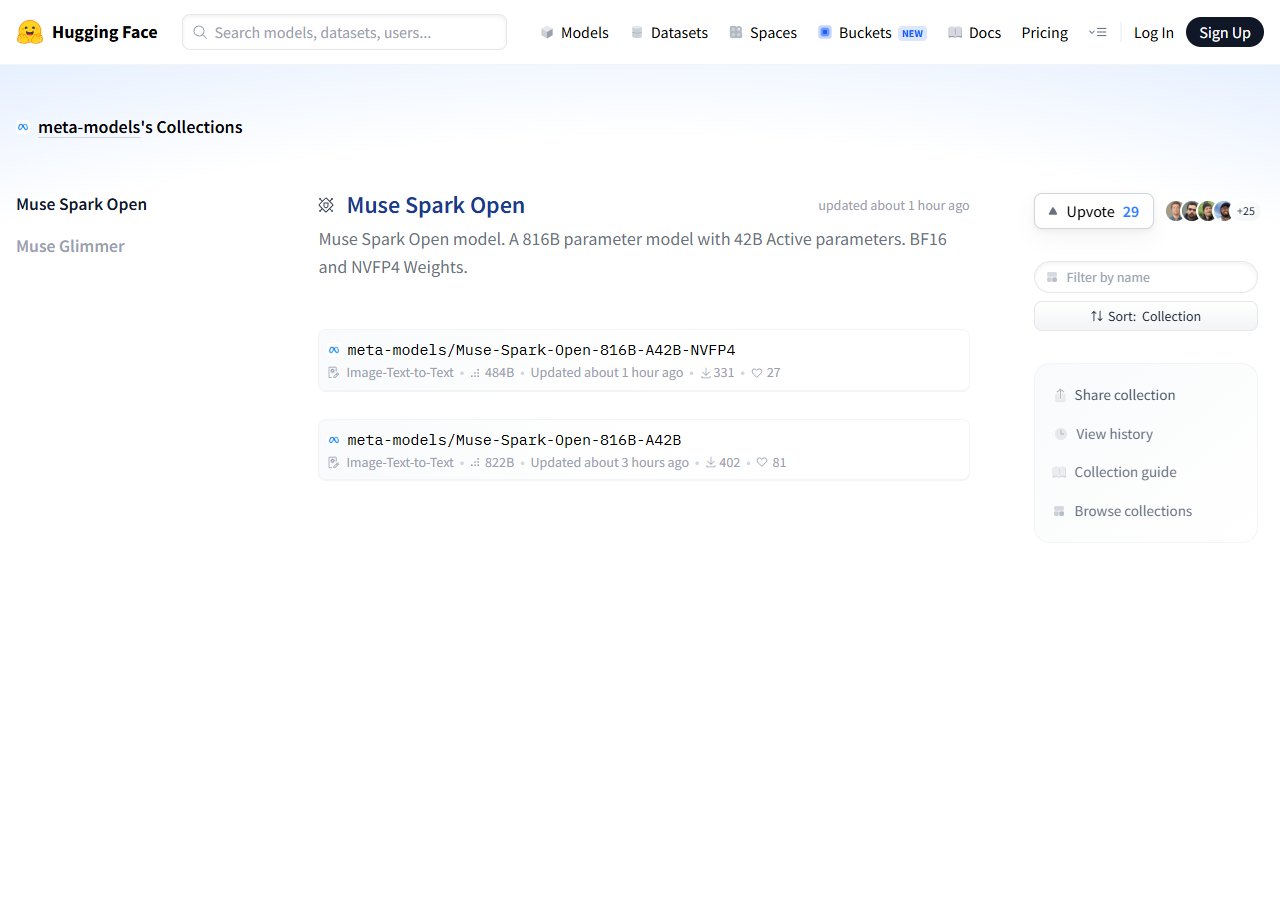
1. huggingface.co/collections/meta-models/muse-spark-open 에서 가중치 접근을 신청해요(수동 승인).
2. API로 먼저 써 보려면 Together AI·Fireworks·Groq 등 호스팅 파트너에서 Muse Spark Open을 찾아요.
3. 로컬 실행은 Mac이면 블로그의 MLX Adapter 안내를, GPU 서버면 모델 카드의 SGLang·vLLM 안내를 따라요.
4. 라이선스를 확인해요 — 12개월 매출 $20M을 넘는 회사가 MaaS로 제공하려면 Meta에 통보·별도 계약이 필요해요.
100만 토큰 문맥의 멀티모달 모델이 오픈 웨이트로 풀렸으니, 긴 문서와 이미지를 함께 넣는 워크플로에 API로 시험해 보면 좋을 것 같아요.
Meta가 10월 15일(미국 시간) Muse Spark Open의 가중치를 공개했어요. 공식 블로그에서 '현재까지 가장 성능이 높은 미국 오픈 웨이트 모델(the Most Capable US Open-Weight Model to Date)'이라고 소개했어요.
모델 구조
전체 816B, 활성 42B 파라미터의 MoE(Mixture of Experts, 혼합 전문가) 구조예요. MoE는 입력마다 전문가 일부만 골라 쓰는 방식이라 전체 크기에 비해 실제 계산량이 적어요. 문맥 창은 100만 토큰이고, 텍스트·이미지·영상·오디오를 입력으로 받는 멀티모달 모델이에요(출력은 텍스트).
Meta는 이 모델을 '코딩과 에이전트 작업에 맞춰 만들었고, 장기 작업·복잡한 소프트웨어 엔지니어링·다단계 추론에 뛰어나다'고 설명했어요. 실제로 오픈소스 Mastodon 클라이언트 Ice Cubes에 iOS 버그 수정·기능 추가·빌드를 하고, DaVinci Resolve에서 영상 편집까지 모델이 직접 한 사례를 블로그에 소개했어요.
로컬 실행: Mac Studio 두 대
Apple M5 Ultra Mac Studio 두 대로 로컬 실행이 가능하다고 해요. M5 Ultra 한 대가 통합 메모리 최대 512GB, 메모리 대역폭 1.2TB/s를 제공하므로 두 대를 합치면 1TB 통합 메모리처럼 동작한다는 설명이에요. MLX 프레임워크를 씁니다.
가중치는 BF16(Hugging Face 표기 822B)과 NVFP4(같은 표기 484B, 4비트 양자화) 두 버전으로 Hugging Face에 올라 있어요. 접근은 수동 승인(gated) 방식이에요.
API·추론 엔진
호스팅 API는 Baseten, Fireworks AI, Groq, Modal, Nebius, OpenRouter, Together AI에서 제공해요. 가중치 다운로드는 Amazon SageMaker AI, Google Cloud Model Garden, Hugging Face, Microsoft Foundry Models에서 가능해요.
추론 엔진은 SGLang, vLLM, TensorRT-LLM, Hugging Face Transformers, Apple MLX, llama.cpp, Unsloth을 지원하고, AMD·Apple·Intel·NVIDIA 칩에 최적화돼 있어요. SGLang에는 자체 Helion GPU 커널이 들어가서 NVIDIA·AMD GPU에서 1.03~3.95배 커널 수준 속도 향상, AMD MI350에서 3% 전체(end-to-end) 속도 향상을 낸다고 해요.
라이선스
Muse Model License를 씁니다. 상업 사용은 무료지만 두 가지 조건이 있어요. 모델을 쓴 서비스에 'Built with Muse Spark Open' 표시가 필요하고, 모델을 API로 제공하는 MaaS(Model as a Service)를 하는 회사(계열사 포함)의 12개월 매출이 2,000만 달러를 넘으면 Meta에 통보·별도 계약을 해야 해요. 내부 사용이나 자체 제품 기능에 모델을 쓰는 건 이 조건에 해당하지 않아요.