코딩 에이전트 순위 v2.0 — 'Claude Code + Opus 5.5(max)'가 62점으로 1위
Artificial Analysis가 코딩 에이전트 종합 점수(Coding Agent Index)를 10월 v2.0으로 바꿨어요. 시험 하나를 Cognition의 FrontierCode로 갈아 끼우고 Q&A 채점을 손봤는데, 새 점수표 맨 위는 Claude Code로 돌린 Opus 5.5(max)예요.
- Artificial Analysis Coding Agent Index v2.0(2026년 10월~)은 FrontierCode v1.1(100문제) · Terminal-Bench 4.0(66문제) · SWE-Atlas-QnA-AA(124문제)를 같은 비중으로 평균 낸 점수예요.
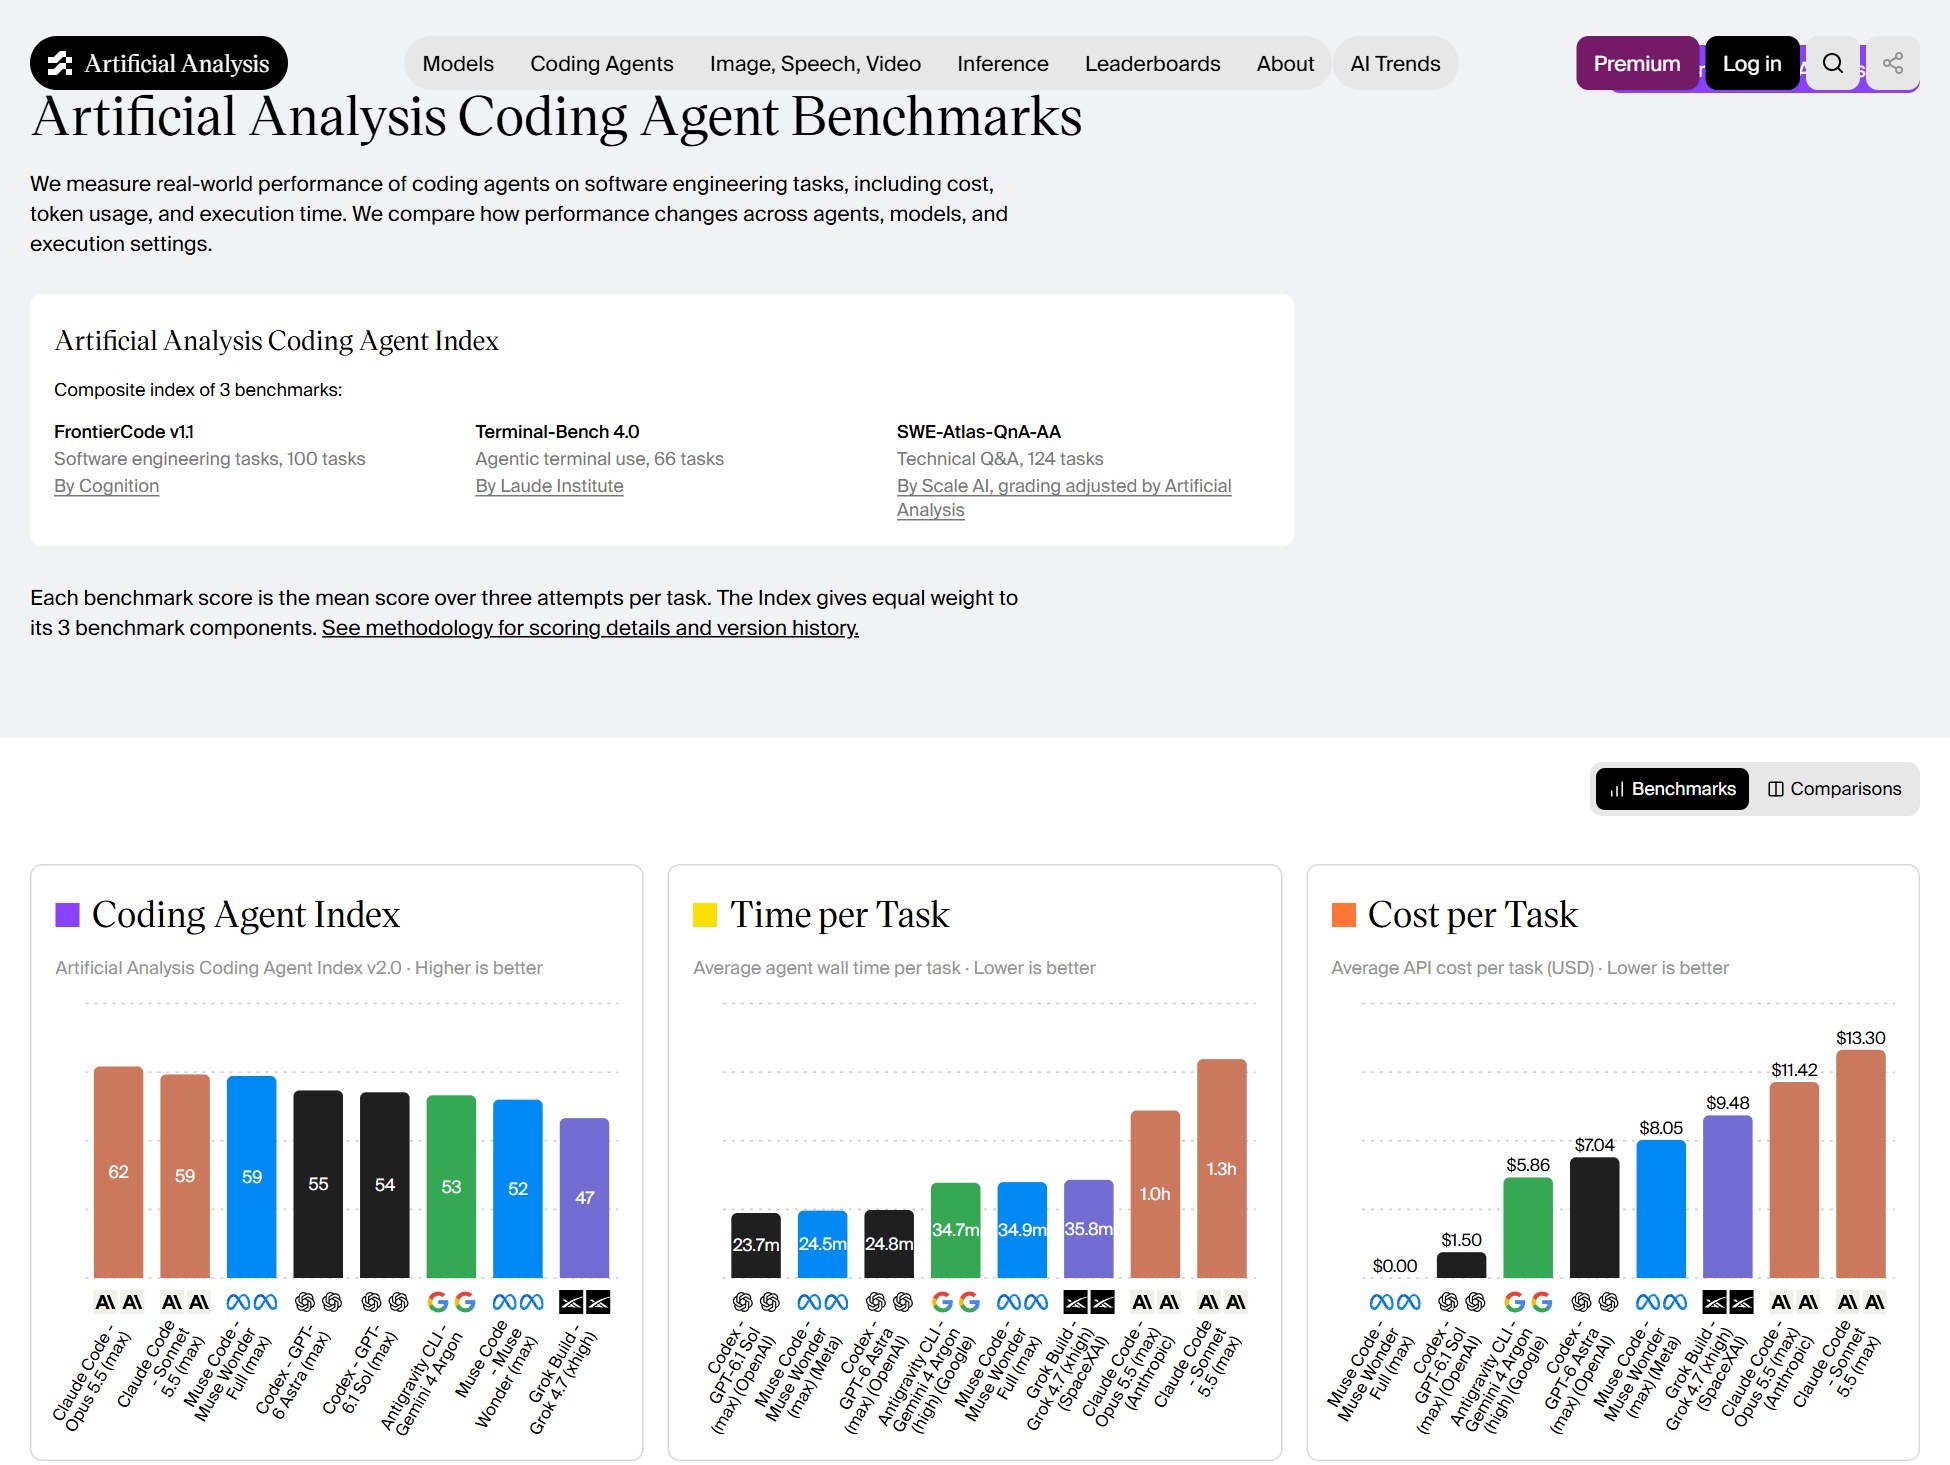
- 10월 23일 화면 기준 1위는 Claude Code - Opus 5.5(max) 62점, 다음은 Claude Code - Sonnet 5.5(max) · Muse Code - Muse Wonder Full(max) 59점, Codex - GPT-6 Astra(max) 55점이에요.
- 대신 1위는 비싸고 느려요. 같은 화면에서 Opus 5.5(max)는 과제 하나에 평균 1.0시간 · API 비용 $11.42로, 비교된 8개 중 두 번째로 길고 두 번째로 비싸요.
Claude Code · Codex · Antigravity CLI 중 무엇을 쓸지 고를 때, 종합 점수만 보지 말고 '과제당 시간 · 비용' 표와 시험별 점수를 같이 보세요. 1위 Opus 5.5(max)는 과제당 1.0시간 · $11.42, Codex - GPT-6.1 Sol(max)은 54점에 23.7분 · $1.50이에요.
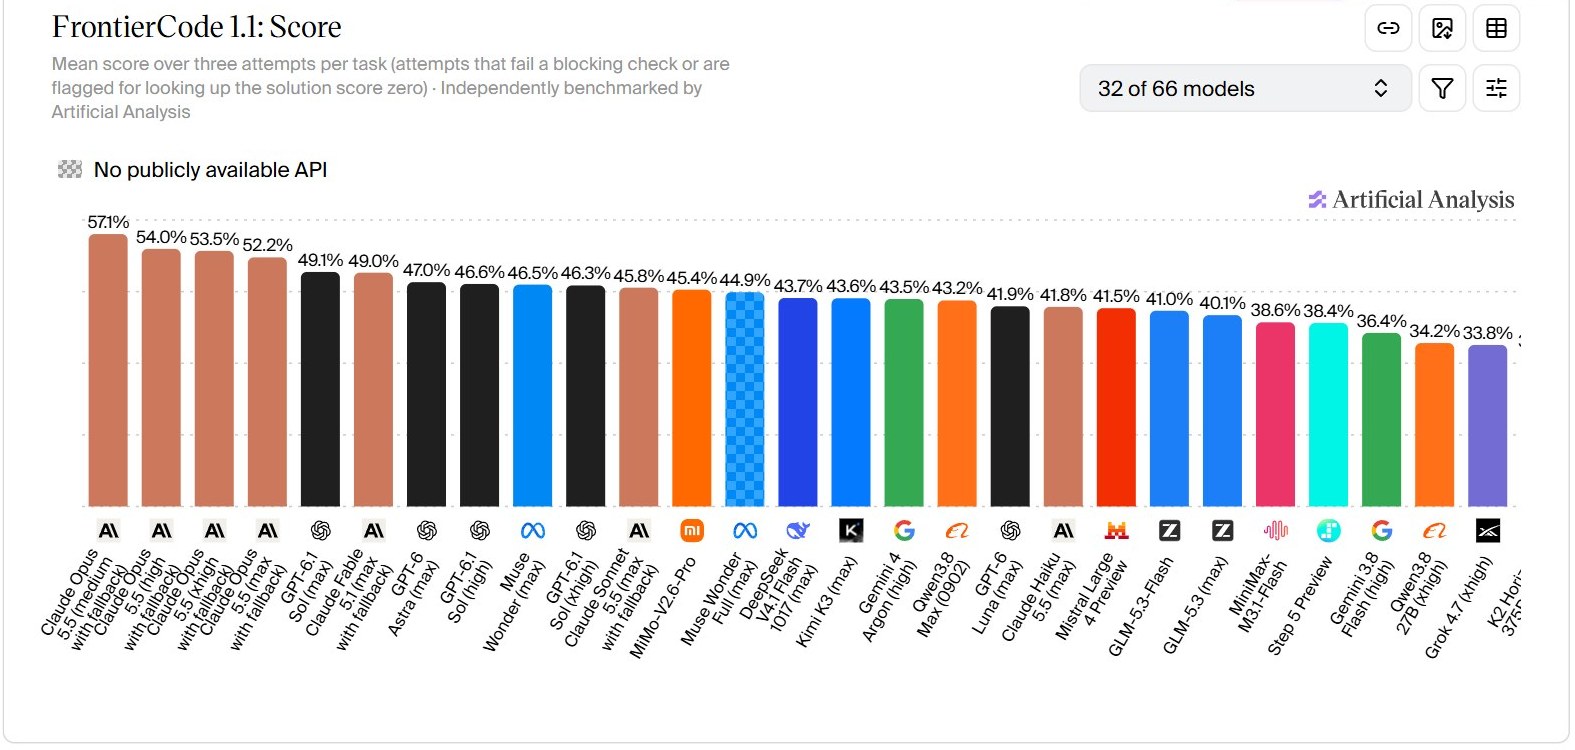
코딩 에이전트로 랜딩 페이지나 작은 자동화 도구를 만든다면, 비싼 최고 설정이 늘 필요한 건 아니에요. FrontierCode 단독 점수에서는 Opus 5.5 Medium(57.1%)이 Max보다 위였어요.
API 요금으로 에이전트를 돌린다면 '과제 하나에 얼마'가 이 표의 실용 숫자예요. 다만 원문도 구독 요금제로 쓰는 사람이 많다고 적었으니, 내 요금제 기준으로 다시 따져 보세요.

코딩 에이전트 구독을 바꿀까 고민 중이라면, 이 표의 '과제당 시간 · 비용'을 내가 자주 맡기는 작업 길이와 나란히 놓고 비교해 보면 좋을 것 같아요.
AI 모델 성능을 따로 재서 공개하는 Artificial Analysis가 코딩 에이전트(코드를 스스로 읽고 고치고 실행하는 AI 도구) 종합 점수 Coding Agent Index를 v2.0으로 바꿨어요. 방법 설명 페이지의 버전 기록에는 v2.0이 '2026년 10월 – 현재'로 적혀 있어요.
무엇이 바뀌었나
버전 기록에 적힌 v2.0 변경점은 두 가지예요.
- DeepSWE v1.1을 빼고 Cognition의 FrontierCode v1.1을 넣었어요. 실제 오픈소스 저장소를 고치는 100문제이고, '관리자가 이 변경을 받아 줄(merge) 만한가'로 채점해요.
- Scale AI의 SWE-Atlas-QnA를 SWE-Atlas-QnA-AA로 이름을 바꾸고 채점을 손봤어요. 채점 기준 1,306개 중 127개를 다시 쓰고, GPT-6 Luna(xhigh)가 기준마다 다섯 번 투표해 판정해요. 데이터와 채점 설정은 Hugging Face에 공개했어요.
세 번째 시험 Terminal-Bench 4.0(터미널에서 여러 단계 작업을 끝내는 66문제)은 지난 v1.5(9월)에 들어온 그대로예요. 세 시험 모두 과제마다 세 번씩 풀린 평균이고, 종합 점수는 세 시험을 같은 비중으로 평균 내요.
FrontierCode는 어떻게 채점하나
FrontierCode v1.1은 전체 150문제 중 100문제(Main)를 쓰고, 문제는 공개하지 않아요(답을 미리 학습하는 걸 막으려고). 꼭 통과해야 하는 검사를 하나라도 놓치면 0점, 다 통과하면 나머지 검사에 따라 70~100%를 받아요. 에이전트가 인터넷에서 원래 정답(원본 풀 리퀘스트 등)을 찾아본 흔적이 있으면 그 시도도 0점이에요. Artificial Analysis는 자체 에이전트 틀(Stirrup)로 과제마다 최대 250턴까지 돌렸어요.
새 점수표 (10월 23일 화면 기준)
코딩 에이전트 페이지 맨 위 표에서 v2.0 점수는 이렇게 나와요. 이름은 '에이전트 - 모델(설정)'이에요.
- Claude Code - Opus 5.5(max): 62
- Claude Code - Sonnet 5.5(max): 59
- Muse Code - Muse Wonder Full(max): 59
- Codex - GPT-6 Astra(max): 55
- Codex - GPT-6.1 Sol(max): 54
- Antigravity CLI - Gemini 4 Argon: 53
- Muse Code - Muse Wonder(max): 52
- Grok Build - Grok 4.7(xhigh): 47
같은 화면의 과제당 평균 시간 · API 비용을 보면 1위 Opus 5.5(max)는 1.0시간 · $11.42, Sonnet 5.5(max)는 1.3시간 · $13.30으로, 이 표에 나온 8개 중 가장 길고 비쌌어요. 가장 짧은 건 Codex - GPT-6.1 Sol(max) 23.7분 · $1.50이었어요. 이 비용은 토큰당 API 요금으로 계산한 값이고, 원문은 많은 사람이 구독 요금제로 쓴다는 점도 함께 적었어요.
FrontierCode만 따로 보면
FrontierCode 1.1 단독 순위에서는 모델 설정 순서가 달라요. Claude Opus 5.5(Medium, Default Fallback)가 57.1%로 가장 높고, 같은 모델의 High 54.0% · Xhigh 53.5%가 뒤를 이었어요. 같은 모델의 Max 설정은 52.2%였어요. 설정을 높인다고 이 시험 점수가 꼭 오르지는 않았어요.
원문은 종합 점수가 비슷해도 저장소 수정 · 터미널 작업 · 코드 이해 Q&A 중 잘하는 쪽이 다를 수 있으니, 시험별 점수를 함께 보라고 적었어요.