NVIDIA Nemotron 3.5 Super VL — 120B인데 12B만 켜서 에이전트 작업 5배 빨라요
NVIDIA가 텍스트·이미지·문서·영상을 한 모델로 처리하는 오픈 웨이트 MoE 모델을 공개했어요. 전체 120B 파라미터 중 토큰당 12B만 활성화해서, 같은 크기 오픈 모델 대비 에이전트 작업 처리량이 5배 높다고 해요.
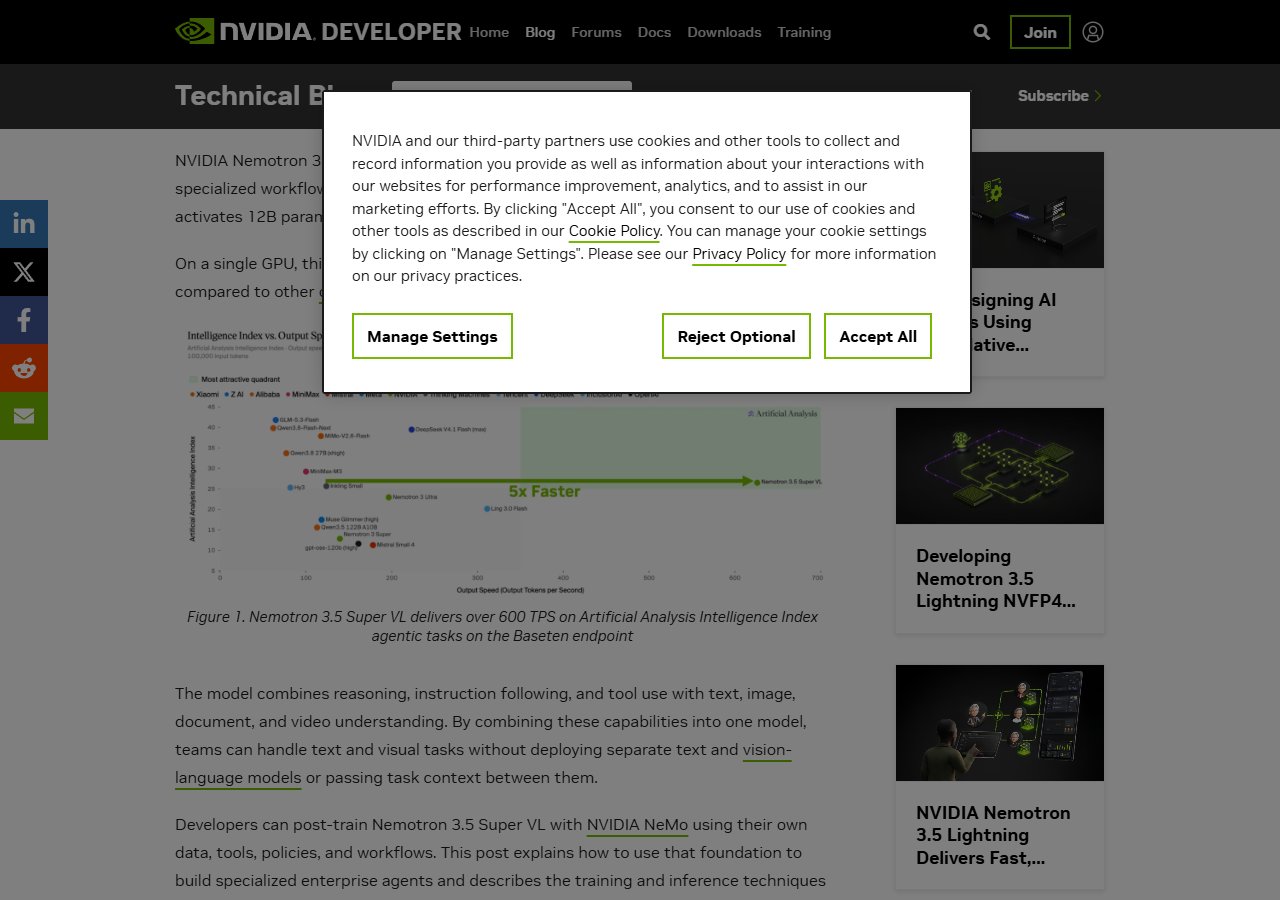
- Nemotron 3.5 Super VL은 120B 파라미터 MoE(혼합 전문가) 모델이에요. 토큰당 12B만 활성화해서, Baseten 엔드포인트 기준 초당 600토큰 이상을 내고, 같은 크기 오픈 모델 대비 에이전트 작업 처리량이 5배 높다고 해요.
- 텍스트·이미지·문서(표·차트·OCR)·영상(최대 2분)을 하나의 모델로 처리해요. Mamba-2와 트랜스포머를 섞은 하이브리드 구조에 C-RADIO 비전 인코더를 붙였고, 컨텍스트 길이는 최대 100만 토큰이에요.
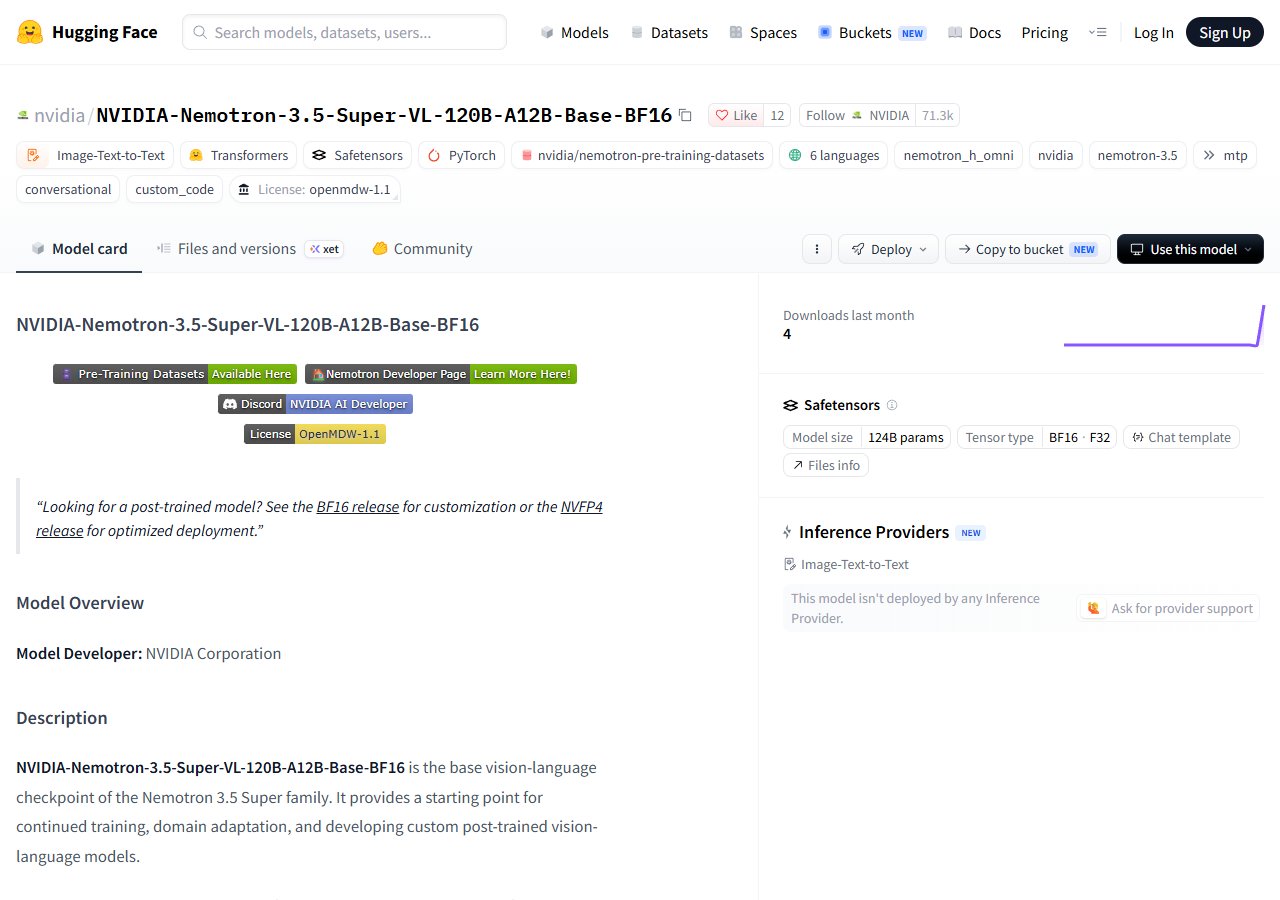
- 오픈 웨이트(OpenMDW-1.1 라이선스)로 Hugging Face에 공개됐어요. NVIDIA NeMo로 파인튜닝할 수 있고, DGX Spark(128GB)에서도 돌릴 수 있어요.
이미지·문서·영상을 읽어야 하는 에이전트를 만들 때, 비전 모델과 텍스트 모델을 따로 호출하지 않고 Nemotron 3.5 Super VL 하나로 통합할 수 있어요. vLLM으로 셀프 호스팅하면 API 비용도 줄어요.
차트·표가 든 보고서 PDF를 모델에 넣고 핵심 숫자를 뽑거나, 제품 영상을 요약하는 자동화 파이프라인을 만들어 볼 수 있어요.
OpenRouter 같은 호스팅 서비스에서 바로 써 볼 수 있어요. 견적서·영수증 사진을 올리고 항목별 금액을 뽑는 식으로 문서 처리 자동화에 활용할 수 있어요.
1. 가장 쉬운 길: OpenRouter 같은 호스팅 서비스에서 API 키로 바로 호출(NVIDIA 블로그가 안내)
2. 직접 돌리려면 Hugging Face 모델 카드(nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-Base-BF16)의 배포 안내를 그대로 따르기 — 120B라 큰 GPU 메모리가 필요해요
3. 영상은 mp4 2분까지, 문서는 페이지 그림 + 글로 넣어요
문서나 차트가 포함된 콘텐츠를 자동으로 분석하는 워크플로를 만들 때, 비전 모델을 따로 돌리지 않아도 되니 파이프라인이 훨씬 단순해질 것 같아요.
AI 에이전트가 텍스트만 읽던 시대는 지났어요. 이제는 문서 속 표, 차트 이미지, 짧은 영상까지 한꺼번에 이해해야 실무에서 쓸 수 있어요. NVIDIA가 10월 15일 공개한 Nemotron 3.5 Super VL은 이 네 가지 모달리티(양식)를 하나의 모델로 처리해요.
120B 파라미터, 실제로 쓰는 건 12B
전체 파라미터는 120B이지만, MoE(Mixture of Experts, 혼합 전문가) 구조라서 토큰 하나를 처리할 때 512개 전문가 중 일부만 활성화해요. 활성 파라미터는 12B에요. 덕분에 같은 크기 오픈 모델 대비 에이전트 작업 처리량이 5배 높다고 NVIDIA는 밝혔어요.
Baseten 엔드포인트 기준 초당 600토큰 이상을 냈고, NVIDIA Dynamo 서빙 엔진을 쓰면 16대의 B200 GPU에서 8배 더 많은 사용자를 처리하면서 첫 토큰 지연을 85% 줄였다고 해요. DGX Spark에서는 LiLiCorr 추측 디코딩으로 2.3배 빠른 토큰 생성을 달성했어요.
구조: Mamba-2 + 트랜스포머 + C-RADIO 비전 인코더
일반적인 트랜스포머만 쓰지 않고, Mamba-2 레이어(상태 공간 모델, SSM)와 어텐션 레이어를 번갈아 쌓은 하이브리드 구조예요. 여기에 MoE 레이어를 끼워 넣었어요. 비전 쪽은 NVIDIA가 만든 C-RADIO 비전 인코더를 비전-언어 커넥터로 연결했어요.
컨텍스트 길이는 최대 100만 토큰이에요. 입력으로 텍스트, 이미지(JPEG·PNG), 영상(MP4, 최대 2분)을 받아요. Multi-Token Prediction(MTP)을 내장해서 추측 디코딩을 별도 드래프트 모델 없이 할 수 있어요.
벤치마크 결과
NVIDIA 블로그와 Hugging Face 모델 카드에서 확인한 주요 점수예요.
- Hermes Bench(에이전트 벤치마크): 63.44% — Nemotron 3 Ultra(56.33%) 대비 +7.1%p
- LangChain Evals: 87.05% — Nemotron 3 Ultra(84.3%) 대비 +2.75%p
- CharXiv(차트 추론): 기본 80.8%, 파이썬 코드 해석 포함 84%
- MMLU: 84.14% / MMLU-Pro: 76.25%
- GSM8K(수학): 91.74% / HumanEval(코딩): 81.31%
에이전트 작업(Hermes Bench, LangChain) 점수가 전작 대비 눈에 띄게 올랐어요. 다만 이 벤치마크들은 NVIDIA 자체 측정이라, 독립 기관의 재현 결과는 아직 나오지 않았어요.
실제 기업 적용 사례
NVIDIA는 블로그에서 세 가지 사례를 들었어요.
- Scale AI·Skydance — 추론 비용 40배 절감, 지연 5배 감소
- Ramp — 처리량 50% 향상, 지연 10배 감소
- AI21(Alice) — 위협 인텔리전스 작업 정확도 40% 향상
어디서 쓸 수 있나요?
오픈 웨이트(OpenMDW-1.1 라이선스)로 Hugging Face와 ModelScope에 공개됐어요. OpenRouter를 비롯한 20곳 이상의 추론 서비스에서 호스팅 API로도 쓸 수 있어요. 기업용으로는 NVIDIA NIM을 통해 지원을 받을 수 있어요.
NVIDIA NeMo로 자체 데이터에 맞게 파인튜닝할 수 있고, DGX Spark(128GB 메모리) 한 대에서도 돌릴 수 있어요. 학습 데이터는 20조 토큰 이상, 영어 포함 20개 언어와 43개 프로그래밍 언어를 지원한다고 해요.
다만
벤치마크 점수는 NVIDIA가 직접 측정한 것이라, 제삼자 독립 평가 결과와 다를 수 있어요. 또 120B MoE라도 GPU 메모리는 전체 파라미터를 올려야 하므로, 셀프 호스팅에는 H100·B200급 GPU가 필요해요. OpenMDW-1.1 라이선스는 상업 이용이 가능하지만, 라이선스 세부 조건은 직접 확인해 보는 게 좋아요.