약 4GB로 도는 대화형 에이전트 모델 — NVIDIA 'Nemotron 3.5 Bolt E4B 4GB' 공개
NVIDIA가 10월 23일 음성 비서 · 게임 속 캐릭터 · 로봇처럼 '대화하면서 도구도 부르는' 일에 맞춘 작은 오픈 모델을 내놨어요. 4비트로 줄인 판이 RTX 5070에서 VRAM 3.5~4.3GB만 썼고, Ollama 한 줄로 바로 받아 볼 수 있어요.
- Nemotron 3.5 Bolt E4B 4GB는 구글 Gemma 4 E4B에 NVIDIA의 추가 학습(post-training)을 더한 오픈 모델이에요. 여러 번 주고받는 대화 속 도구 호출 · 짧게 말하는 대화 모드 · 생각(reasoning) 켜고 끄기 · 64k 문맥 · 35개 언어를 지원해요.
- NVIDIA 측정(4비트 Q4_K_M · llama.cpp · 한 번에 1개 요청)에서 RTX 5070(12GB)은 VRAM 3.5~4.3GB · 첫 글자까지 548~1,238ms였어요. 이전 모델 Nemotron 3 Nano 4B보다 평균 점수가 약 40% 높고, 생각 모드 비교에서 출력 토큰은 비슷한 모델보다 최대 80% 적었다고 해요.
- 다만 모든 표에서 1등은 아니에요. 고객 응대형 과제 Tau2-Bench는 Qwen 3.5 4B가 75.1로 Bolt(55.1)보다 높았고, 긴 문서 시험(LongBench v2 · RULER)도 Qwen 3.5 4B가 앞섰어요. 점수표의 Brevity Bench · When2Call-MT는 아직 공개 전인 NVIDIA 자체 시험이에요.
게임 NPC · 앱 안 음성 비서처럼 '말하면서 함수를 부르는' 기능을 클라우드 API 없이 시제품으로 만들 때 좋아요. 모델 카드에 llama-server · Ollama 실행 줄이 그대로 있고, --reasoning-budget으로 생각 길이를 제한할 수 있어요.
캐릭터 말투를 지키는 대화 봇을 내 PC에서 돌려 보고 싶을 때 써 볼 만해요. 캐릭터 말투 시험(RoleBench)에서 67.0으로 비교 모델(Qwen 3.5 4B 53.7 · Gemma 4 E4B 49.9)보다 높았어요(NVIDIA 표 기준).
고객 정보를 밖으로 보내기 어려운 상담 · 안내 봇을 기획할 때, 노트북 GPU에서 먼저 돌려 보는 후보로 좋아요. 다만 고객 응대형 과제 점수는 Qwen 3.5 4B가 더 높았으니 같이 시험해 보세요.
1) Ollama를 설치한다 2) 터미널에서 ollama run hf.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-E4B-4GB:Q4_K_M 실행 3) 시스템 프롬프트에 캐릭터 설정과 쓸 도구 목록을 넣고 몇 번 주고받아 본다 4) 응답이 길면 생각(reasoning)을 끄거나 llama-server의 --reasoning-budget으로 줄여 본다 · 라이선스: OpenMDW 1.1(바탕 Gemma 4는 Apache 2.0) · 비용: 무료(내 PC 전기 · GPU)

게임 캐릭터나 음성 비서처럼 말투와 행동을 같이 하는 대화 봇을, 돈 들지 않게 내 PC에서 먼저 만들어 볼 때 써 보면 좋을 것 같아요.
NVIDIA가 10월 23일 작은 오픈 모델 Nemotron 3.5 Bolt E4B 4GB를 공개했어요. NVIDIA는 이 모델을 '대화형 에이전트(사람과 말을 주고받으며 도구를 불러 일을 하는 AI)에 맞춰, GB당 속도와 똑똑함을 높인 모델'이라고 소개했어요. 이름의 '4GB'는 목표 작업에서 약 4GB 메모리 안에 담도록 만들었다는 뜻이에요.
무엇을 위한 모델인가
바탕은 구글의 Gemma 4 E4B이고, 여기에 NVIDIA가 강화학습(RLVR · RLHF)으로 추가 학습을 했어요. NVIDIA가 든 쓰임새는 세 가지예요.
- 기기 · 음성 비서: PC · 휴대폰 · 앱 · 집 · 차 안에서 빠르게 답하는 비서, 고객 상담
- 가상 캐릭터: 게임 속 NPC(사람이 조종하지 않는 등장인물) · 대화 친구처럼, 말과 행동을 섞으며 캐릭터를 지키는 경우
- 로봇 · 산업 기기: 로봇 · 중장비와 사람이 대화하는 화면, 공장 IoT 자동화
공개 글에는 대장장이 상인 NPC 시연이 있어요. 손님이 돈을 제대로 냈는지 확인한 뒤, 스스로 도구를 불러 제작법 확인 → 재료 모으기 → 물건 만들기 → 건네주기까지 해요. 로봇 Reachy Mini를 Jetson Orin Nano 8GB에서 돌린 시연도 실렸어요.
기능
- 여러 번 주고받는 도구 호출: 대화를 이어 가면서 앱의 API를 불러 일을 처리
- 대화 모드: 켜면 소리로 읽기 좋은 짧은 답을 하도록 유도
- 생각(reasoning) 켜고 끄기: 어려운 요청엔 켜고, 빠른 답이 필요하면 끔. 생각 길이에 상한을 둘 수도 있어요
- 64k 문맥: 대화 기록 · 지시 · 도구 정의 · 검색 결과를 함께 담는 길이
- 35개 언어 지원(바탕 모델은 140개 넘는 언어로 사전 학습)
숫자로 보면
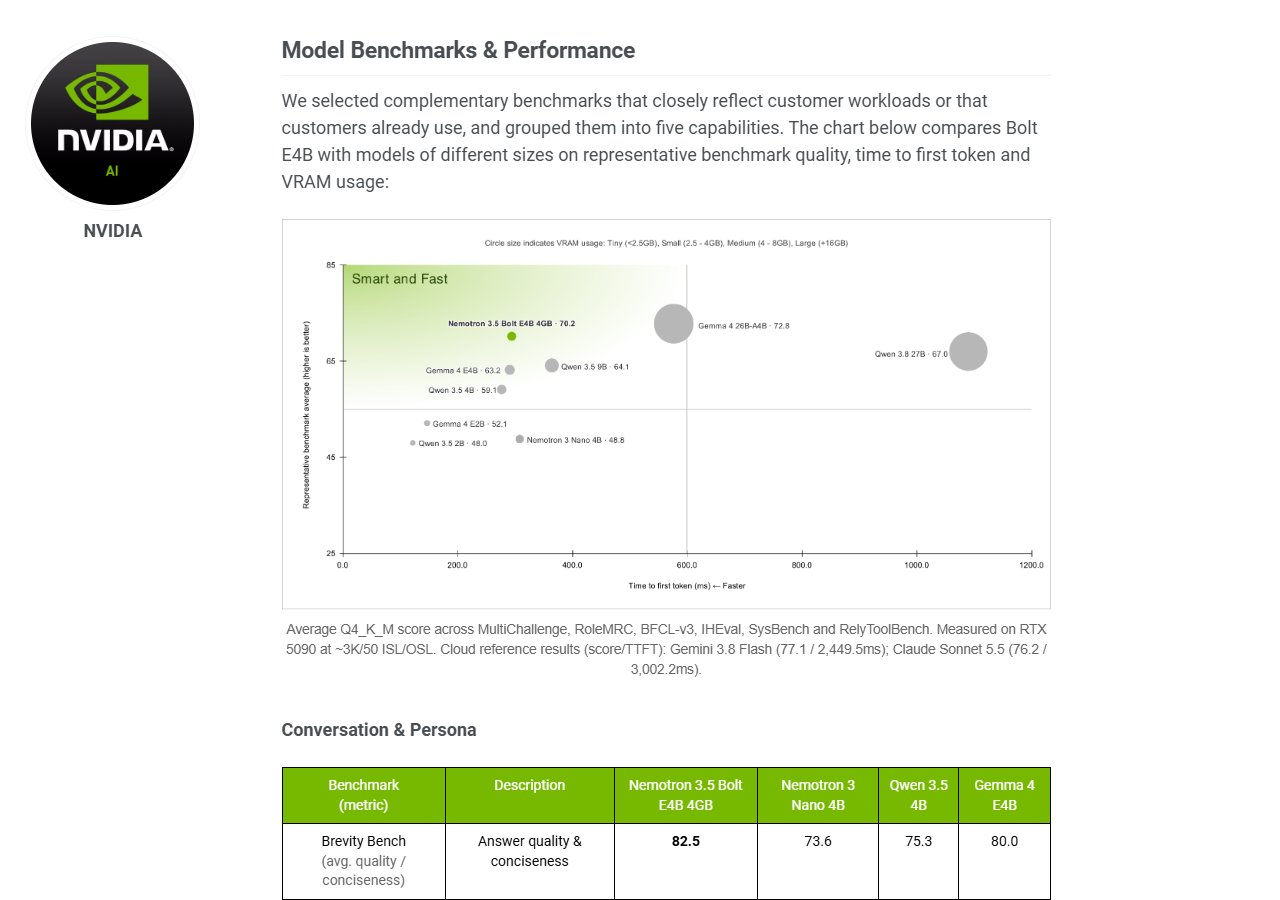
NVIDIA는 고객 작업에 가까운 시험을 다섯 묶음(대화 · 캐릭터, 도구 호출, 지시 따르기, 긴 문맥, 근거 지키기)으로 골라 비교했어요. 전체 평균으로 이전 모델 Nemotron 3 Nano 4B보다 약 40%, 다른 비교 모델보다 약 10% 높았다고 밝혔어요. 출력 토큰은 생각 모드를 켠 비교에서 최대 80% 적었다고 해요. 쓸데없는 말을 줄이면 계산이 줄고 답도 빨라질 수 있어요.
NVIDIA 그래프(4비트 Q4_K_M · RTX 5090 · 6개 시험 평균)에서 Bolt E4B는 70.2로, Gemma 4 E4B 63.2 · Qwen 3.5 4B 59.1 · Nemotron 3 Nano 4B 48.8보다 높았어요. 더 큰 Gemma 4 26B-A4B는 72.8이었어요.
비교 표(BF16 기준)의 몇 줄이에요.
- 캐릭터 말투(RoleBench): Bolt 67.0 · Qwen 3.5 4B 53.7 · Gemma 4 E4B 49.9
- 지시 우선순위 지키기(IHEval): Bolt 84.8 · Gemma 4 E4B 67.0 · Qwen 3.5 4B 60.6
- 도구를 부를지 · 되물을지 판단(When2Call-MT): Bolt 63.4 · Gemma 4 E4B 62.9 · Qwen 3.5 4B 37.8
- 고객 응대형 여러 단계 과제(Tau2-Bench): Qwen 3.5 4B 75.1 · Bolt 55.1 · Gemma 4 E4B 38.5
- 긴 문맥 찾기(RULER 64K): Qwen 3.5 4B 95.1 · Nemotron 3 Nano 4B 91.5 · Bolt 87.0
표 안의 Brevity Bench와 When2Call-MT는 기존 시험의 빈 곳을 채우려 NVIDIA가 만든 것으로, 나중에 공개할 예정이라고 적혀 있어요.
내 GPU에서는 얼마나 쓰나
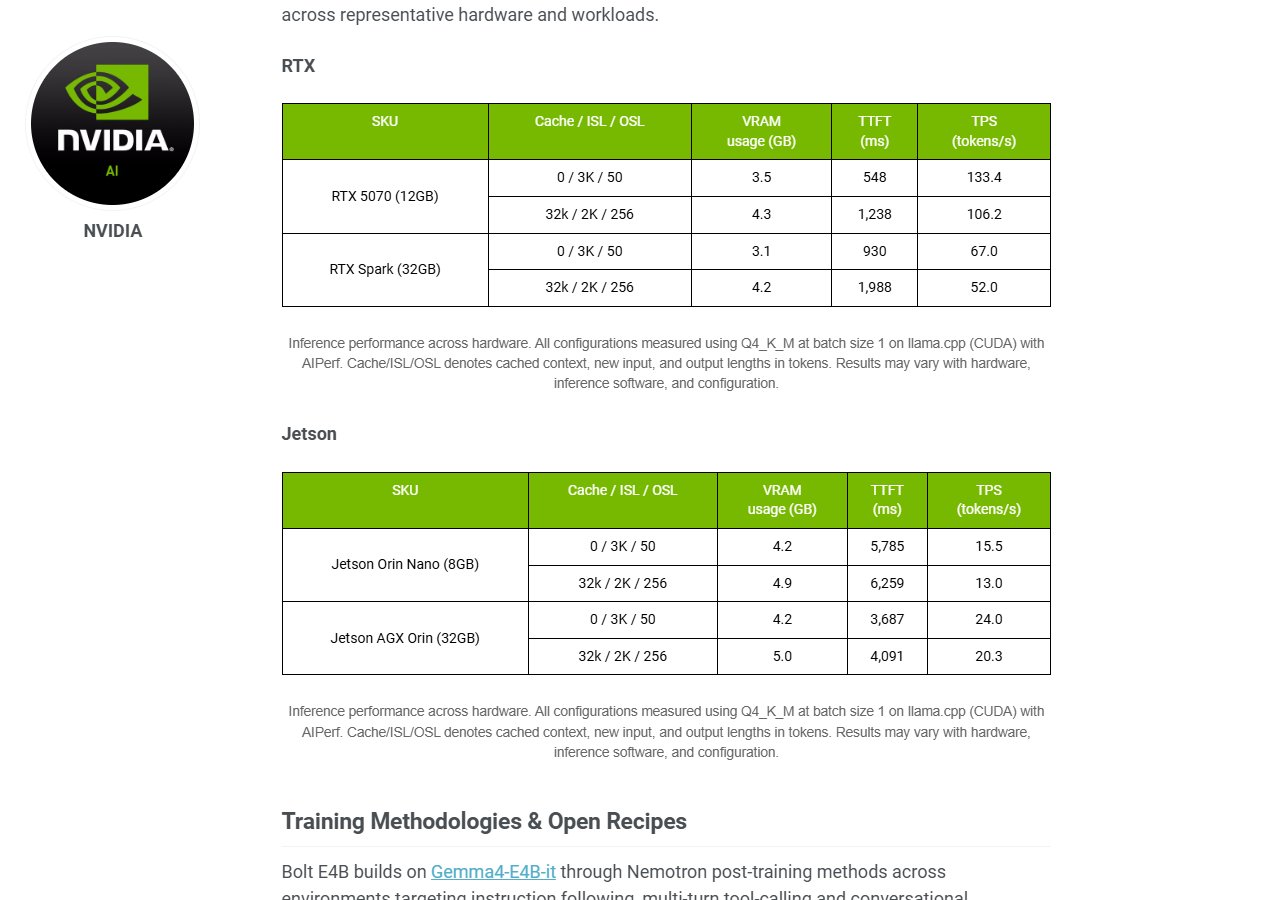
NVIDIA가 4비트(Q4_K_M) 판을 llama.cpp(CUDA)에서 한 번에 요청 1개씩 잰 결과예요. 아래 'ISL/OSL'은 새 입력 · 출력 토큰 수예요.
- RTX 5070 (12GB): 입력 3K · 출력 50일 때 VRAM 3.5GB · 첫 글자까지 548ms · 초당 133.4토큰 / 캐시 32k · 입력 2K · 출력 256일 때 VRAM 4.3GB · 1,238ms · 초당 106.2토큰
- Jetson Orin Nano (8GB): 입력 3K · 출력 50일 때 VRAM 4.2GB · 5,785ms · 초당 15.5토큰
NVIDIA는 하드웨어 · 추론 프로그램 · 설정에 따라 결과가 달라질 수 있다고 덧붙였어요.
어떻게 받나
Hugging Face에 4비트 GGUF 판과 BF16 판, 그리고 답을 더 빨리 뽑게 돕는 보조 모델(DFlash drafter)이 올라왔어요. NVIDIA는 DFlash가 Gemma 4 E4B의 원래 보조 모델보다 처리량이 최대 21% 높다고 밝혔어요. Ollama · LM Studio · Unsloth · Jetson AI Lab 등에서도 받을 수 있다고 했어요. 모델 카드에 적힌 Ollama 실행 줄은 이거예요.
ollama run hf.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-E4B-4GB:Q4_K_M
라이선스는 OpenMDW 1.1이고, 바탕이 된 Gemma 4 부분은 Apache 2.0을 따라요. 학습에 쓴 데이터 목록과 학습 방법(레시피)도 함께 공개됐어요.