PyTorch 코드를 구글 TPU에서 그대로 — Google · Meta가 TorchTPU를 오픈소스로 공개했어요
PyTorch 블로그(10월 20일)에 TorchTPU가 소개됐어요. model.to("cuda")를 model.to("tpu")로 바꾸면 돌아가는 걸 목표로 한 PyTorch의 TPU 백엔드(실행 엔진)이고, 학습은 TPU v7 칩 8,192개까지 시험했어요.
- TorchTPU는 Google과 Meta의 PyTorch 팀이 함께 만든 오픈소스 TPU 백엔드예요. 목표는 model.to("cuda")를 model.to("tpu")로 바꾸는 정도로 기존 PyTorch 코드가 돌아가는 것이에요. 다만 원문은 이것만으로 최고 성능이 나오진 않는다고 적었어요.
- 즉시 실행(eager)과 torch.compile을 모두 지원하고, vLLM · SGLang 멀티 호스트 추론과 TorchTitan 학습을 검증했어요. Hugging Face 모델 4,917개 중 4,821개(98%)가 멈춤 없이 돌았어요.
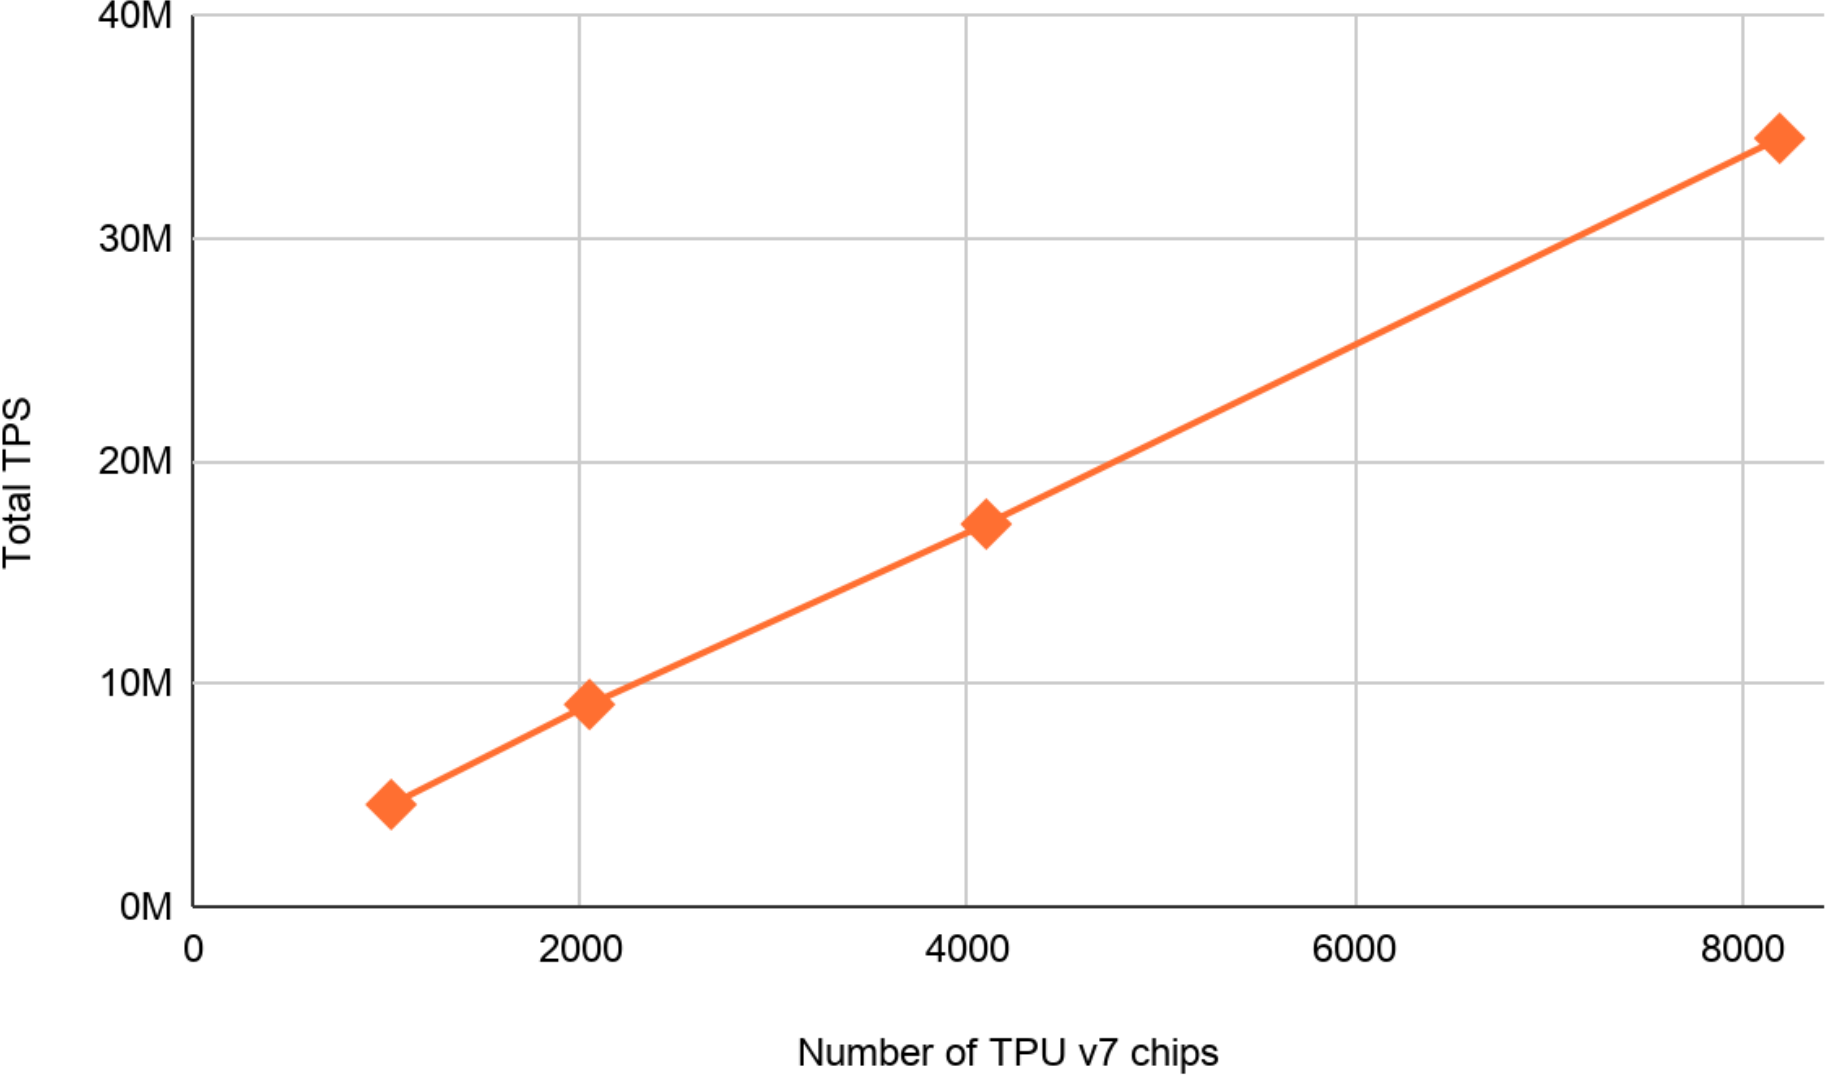
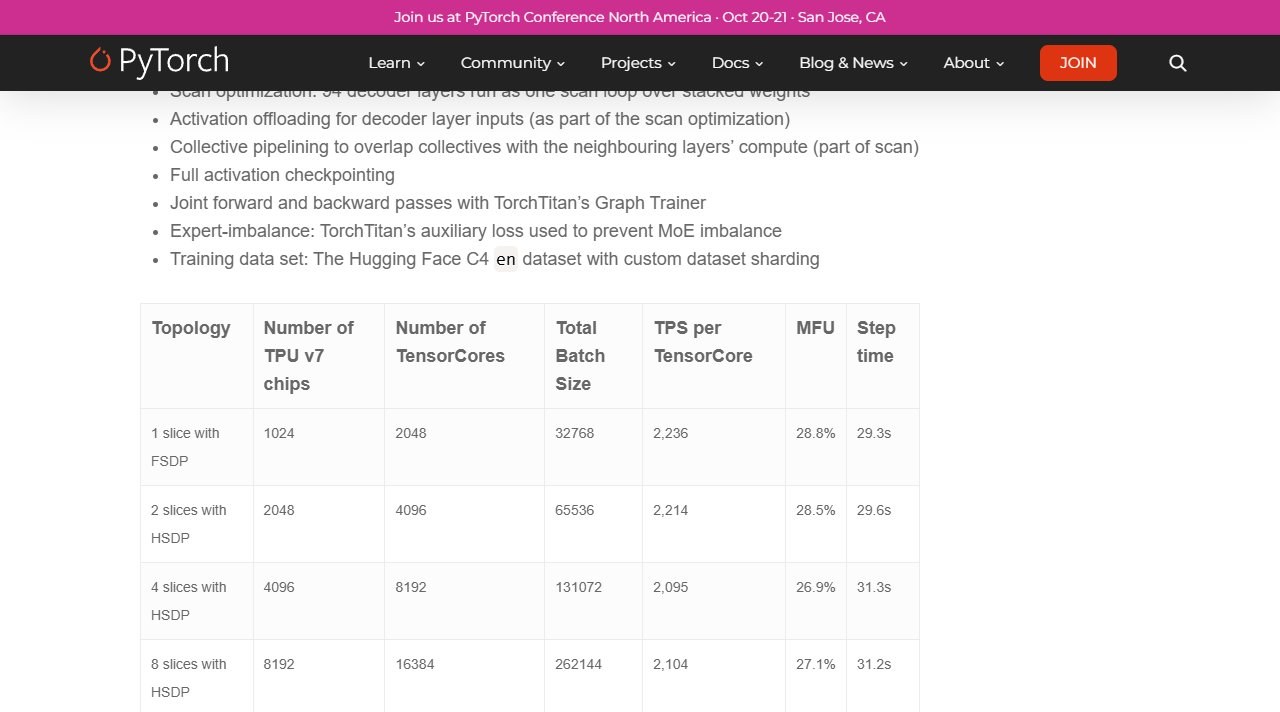
- Qwen3 MoE 235B 학습을 TPU v7 칩 1,024개에서 8,192개로 늘려도 TensorCore당 처리량은 2,236 → 2,104 TPS, MFU는 28.8% → 27.1%로 거의 그대로였어요(원문 표 기준). 설치는 pip, 라이선스는 Apache 2.0이에요.
GPU용으로 짠 PyTorch 학습 · 추론 코드를 구글 클라우드 TPU에서 돌려 보고 싶을 때, JAX로 다시 짜지 않고 장치 이름만 "tpu"로 바꿔 먼저 돌아가는지 확인해 볼 수 있어요. 원문 기준 아직 FlexAttention은 지원하지 않아요.
vLLM · SGLang으로 오픈 모델을 서빙하고 있다면, 이번에 함께 공개된 vLLM-TorchTPU · SGLang-TorchTPU로 TPU 서빙을 시험해 볼 수 있어요.
TPU VM(구글 클라우드)이 있어야 해서 개인 PC에서 바로 써 볼 도구는 아니에요. 클라우드 학습 비용을 비교할 때 'PyTorch도 TPU에서 돈다'는 선택지가 생겼다는 정도로 알아 두면 돼요.
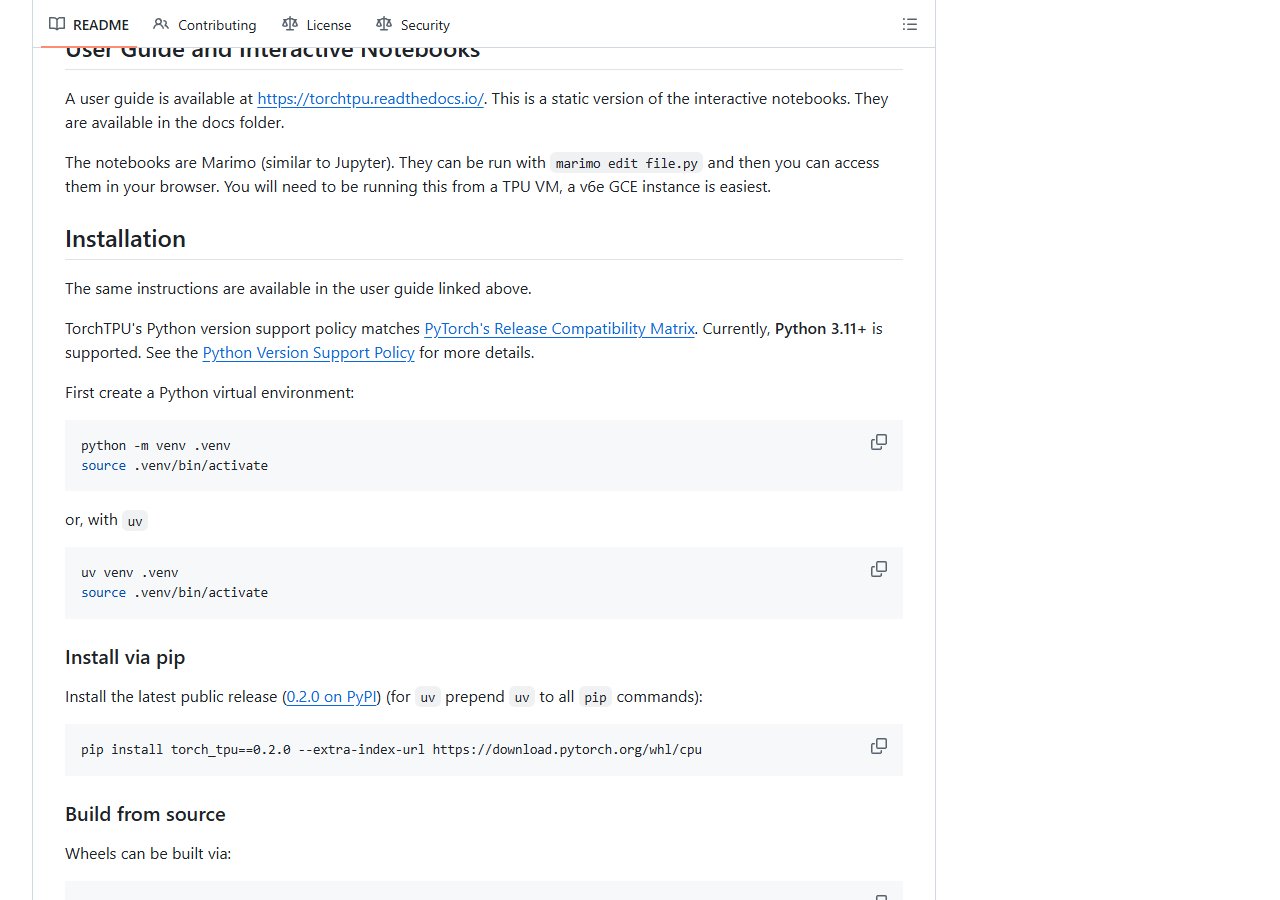
1. README 안내대로 TPU VM에서 진행하세요(노트북 실행은 'v6e GCE 인스턴스가 가장 쉽다'고 적혀 있어요). Python 3.11 이상이 필요해요.
2. 가상 환경(README 그대로): python -m venv .venv → source .venv/bin/activate
3. 설치(README 그대로): pip install torch_tpu==0.2.0 --extra-index-url https://download.pytorch.org/whl/cpu
4. 기존 코드의 model.to("cuda")를 model.to("tpu")로 바꿔 돌아가는지 확인하세요.
5. 그다음은 사용자 가이드(torchtpu.readthedocs.io)의 튜토리얼 · 노트북을 따르세요.
GPU로 파인튜닝하던 작은 오픈 모델을 TPU에서도 돌려 시간 · 비용을 비교해 보고 싶을 때, 장치 이름만 바꿔 먼저 돌아가는지 확인하는 용도로 써 보면 좋을 것 같아요. 다만 TPU VM이 필요하고 아직 0.2.0이라, 당장 옮기기보다는 지켜볼 단계로 보여요.
PyTorch 공식 블로그에 10월 20일 TorchTPU 소개 글이 올라왔어요. 구글 TPU(구글이 만든 AI 전용 칩)에서 PyTorch를 바로 돌리는 백엔드(PyTorch가 계산을 맡기는 실행 엔진)예요. 원문은 Google과 Meta의 PyTorch 팀이 함께 만든 오픈소스 프로젝트라고 소개했고, 2025년 중반 Google에서 시작됐다고 적었어요.
무엇이 달라지나
그동안 TPU는 주로 TensorFlow · JAX 쪽에서 쓰였어요. 2020년에 나온 PyTorch/XLA가 있었지만, 원문은 컴파일할 구간을 코드에 따로 표시해야 했고 컴파일이 느렸으며 즉시 실행(eager, 한 줄씩 바로 계산하는 방식) 모드를 지원하지 않았다고 설명해요.
TorchTPU의 목표는 model.to("cuda")를 model.to("tpu")로 바꾸는 정도로 기존 코드가 그대로 돌아가는 것이에요. 다만 원문은 이렇게만 바꿔서는 TPU 최고 성능이 나오지 않는다고 분명히 적었어요. 모델의 모양 · 분산 방식 · 연산이 GPU에 맞춰져 있을 수 있어서예요.
지금 되는 것 (원문 기준)
- 즉시 실행과 컴파일 모드(
torch.compile) 둘 다 지원. 새 eager 방식 DeferAndFuse는 여러 연산을 묶어 실행해서 기본 방식보다 50% 이상 빠를 수 있다고 해요. - ATen 연산(PyTorch 기본 연산) 약 450개 지원
- JAX/Pallas · Helion으로 직접 커널(칩에서 도는 계산 코드) 작성 가능
- vLLM · SGLang 멀티 호스트 추론, TorchTitan 학습 · 파인튜닝 검증
- 원문은 이미 일부 대형 Google Cloud 고객의 추론 · 학습에 실제로 쓰이고 있다고 적었어요.
숫자로 보면
모델 호환: Hugging Face 모델 4,917개를 돌려 4,821개(98%)가 멈춤 없이 실행됐고, 대표 구조 모델 657개 중 638개(97%)가 GPU와 같은 결과(수치 일치)를 냈어요.
대규모 학습: TorchTitan으로 Qwen3 MoE 235B를 학습시키며 TPU v7 칩 수를 늘려 봤어요(원문 표).
- 1,024개(1 슬라이스): TensorCore당 2,236 TPS, MFU(칩 성능을 얼마나 뽑아 썼나) 28.8%
- 2,048개: 2,214 TPS, 28.5%
- 4,096개: 2,095 TPS, 26.9%
- 8,192개(8 슬라이스): 2,104 TPS, 27.1%
칩을 8배로 늘려도 TensorCore(TPU 칩 안의 계산 코어) 하나가 내는 처리량과 MFU가 거의 그대로였고, 원문은 전체 초당 토큰 수가 칩 수에 맞춰 직선으로 늘었다고 설명해요. 그 전 단계 시험으로 TPU v7 64개에서 같은 모델을 돌렸을 땐 TorchTitan(PyTorch) 1,828 TPS, JAX/MaxText 1,937 TPS로 JAX보다 조금 낮지만 비슷했어요.
설치와 공개 범위
GitHub README의 설치 명령은 pip install torch_tpu==0.2.0 --extra-index-url https://download.pytorch.org/whl/cpu이고, Python 3.11 이상, 라이선스는 Apache 2.0이에요. 원문은 10월 PyTorch 콘퍼런스에서 TorchTPU · vLLM-TorchTPU · SGLang-TorchTPU · TorchTitan 네 저장소를 공개한다고 적었어요.
다만 아직 한계도 있어요. 원문 기준 FlexAttention은 아직 지원하지 않고, 기본 통신 방식(Skinny Collectives)은 계산과 통신을 겹치지 못해 전체 속도가 떨어질 수 있다고(원문 예: 30~40%) 적었어요(개선 작업 중). 앞으로 6~12개월은 안정화와 생태계 확장에 집중한다고 해요.