작은 AI를 '고르기 전용'으로 다시 가르쳐요… Unsloth, 그래픽 메모리 4GB에서 정확도 20.7% → 74.3%
오픈소스 학습 도구 Unsloth에 일반 언어 모델을 판단 전용 모델로 바꾸는 학습 기능이 들어갔어요. 숫자는 모두 Unsloth가 직접 잰 값이고, 시험마다 숫자가 달라요.
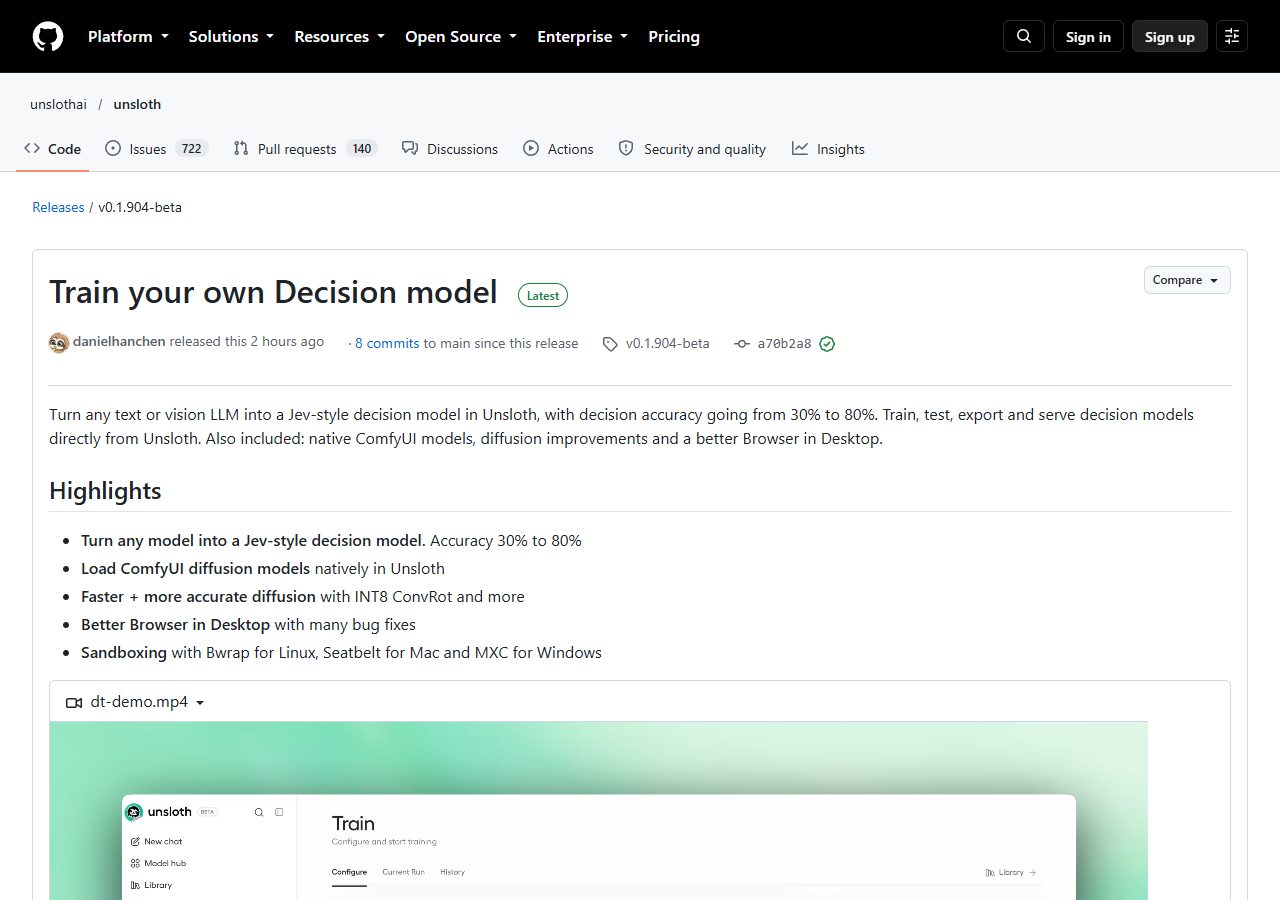
- Unsloth 새 버전(v0.1.904-beta, 10월 7일)에서 Qwen·Gemma·Llama 같은 언어 모델을 '판단 모델'로 학습시킬 수 있어요. 학습한 모델은 글을 쓰지 않고, 준 보기마다 점수를 매겨 답과 확률을 돌려줘요.
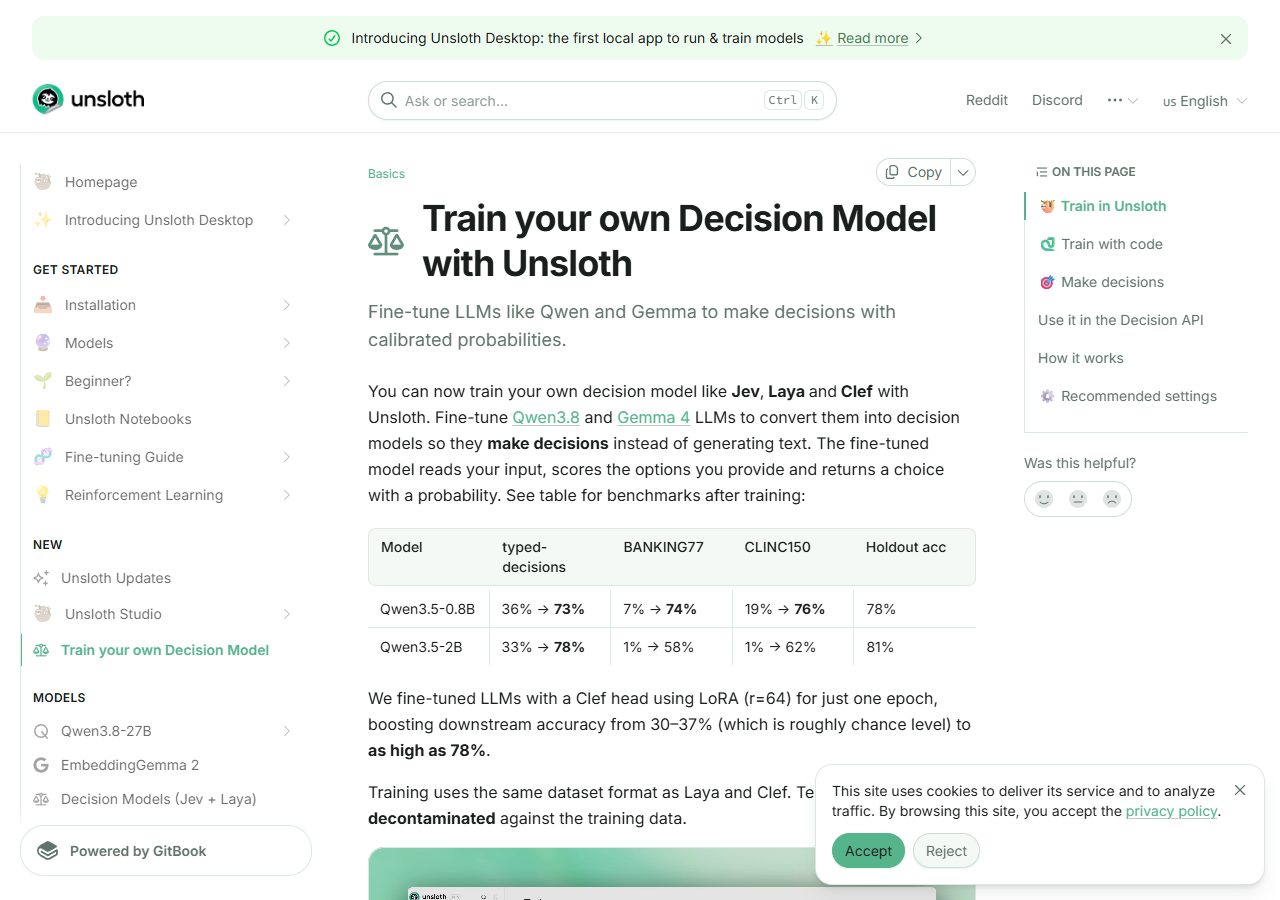
- Qwen3.5-0.8B는 세 시험에서 36→73%, 7→74%, 19→76%로 올랐어요. 공식 X의 '20.7% → 74.3%'는 이 세 시험을 묶은 값이고, 표의 78%는 학습에서 떼어 둔 문제로 잰 다른 숫자예요. 그래픽 메모리 4GB, 학습 42분이라고 적혀 있어요.
- 더 큰 모델이 늘 낫지는 않았어요. Qwen3.5-2B는 두 시험에서 58%, 62%로 0.8B보다 낮게 나왔어요. 시험은 영어 데이터로 보이고, 한국어 성적은 원문에 없어요.
문의·댓글을 내 기준('질문/칭찬/스팸', '환불 요청인가')으로 나누는 분류기가 필요하고, 정답을 붙인 예시가 수백 개 이상 있을 때 시험해 볼 만해요. Unsloth Desktop의 Train 탭에서 'Train as'를 Decision model로 바꾸면 되고, 학습 전후 정확도를 앱이 보여 줘요.
그래픽 카드와 정답 붙인 데이터가 없다면 당장 쓸 일은 없어요. 분류가 필요하면 학습 없이 바로 쓰는 판단 모델 API가 먼저예요. '작은 모델도 고르기만 시키면 꽤 맞힌다'는 흐름만 알아 두세요.
1) Unsloth Desktop 설치 (macOS·Windows·Linux)
2) Train 탭에서 모델(예: unsloth/Qwen3.5-4B)을 고르고 'Train as'를 Decision model로
3) 내 데이터 올리기: 줄마다 '읽을 글 + 질문과 보기 + 정답'
4) Start Training → 떼어 둔 문제로 잰 학습 전후 정확도 확인
· 라이선스: 핵심 패키지 Apache 2.0, Studio 화면은 AGPL-3.0 · 비용: 무료(내 그래픽 카드 사용)
쌓아 둔 댓글·문의에 직접 붙인 분류 기록이 있다면, 그 기준 그대로 판정하는 작은 모델을 한 시간 안쪽으로 만들어 보는 실험에 써 볼 수 있을 것 같아요. 기록이 없다면 예시 몇백 개에 정답을 붙이는 일부터 해야 해서, 지금은 읽고 넘어가도 괜찮아 보여요.
오픈소스 AI 학습 도구 Unsloth가 10월 7일(현지 시간) 새 버전 v0.1.904-beta를 내면서 판단 모델 학습 기능을 넣었어요. 판단 모델은 답을 글로 쓰지 않고 '예/아니오', '보기 중 하나', '점수'만 확률과 함께 돌려주는 모델이에요. 지금까지는 만들어진 판단 모델을 가져다 쓰는 소식이 많았는데, 이번 건 내가 가진 작은 모델을 내 데이터로 판단 전용으로 바꾸는 쪽이에요.
어떻게 하나 — 일반 언어 모델에 작은 판정 부품(헤드)을 붙이고 LoRA(모델 전체가 아니라 일부만 가볍게 추가 학습하는 방법)로 학습해요. 입력 글과 질문·보기를 한 번에 읽고, 보기마다 점수를 매겨 여러 질문을 한꺼번에 정해요. 글을 만들지 않으니 그만큼 메모리를 덜 써요. 학습 뒤에는 떼어 둔 문제로 확률 보정(모델이 '90%'라고 말하면 실제로도 그만큼 맞도록 맞추는 일)을 해요. Unsloth Desktop 앱에서는 Train 탭의 'Train as'를 Decision model로 바꾸면 되고, 파이썬 코드로도 할 수 있어요.
숫자 (모두 Unsloth가 직접 잰 값) — 가장 작은 Qwen3.5-0.8B의 학습 전후 정확도예요.
- typed-decisions: 36% → 73%
- BANKING77(은행 문의 분류): 7% → 74%
- CLINC150(의도 분류): 19% → 76%
- 학습에서 떼어 둔 문제(Holdout): 78%
공식 X 글은 세 시험을 묶어 20.7% → 74.3%라고 적었어요. 표의 세 숫자를 평균하면 같은 값이 나와요(36·7·19의 평균 20.7, 73·74·76의 평균 74.3). 78%는 이와 다른, 떼어 둔 문제로 잰 정확도예요. 시험 문제는 3,000개(typed-decisions 2,000개, BANKING77 500개, CLINC150 500개)이고, 학습 데이터와 겹치는 문제는 걸러 냈다고 해요.
필요한 장비 — 문서 표에 따르면 Qwen3.5-0.8B는 그래픽 메모리(VRAM) 4GB, 학습 42분이에요. Qwen3.5-2B는 8GB·40분(81%), Llama 3.2 3B는 4.1GB·30분(79%), Gemma 4 E4B는 14.4GB·49분(77%)이에요. 어떤 그래픽 카드로 잰 시간인지는 표에 적혀 있지 않아요.
다만 — 큰 모델이 늘 낫지는 않았어요. Qwen3.5-2B는 BANKING77에서 58%, CLINC150에서 62%로 0.8B(74%, 76%)보다 낮아요. 원문 안에서도 숫자 표현이 조금씩 달라요. 문서 본문은 "30–37%"에서 "as high as 78%"로 올랐다고 쓰고, 배포 안내문은 30%에서 80%라고 적었어요. 학습 설정도 한 곳은 LoRA 64·1회, 다른 곳은 16·2회로 안내해요. 시험 데이터 이름으로 보면 영어 문제이고, 한국어 성적은 원문에 없어요.
라이선스와 비용 — Unsloth의 핵심 패키지는 Apache 2.0(상업적으로도 쓸 수 있는 공개 라이선스), Studio 화면 같은 일부 구성 요소는 AGPL-3.0이에요. Desktop 앱은 무료예요. 학습한 모델로 판정을 돌릴 때도 GPU가 필요해요.
X 게시물 보기 · https://x.com/unslothai/status/2107868866361930236