Prime Intellect, 수조 토큰 굴려 본 추론 서비스 'Prime Inference' 공개
강화학습과 고객 전용 배포에 쓰던 자체 추론 기술을 서비스로 열었어요. 내부에서만 하루 1조 토큰 가까이 처리한대요.
핵심 3줄
- 서버리스 엔드포인트와 전용 예약 용량, 두 가지로 공개 모델을 돌려 줘요. 첫 모델은 GLM-5.3이에요.
- 기억 데이터(KV 캐시)를 NVFP4로 압축해 서버 한 대가 담는 양을 약 50% 늘렸어요.
- 스케줄러를 손봐 대기 시간 중간값을 550ms에서 110ms로 줄였어요.
🧪 CONTENTSLAB 평참고만★★★★★실전 활용도 2/5
개발자
GLM-5.3 같은 공개 모델을 GPU 서버 없이 서버리스 API로 돌릴 곳 후보로 북마크.
CONTENTSLAB 생각 · 이렇게 써 볼 수 있을 것 같아요
저희 일에는 당장 쓸 곳이 없어 보여요. 공개 모델을 직접 서빙할 일이 없고, 지금은 각 회사 API로도 충분하거든요.
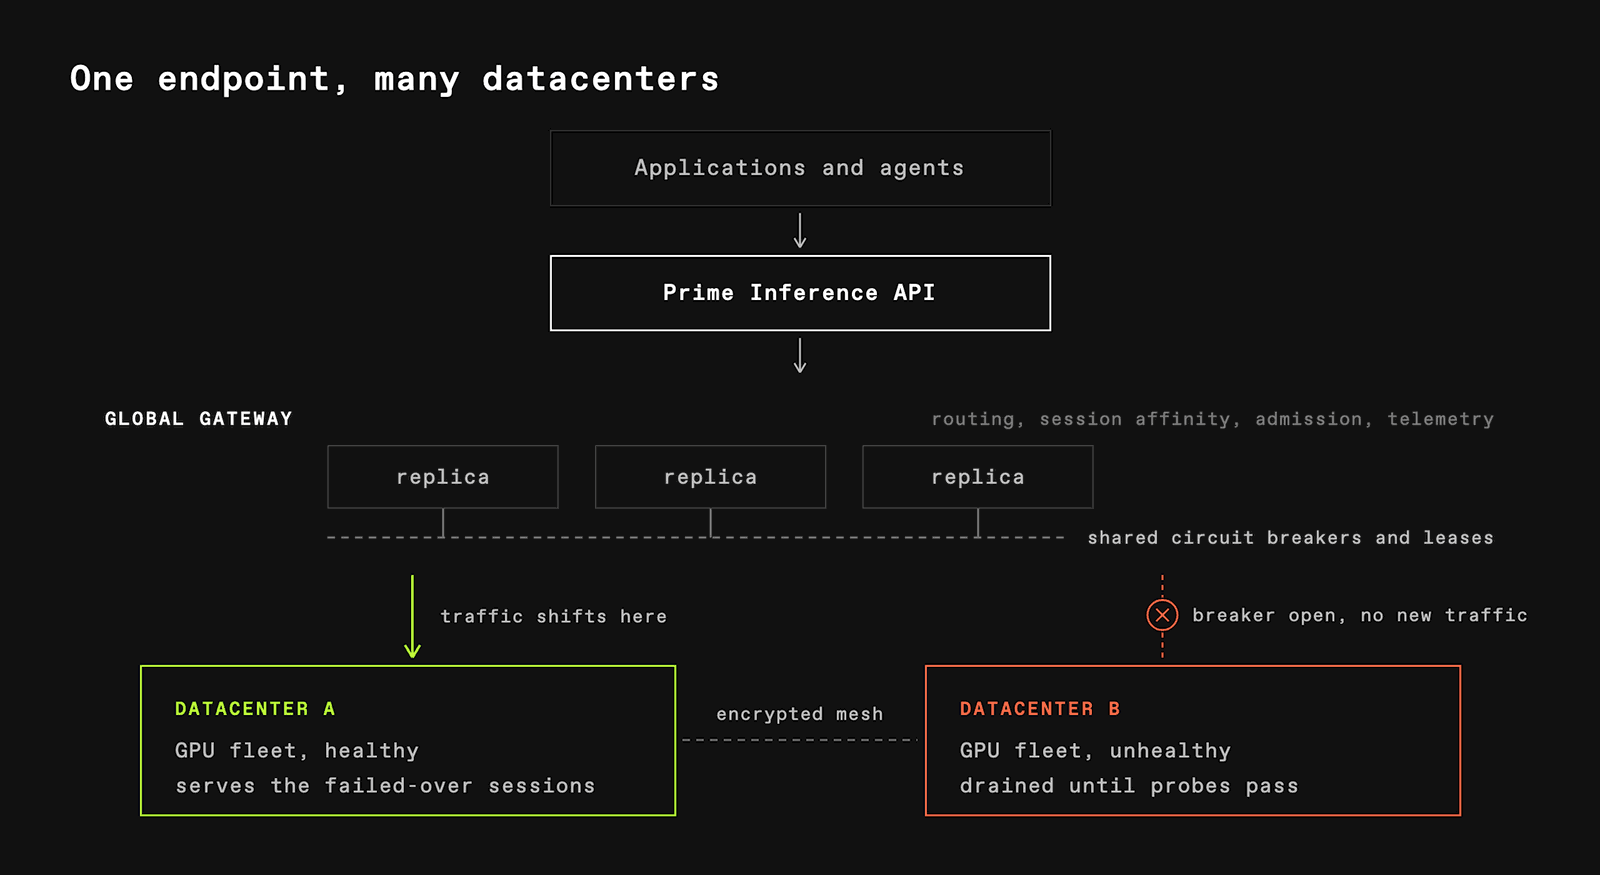
추론(inference)은 다 만든 AI 모델을 실제로 돌려 답을 받는 일이에요. Prime Intellect는 엔비디아 Blackwell GPU 위에서 '질문 읽기'(prefill)와 '답 쓰기'(decode)를 서로 다른 서버로 나눠 돌리는 방식으로, 답 글자 사이 지연(p90)을 40% 가까이 줄였다고 밝혔어요.
X 게시물 보기 · https://twitter.com/primeintellect/status/2106146483003384253