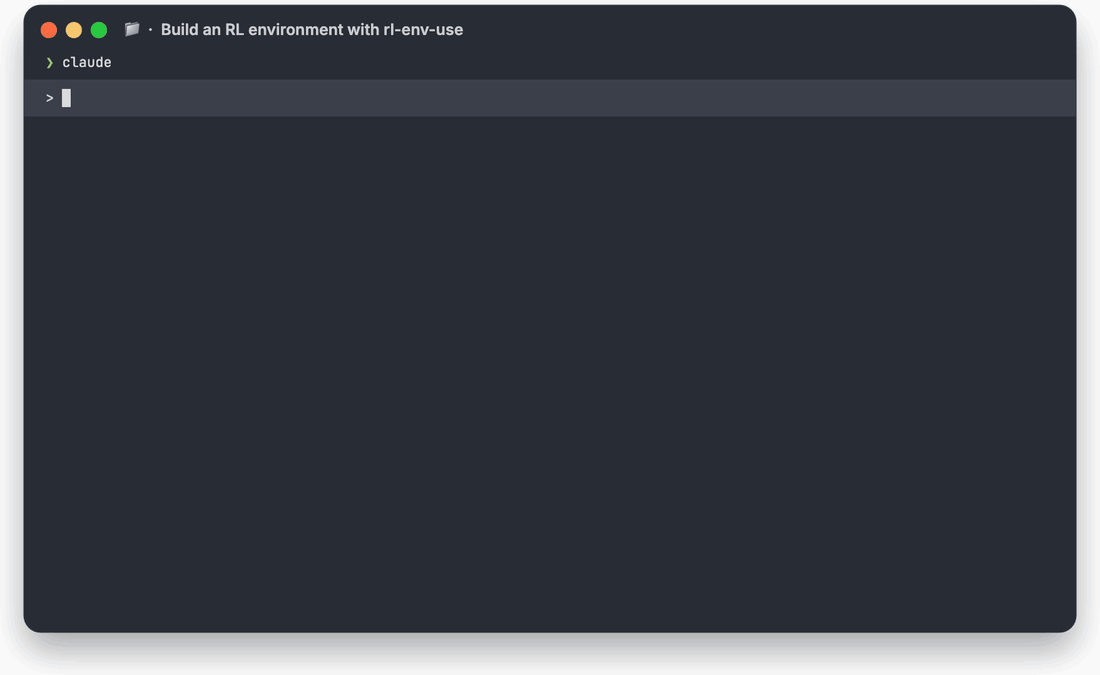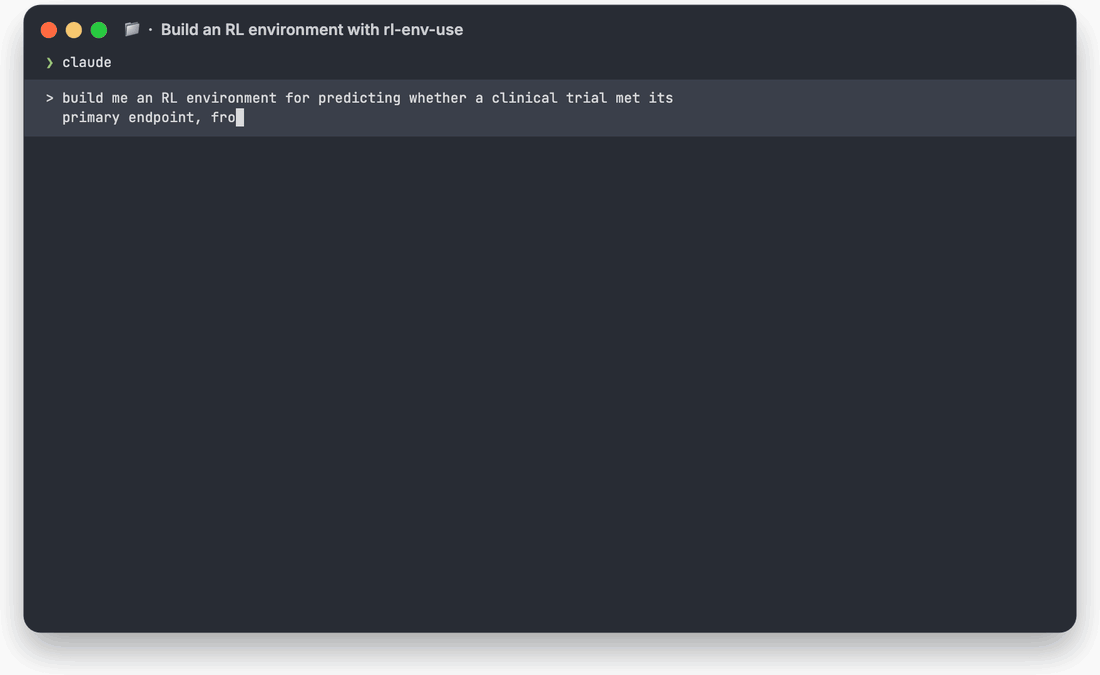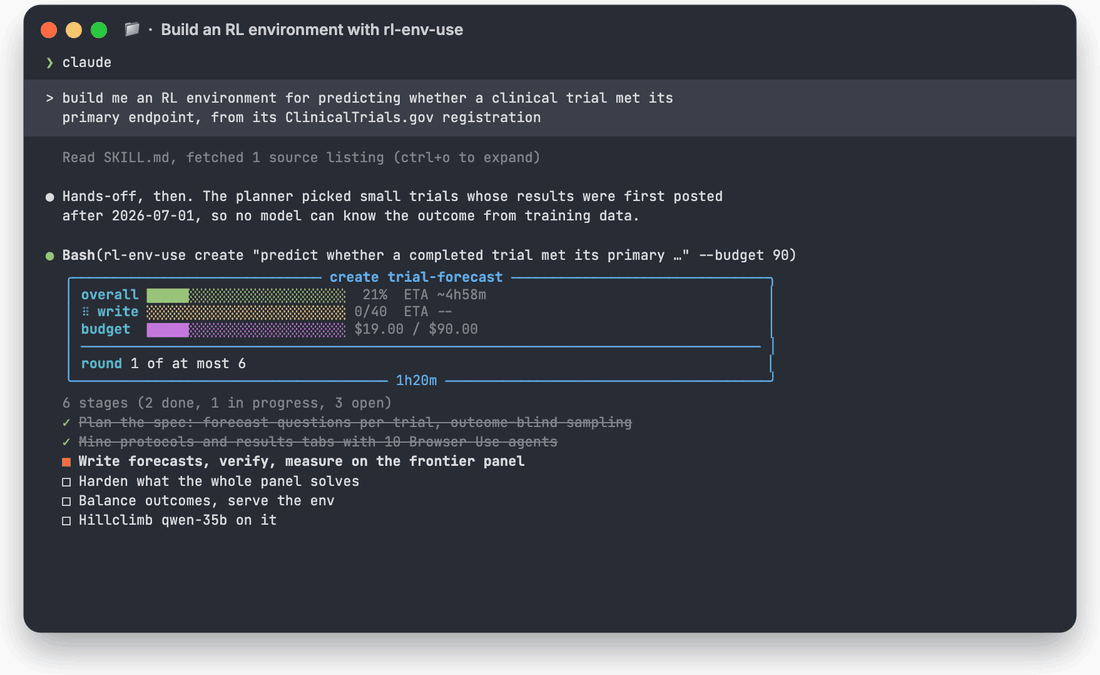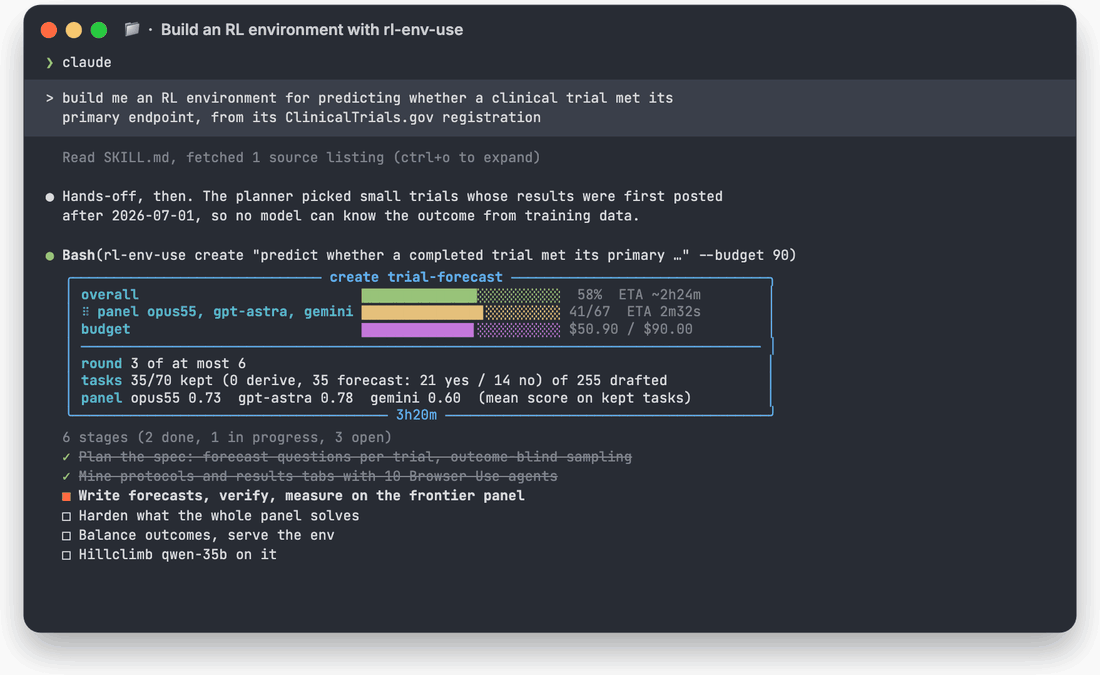
한 줄 설명으로 강화학습 연습장을 — Browser Use가 rl-env-use를 오픈소스로 공개했어요
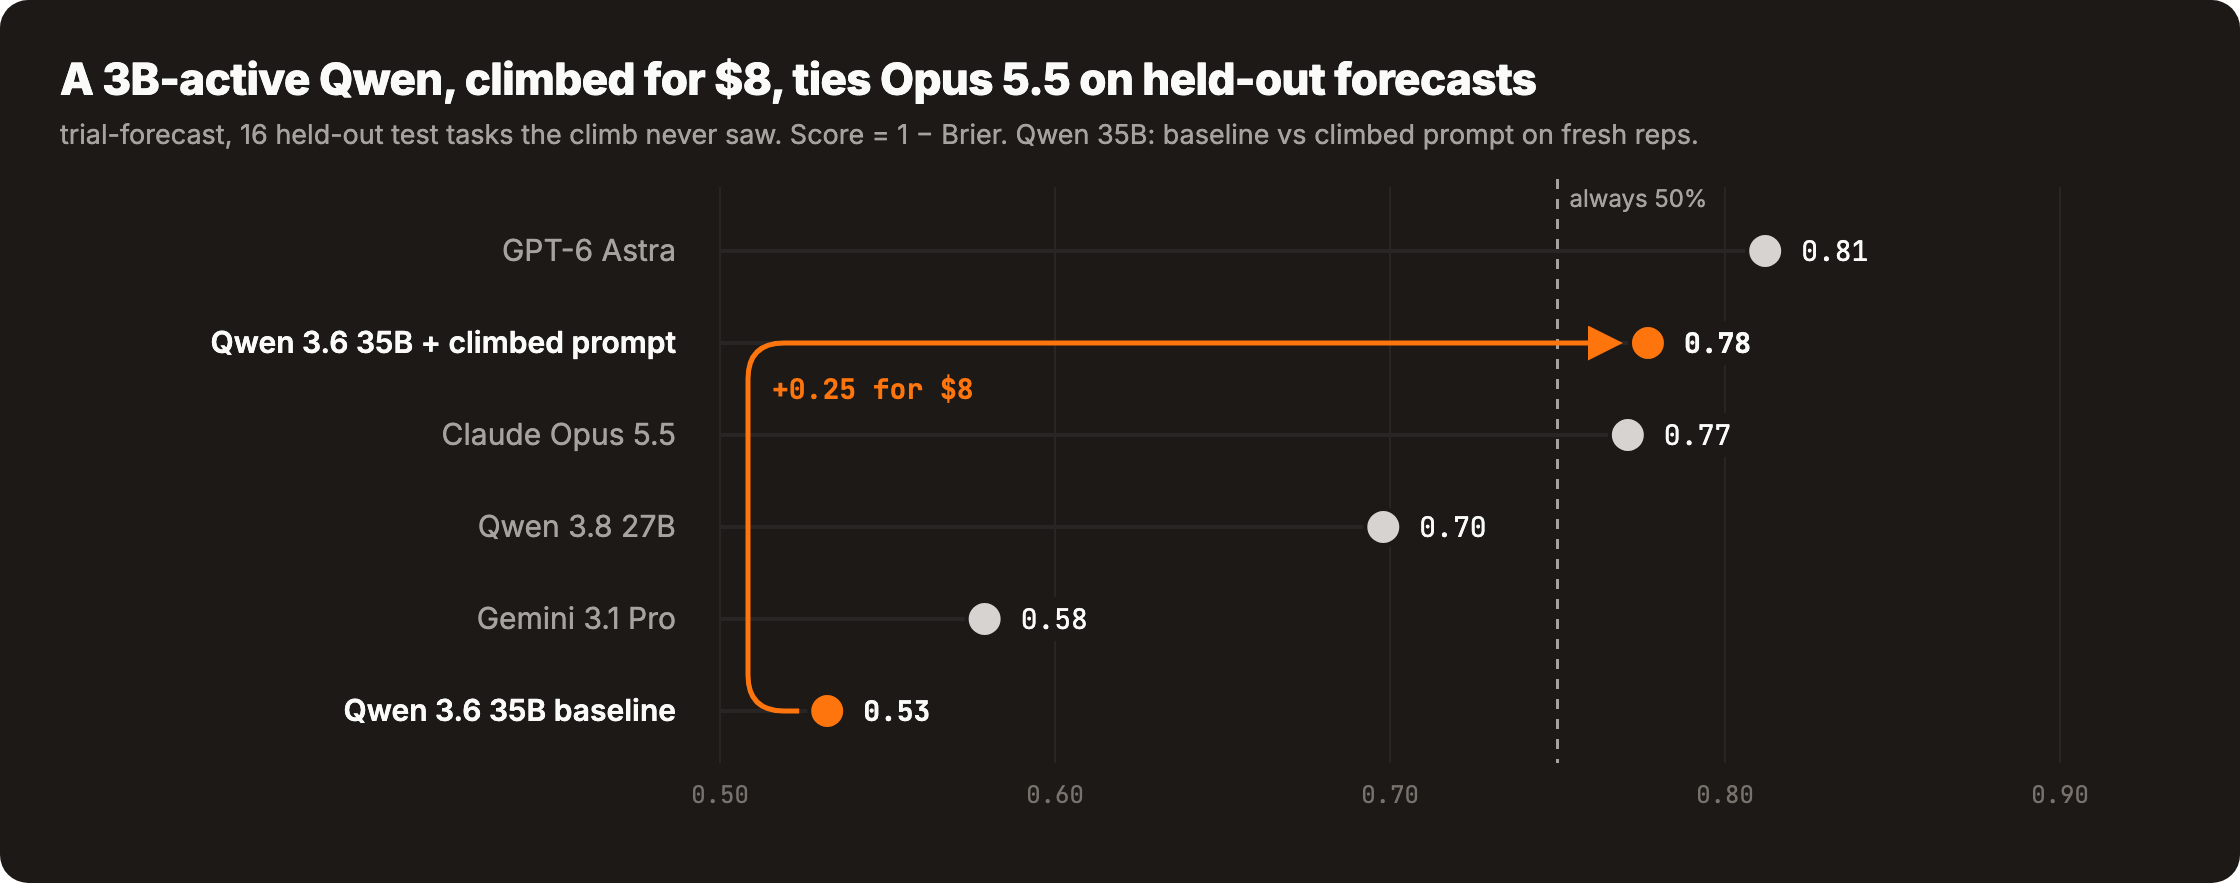
Browser Use가 10월 21일 GitHub에 rl-env-use를 공개했어요. 익히게 할 기술을 한 줄로 적으면, 브라우저 에이전트가 웹에서 실제 사례를 모아 강화학습(RL) 환경과 다듬은 프롬프트를 만들어 줘요. 원문 예시에선 Qwen 3.6 35B의 점수가 8달러짜리 프롬프트 다듬기로 0.53에서 0.78이 됐어요.
- rl-env-use는 Browser Use가 공개한 오픈소스 도구(MIT 라이선스)예요. 익히게 할 기술을 한 줄로 적으면, 검증된 강화학습 환경(모델이 풀고 채점받는 문제 모음)과 훈련할 모델에 맞게 다듬은(hillclimb) 프롬프트를 만들어 줘요.
- Anthropic의 'Automating eval design and hillclimbing' 작업 흐름을 바탕으로 하되, 문제를 Browser Use 에이전트가 웹에서 찾아온 실제 사례로 만든다는 점이 달라요. 답이 새어 나간 문제 · 모델이 외웠을 결과 · 애매한 문제는 걸러 내요.
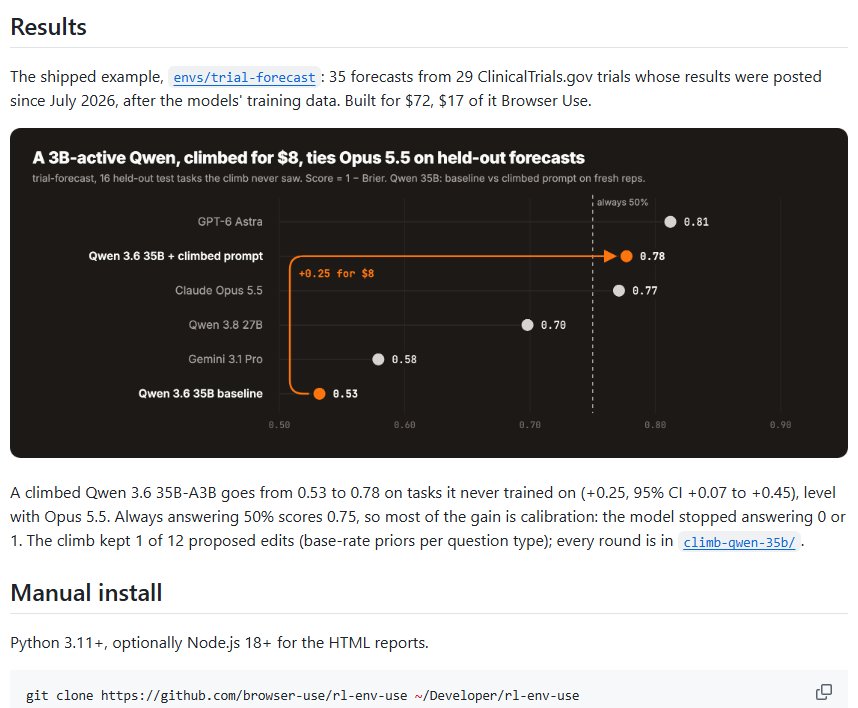
- 원문 예시(2026년 7월 이후 결과가 올라온 임상시험 29건, 예측 문제 35개, 만드는 데 72달러)에서, 프롬프트를 다듬은 Qwen 3.6 35B-A3B가 학습에 안 쓴 문제에서 0.53 → 0.78이 돼 Opus 5.5(0.77)와 비슷해졌어요. 다만 늘 50%로 답하기만 해도 0.75라서, 원문은 오른 점수 대부분이 '0이나 1로 단정하지 않게 된 것(보정)' 덕분이라고 적어요.
작은 오픈 모델을 특정 분야(임상시험 · 공시 · 유전 변이처럼 원문 예시에 나온 분야)에 맞춰 쓰고 싶을 때, 문제 모음 만들기 → 프롬프트 다듬기 → RL 훈련용 데이터 내보내기를 한 저장소에서 시험해 볼 수 있어요.
웹에서 실제 사례를 찾아 정답을 코드로 계산하고, 최신 모델들이 풀어 버린 문제는 더 어렵게 다시 쓰는 흐름이라, 손으로 평가 문제를 모으던 일을 줄여 볼 수 있어요. 다만 원문 그래프의 시험 문제가 16개라 신뢰 구간(+0.07 ~ +0.45)이 넓어요.
직접 모델을 훈련하지 않는다면 당장 쓸 일은 적어요. Browser Use · OpenRouter API 키가 필요하고 사용한 만큼 비용이 들어요(원문 예시는 환경 만들기에 72달러, 그중 Browser Use 17달러).
설치 3단계 · 라이선스 MIT · 비용: Browser Use · OpenRouter API 사용료(원문 예시 환경 72달러 + 프롬프트 다듬기 8달러)
1. Claude Code · Codex · OpenCode에 README의 'Setup prompt'를 그대로 붙여 넣으세요(install.md를 읽고 설치 · API 키 설정까지 해 줘요). 직접 하려면 README의 'Manual install'을 따르세요(Python 3.11 이상).
2. 환경 만들기(README 그대로): rl-env-use create "predict whether a completed trial met its primary endpoint from its registered protocol; ClinicalTrials.gov" --budget 40
3. 프롬프트 다듬기(README 그대로): rl-env-use climb envs/<name> --model qwen-35b
4. 따옴표 안의 한 줄을 내 분야의 기술 설명으로 바꿔 보세요. 전체 흐름과 파일 위치는 SKILL.md에 있어요.

특정 분야 질문에 답하는 작은 모델을 직접 운영한다면, 예산을 낮게 잡아 내 분야 문제 모음을 하나 만들어 보고 지금 쓰는 프롬프트가 몇 점인지부터 재 보면 좋을 것 같아요. API로 큰 모델만 쓰는 작업자에게는 당장 쓸 곳이 적어 보여요.
브라우저 자동화 에이전트를 만드는 Browser Use가 10월 21일 GitHub에 rl-env-use를 오픈소스(MIT 라이선스)로 공개했어요. README 첫 줄은 "RL environments for anyone and any domain(누구나, 어떤 분야든 쓰는 강화학습 환경)"이에요. 강화학습 환경은 모델이 문제를 풀고 채점을 받으며 나아지게 하는 문제 모음과 채점 규칙을 말해요.
무엇을 해 주나
익히게 할 기술을 한 줄로 적으면, 최신 모델도 다 풀지 못하는 검증된 환경과, 훈련할 모델에 맞게 다듬은(hillclimb, 조금씩 고쳐 가며 점수를 올리는 것) 프롬프트를 만들어 줘요. Anthropic이 9월 28일 올린 'Automating eval design and hillclimbing' 작업 흐름을 바탕으로 했고, 바꾼 점은 하나 — 문제를 Browser Use 에이전트가 웹에서 찾아온 실제 사례로 만든다는 거예요. README가 적은 기능은 이래요.
- 실제 사례 찾기: 에이전트가 자료(임상시험 계획서, 분기 보고서 10-Q)와 나중에 발표된 결과를 찾아요
- 어려운 문제 쓰기: 정답은 코드로 계산하고, 최신 모델 여러 개가 풀어 버린 문제는 더 어렵게 다시 써요
- 나쁜 문제 거르기: 답이 새어 나간 문제, 모델이 외웠을 결과, 애매한 문제를 빼요
- 프롬프트 다듬기: 학습용 · 시험용으로 나누고, 잡음 수준과 신뢰 구간을 따져 시스템 프롬프트를 고쳐요
- 내보내기: RL 훈련기에 넣을 데이터셋으로 내보내거나, 코드에서
Env로 바로 써요
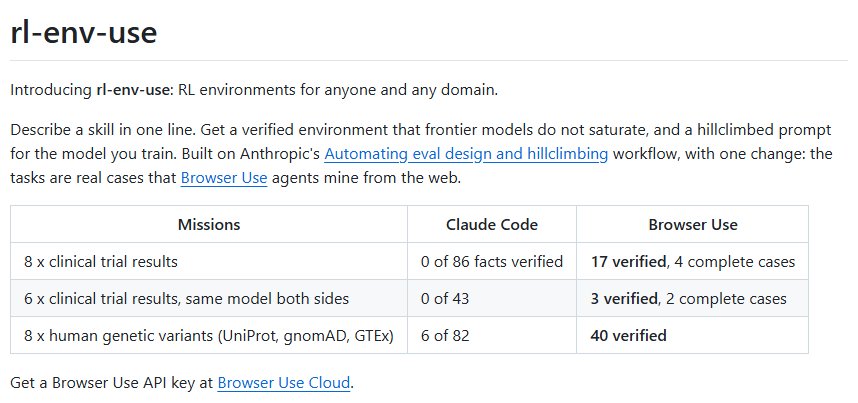
README 표에는 같은 일을 Claude Code와 Browser Use에 맡긴 비교가 있어요. 임상시험 결과 8건에서 Claude Code는 사실 86개 중 0개를 검증했고 Browser Use는 17개를 검증 · 완결 사례 4건을 모았어요. 사람 유전 변이(UniProt, gnomAD, GTEx) 8건에서는 Claude Code 82개 중 6개, Browser Use 40개 검증이었어요.
원문 예시: 임상시험 결과 예측
저장소에 들어 있는 예시 envs/trial-forecast는 2026년 7월 이후 ClinicalTrials.gov에 결과가 올라온 임상시험 29건으로 만든 예측 문제 35개예요. README는 모델들의 학습 자료 이후에 나온 결과라고 적어요. 이 환경을 만드는 데 72달러(그중 Browser Use 17달러)가 들었어요.
원문 그래프(학습에 안 쓴 시험 문제 16개, 점수 = 1 − Brier 점수)를 보면, Qwen 3.6 35B 기본 프롬프트는 0.53이었고, 8달러를 들여 프롬프트를 다듬은 뒤 0.78이 됐어요(+0.25, 95% 신뢰 구간 +0.07 ~ +0.45). 같은 그래프의 다른 모델은 GPT-6 Astra 0.81, Claude Opus 5.5 0.77, Qwen 3.8 27B 0.70, Gemini 3.1 Pro 0.58이에요. README는 이를 "Opus 5.5와 비슷한 수준(level with)"이라고 적어요.
다만 원문도 짚듯이 늘 50%라고만 답해도 0.75예요. 그래서 오른 점수의 대부분은 보정(calibration) — 모델이 0이나 1로 단정하던 버릇을 버린 것 — 이라고 해요. 제안된 프롬프트 수정 12개 중 남은 건 1개(질문 종류별 기본 확률을 알려 주는 것)였고, 모든 단계 기록은 climb-qwen-35b/ 폴더에 있어요.
쓰려면
Browser Use API 키와 OpenRouter API 키가 필요해요. README는 Claude Code · Codex · OpenCode에 붙여 넣는 설치 프롬프트와, 직접 설치하는 방법(Python 3.11 이상, HTML 보고서는 Node.js 18 이상 선택)을 함께 안내해요.