의료 질문에 길게 답하면 점수가 깎여요 — HealthBench Professional 원점수 1위 Claude Opus 5.5, 길이 보정 뒤 6위
벤치마크 사이트 Artificial Analysis가 OpenAI의 건강 대화 평가 HealthBench와 HealthBench Professional을 직접 돌린 리더보드를 열었어요. 답이 2,000자보다 길면 점수를 깎는 '길이 보정 점수'로 순위를 매기자 순위가 크게 바뀌었어요.
- Artificial Analysis가 OpenAI의 HealthBench(건강 대화 5,000개)와 HealthBench Professional(의료진 대화 525개)을 직접 돌려 14개 모델 리더보드를 공개했어요.
- 순위는 '길이 보정 점수'예요. 답이 2,000자보다 길면 500자마다 Professional은 1.47%p, HealthBench는 2.99%p를 빼고 짧으면 그만큼 더해요(추론 과정은 길이에 안 셈).
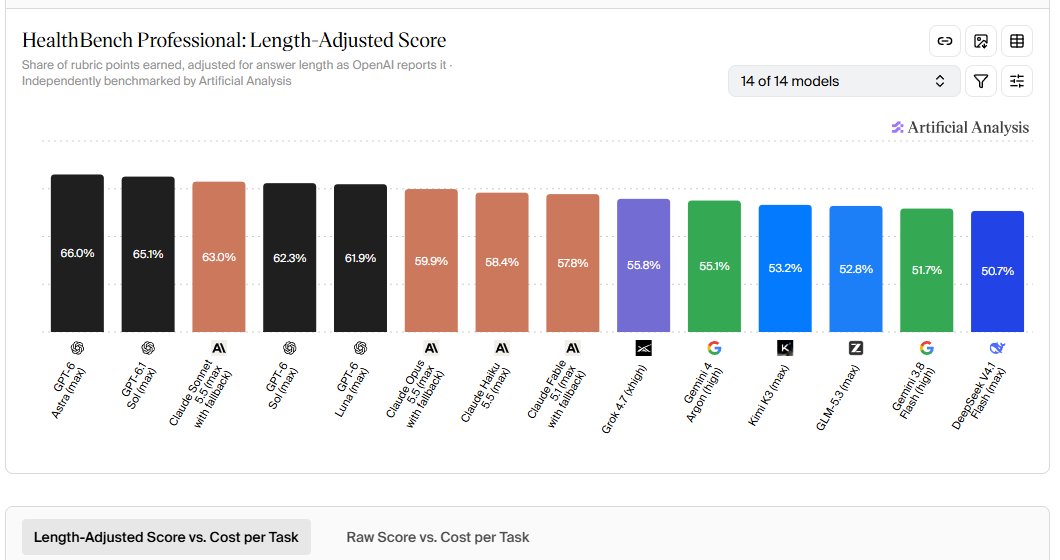
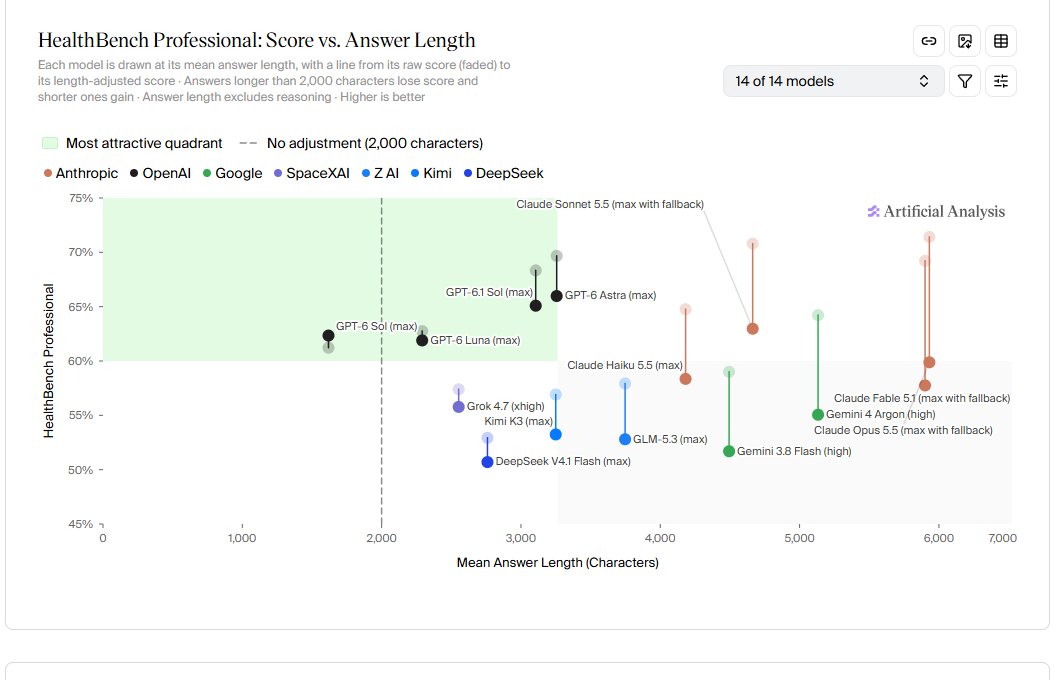
- Professional 길이 보정 1위는 GPT-6 Astra(max) 66.0%예요. 원점수 1위였던 Claude Opus 5.5(max, fallback)는 71.4%였지만 평균 답이 5,931자라 59.9%로 6위가 됐어요(원문 차트 데이터 기준).
건강 · 의료 상담 기능에 넣을 모델을 고를 때, 원문의 'Score vs. Answer Length' 차트에서 원점수와 길이 보정 점수 차이를 같이 보고 후보를 좁혀 볼 수 있어요. 원문은 상담(consult) · 작성(writing) · 리서치(research)별 점수도 따로 보여 줘요.
건강 정보 글 초안을 AI로 받을 때, 같은 모델이라도 답이 길수록 이 평가에선 점수가 깎인다는 점을 참고해 '2,000자 안으로' 같은 길이 지시를 넣어 볼 수 있어요. 의료 내용은 전문가 확인이 따로 필요해요.
모델 비교표를 볼 때 '원점수'와 '보정 점수' 중 무엇으로 줄 세웠는지 먼저 확인하는 습관을 들이기 좋은 사례예요. 같은 14개 모델인데 기준에 따라 1위가 달라져요.
1. 원문 리더보드(artificialanalysis.ai/evaluations/healthbench-professional)를 열어요.
2. 'Score vs. Answer Length' 차트에서 흐린 점(원점수)과 진한 점(길이 보정 점수) 사이 선이 긴 모델을 찾아요.
3. 'Score by Use Case, Type and Difficulty'에서 내 쓰임(상담 · 작성 · 리서치)에 맞는 칸을 봐요.
4. 후보 모델에 내 실제 질문을 넣어 보고, 답 길이와 내용을 직접 확인해요.

AI 답을 받아 쓰는데 늘 너무 길다고 느꼈다면, 이 차트로 쓰는 모델의 평균 답 길이가 어느 쪽인지 먼저 확인해 보면 좋을 것 같아요. 다만 길이 보정 방식은 OpenAI가 정한 한 가지 기준이라, 짧은 답이 늘 낫다는 뜻으로 읽지는 않는 게 좋을 것 같아요.
벤치마크 사이트 Artificial Analysis가 OpenAI의 건강 대화 평가 HealthBench와 HealthBench Professional을 직접 돌린 리더보드를 열었어요. 두 페이지 모두 "모든 평가는 Artificial Analysis가 독립적으로 진행했다"고 적었고, 모델 14개를 비교해요.
두 평가는 무엇을 재나요
- HealthBench: 건강 대화 5,000개. 대화마다 의사가 쓴 루브릭(채점 기준표)이 있고, 모델의 마지막 답을 그 기준으로 채점해요. 기준 항목은 -10점에서 +10점이라 0점 아래도 나올 수 있어요. 채점 모델은 OpenAI 원래 구현처럼 GPT-4.1이에요.
- HealthBench Professional: 의료진 대화 525개. 상담(consult) · 작성(writing) · 리서치(research)로 나뉘고, 레드팀 대화와 OpenAI가 '어려움'으로 표시한 대화가 들어 있어요. 채점 모델은 GPT-5.4(low)이고 문제마다 4번 돌려 평균을 내요. 원문은 이 평가의 논문(arXiv, 2026년 4월 30일 제출)도 함께 걸었어요.
- 재시도 뒤에도 실패한 답은 0점이에요.
'길이 보정 점수'가 순위를 바꿨어요
리더보드는 원점수와 길이 보정 점수를 둘 다 내고, 순위 차트는 길이 보정 점수로 그려요. 답이 2,000자보다 길면 점수를 깎고 짧으면 더해요. 원문은 이것이 OpenAI가 보고하는 값이라고 적었어요. 추론 과정은 길이에 세지 않아요.
- HealthBench Professional: 2,000자에서 500자 늘 때마다 1.47%p 빼요(짧으면 같은 만큼 더해요).
- HealthBench: 500자마다 2.99%p예요.
아래 숫자는 원문 페이지의 차트 데이터(원점수 · 길이 보정 점수 · 평균 답 길이)에서 그대로 읽은 값이에요.
HealthBench Professional 결과
- 길이 보정 순위: GPT-6 Astra(max) 66.0%, GPT-6.1 Sol(max) 65.1%, Claude Sonnet 5.5(max, fallback) 63.0%, GPT-6 Sol(max) 62.3%, GPT-6 Luna(max) 61.9%, Claude Opus 5.5(max, fallback) 59.9%.
- 원점수 1위는 Claude Opus 5.5(max, fallback) 71.4%였어요. 평균 답 길이가 5,931자로 14개 모델 중 가장 길어 보정 뒤 59.9%(6위)가 됐어요.
- Claude Fable 5.1(max, fallback)도 69.2% → 57.8%(평균 5,901자), Gemini 4 Argon(high)은 64.2% → 55.1%(평균 5,133자)로 내려갔어요.
- 반대로 GPT-6 Sol(max)은 평균 1,619자로 2,000자보다 짧아 61.2% → 62.3%로 올랐어요.
HealthBench 결과
- 길이 보정 순위: Claude Sonnet 5.5(max, fallback) 62.1%, DeepSeek V4.1 Flash(max) 60.9%, GPT-6.1 Sol(max) 58.5%.
- 가장 많이 내려간 건 Gemini 4 Argon(high)으로 60.0% → 49.1%(평균 3,837자)예요.
- 가장 많이 오른 건 GPT-6 Sol(max)으로 48.2% → 54.2%(평균 1,008자)예요.
참고: 원문은 길이 보정 점수를 "OpenAI가 보고하는 값"이라고 설명할 뿐, 긴 답이 의학적으로 더 나쁘다고 결론 내리지는 않았어요. 사용처 · 유형 · 난이도별 점수는 원점수로 보여 줘요. 원문 페이지에서 답 하나당 비용 · 출력 토큰 · 걸린 시간 차트도 볼 수 있어요.