AI 답 앞뒤의 검문소 여러 개를 한 번에… 공개 모델 Vela 2.0, 4가지 크기로 나왔어요
vLLM Semantic Router 팀이 '어느 모델로 보낼지·안전한지·개인정보가 있는지·지어낸 말인지'를 한 번의 호출로 묻는 공개 모델 묶음 Vela 2.0을 내놓았어요. 자체 서버에서 AI를 굴리는 개발자용 기반 기술이에요.
- Vela 2.0은 요청을 어느 모델로 보낼지(분야), 안전한지, 개인정보(PII)가 들어 있는지, 답에 근거 없는 말(환각)이 있는지를 한 번의 호출로 답하는 공개 모델이에요. 크기는 0.3B·0.8B·4B·9B 네 가지예요.
- 이전 Vela 1.0은 검사 하나마다 모델이 하나씩 필요했어요. 라우터의 기본 검사는 Vela 1.0 전용 모델 아홉 개를 썼는데, 10월 7일부터 Vela 2.0이 답할 수 있는 검사는 가장 작은 0.3B 모델이 기본으로 맡아요.
- 가중치·코드·문서는 Apache-2.0이고 Hugging Face에서 받아요. 다만 성적은 모두 만든 팀이 직접 잰 것이고, CPU에서는 이전 모델보다 응답이 느리다는 기록(중간값 14~15ms → 127~128ms)이 공식 저장소에 올라와 있어요.
자체 서버에서 여러 AI 모델 앞에 라우터(요청을 알맞은 모델로 보내는 교통정리 프로그램)를 두고 있다면, 검사용 모델 여러 개를 받아 띄우던 것을 0.3B 하나로 줄일 수 있는지 시험해 볼 만해요. CPU 속도는 꼭 직접 재 보세요.
ChatGPT·Claude 같은 서비스를 쓰기만 한다면 당장 할 일은 없어요. '답을 내보내기 전에 개인정보와 지어낸 말을 걸러 주는 단계가 따로 있다'는 구조만 알아 두면 돼요.
고객 문의나 댓글에 자동으로 답하는 도구를 직접 만들고 있다면, 답을 보내기 전에 이메일·전화번호 같은 개인정보가 섞였는지 확인하는 단계에 0.3B 모델을 시험해 볼 수 있을 것 같아요. 그런 도구를 만들지 않는다면 지금은 읽고 넘어가도 괜찮아 보여요.
오픈소스 프로젝트 vLLM Semantic Router 팀이 10월 6일(현지 시간) Vela 2.0을 공개했어요. AI에게 요청이 들어가기 전과 답이 나가기 전에 거치는 검문소 여러 개를 모델 하나로 합친 공개 모델 묶음이에요.
무엇을 하는 모델인가 — 글을 써 주는 AI가 아니라 판정만 하는 작은 모델이에요. '이 요청은 어느 분야인가', '안전한가', '개인정보(PII, 이름·이메일처럼 사람을 알아볼 수 있는 정보)가 들어 있나', '답에 근거 없는 말(환각)이 있나' 같은 질문을 한 번의 호출에 함께 넣으면 답과 확률을 돌려줘요. 개인정보나 근거 없는 문장은 글의 몇 번째 글자부터 몇 번째까지인지 위치까지 짚어 줘요. 질문 모양은 다섯 가지(보기 고르기, 예/아니오 확률, 단계 점수, 구간 찾기, 여러 개 고르기)예요.
무엇이 하나로 합쳐졌나 — 원문은 이전 세대를 이렇게 설명해요. "Vela 1.0 needed one model per signal."(Vela 1.0은 검사 하나에 모델 하나가 필요했다) 공식 저장소에 따르면 라우터(요청을 알맞은 모델로 보내는 교통정리 프로그램)의 기본 검사는 Vela 1.0 전용 모델 아홉 개(Safety, Hazard, Guard, Domain, PII, FactCheck, Halu, Feedback, Modality)를 따로 내려받아 썼어요. 10월 7일에 Vela 2.0이 답할 수 있는 검사는 0.3B 모델이 기본으로 맡도록 바뀌었고, 답하지 못하는 검사는 기존 모델을 그대로 써요.
네 가지 크기 — 0.3B(3억 700만 파라미터, 입력 8,192토큰, CPU에서 돌아감), 0.8B(7억 5,600만), 4B(42억), 9B(79억, 뒤의 셋은 입력 16,384토큰)예요. 파라미터는 모델의 크기를 나타내는 숫자예요. 큰 세 모델은 미리 정해 두지 않은 항목도 글에서 찾아내는 기능이 더 들어 있어요.
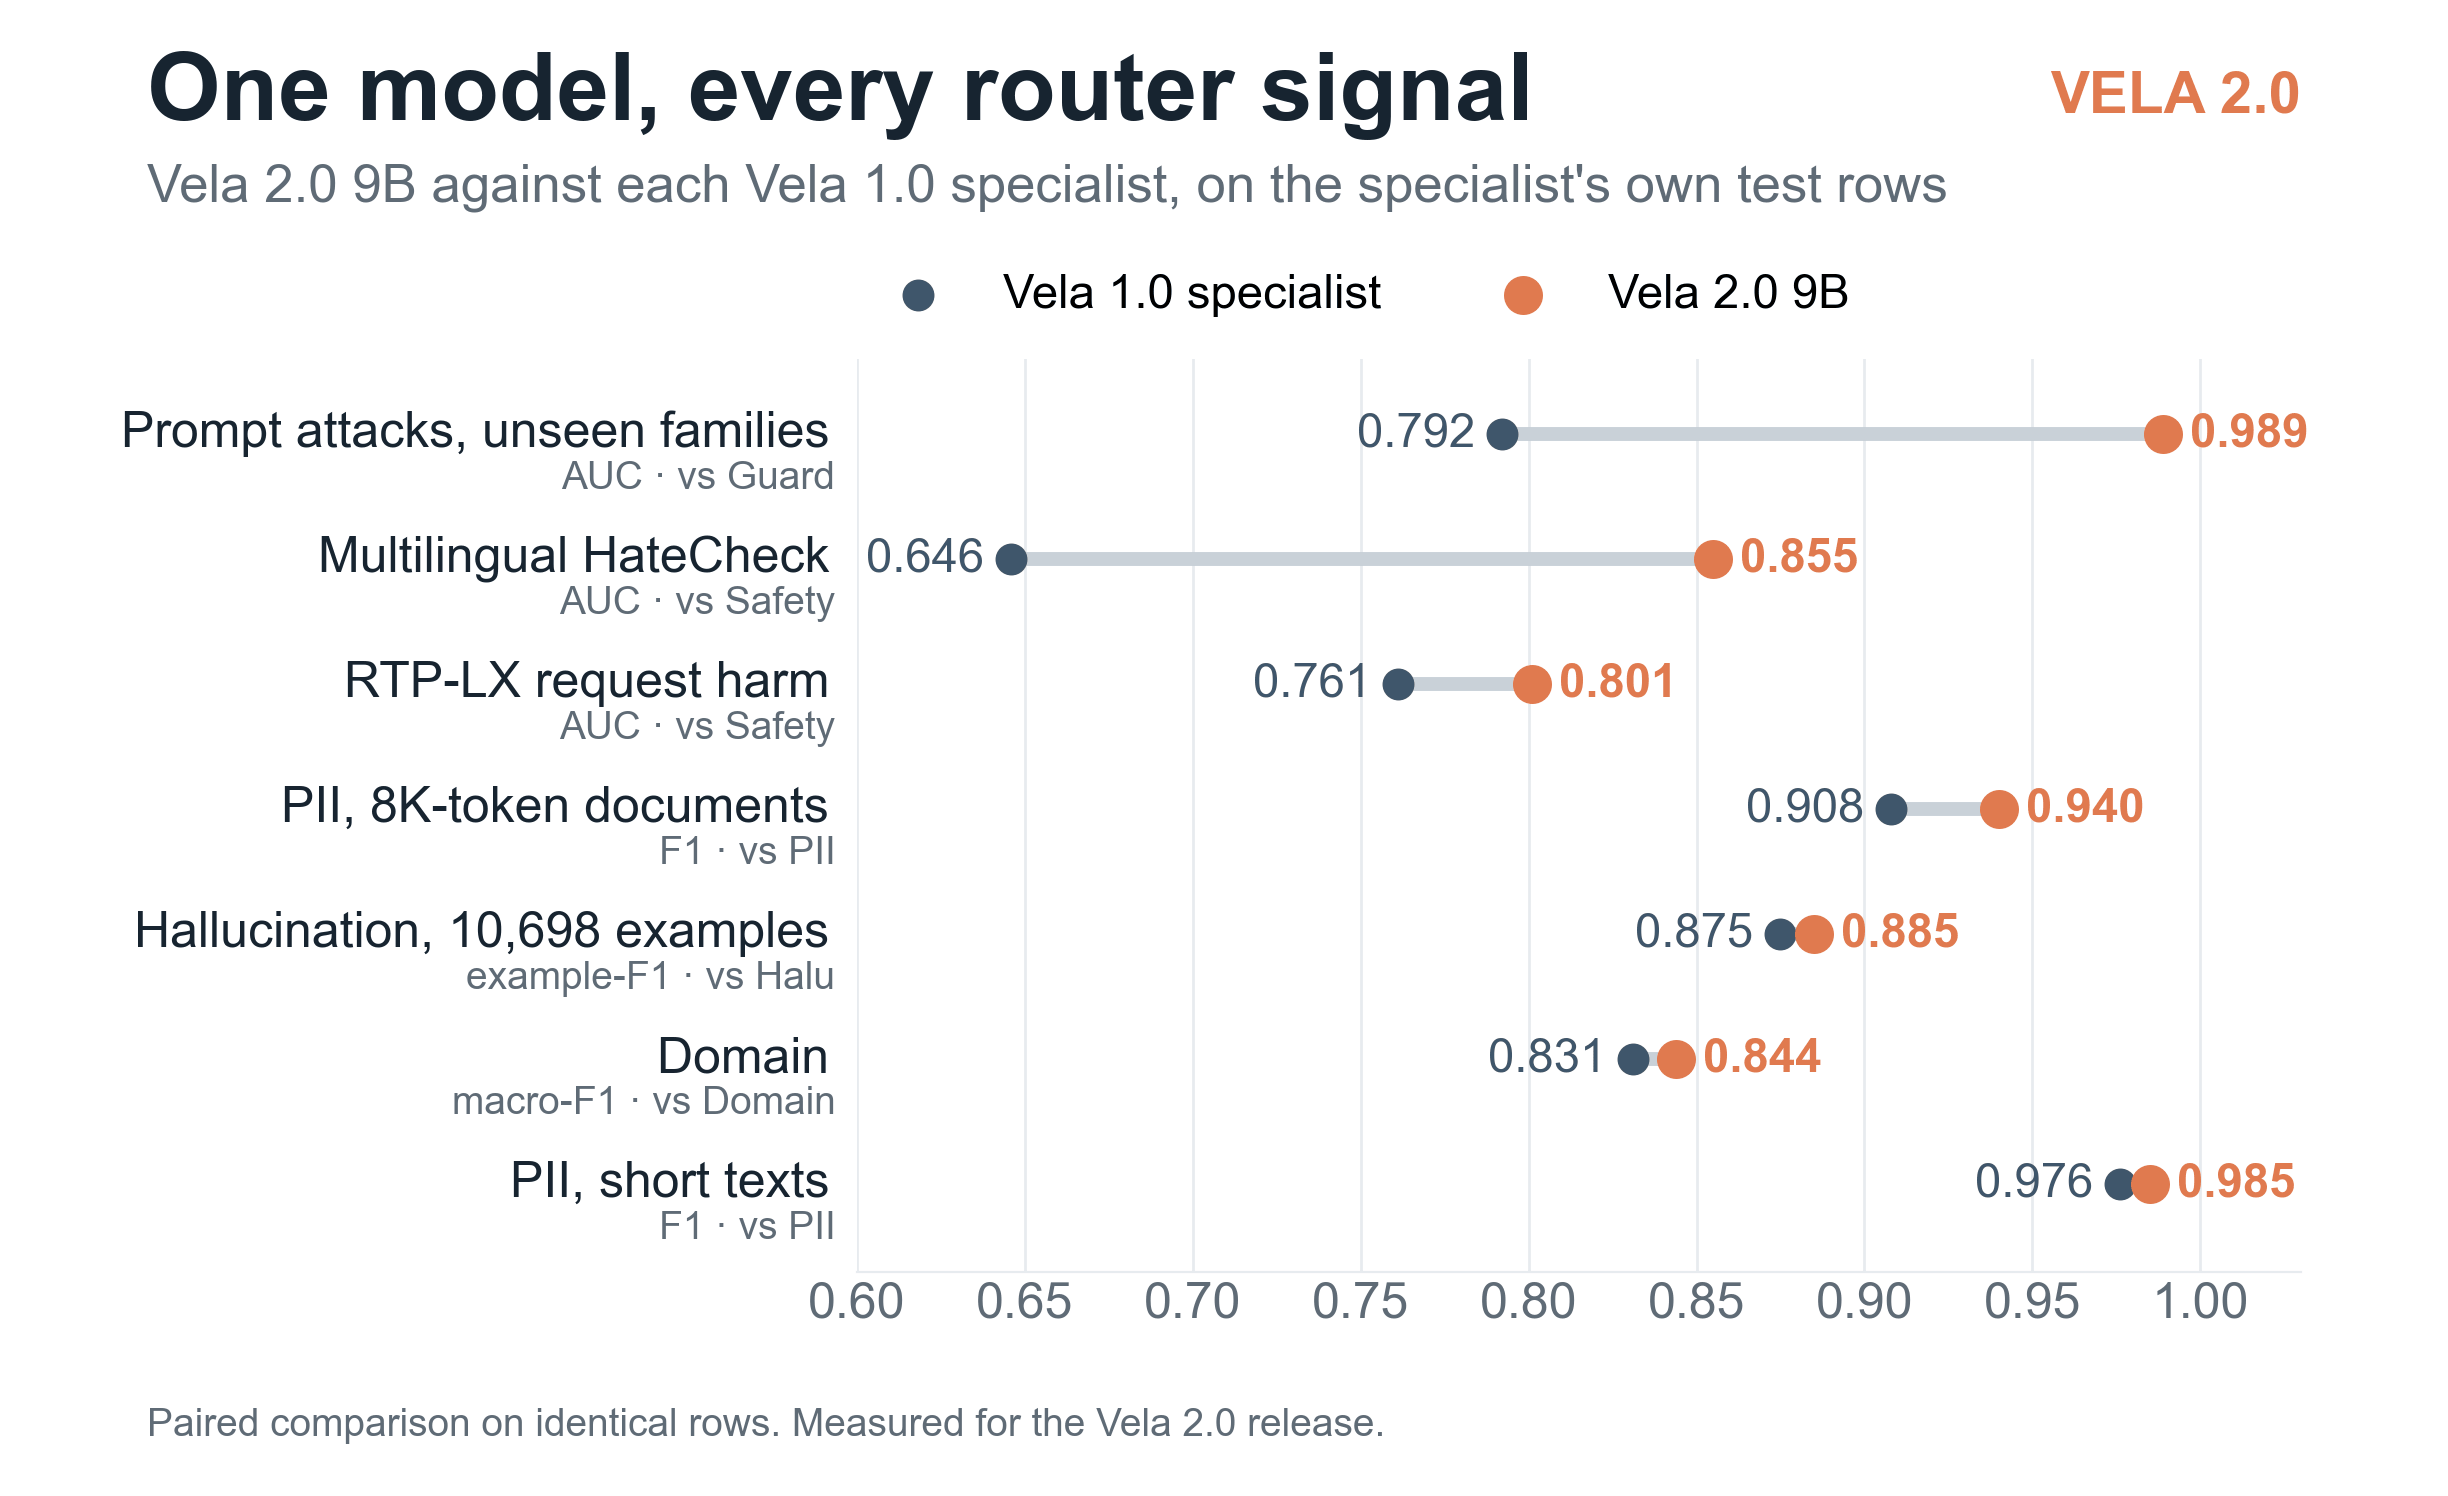
성적 (만든 팀이 직접 잰 값) — 가장 큰 9B를 Vela 1.0 전용 모델들과 같은 시험 문제로 비교했어요. 처음 보는 유형의 프롬프트 공격(AI를 속이려는 입력)을 가려내는 점수(AUC, 1에 가까울수록 좋음)는 0.792 → 0.989, 여러 언어의 혐오 표현은 0.646 → 0.855예요. 긴 문서의 개인정보 찾기는 0.908 → 0.940, 환각 찾기는 0.875 → 0.885, 분야 나누기는 0.831 → 0.844로 차이가 작아요. 검사를 모두 담은 요청 한 번은 A40 GPU에서 0.3B가 0.09초, 9B가 0.60~0.71초 걸려요.
다만 — 가장 작은 0.3B는 유해 요청 판정(0.761 → 0.728)과 환각 찾기(0.875 → 0.848)에서 이전 전용 모델보다 낮게 나왔어요. CPU 속도도 숙제예요. 공식 저장소 기록에는 같은 검사 네 가지를 CPU 12코어에서 돌렸을 때 응답 시간 중간값이 Vela 1.0은 14~15ms, Vela 2.0 0.3B는 127~128ms로 적혀 있고, 이를 줄이는 작업이 진행 중이에요. 이름 같은 항목을 자유롭게 뽑아내는 시험에서는 9B가 43.5점으로 다른 공개 모델 GLiFormer-large(63.6점)보다 낮아요. 논문은 아직 나오지 않았어요.
라이선스와 받는 곳 — 가중치·코드·문서는 Apache-2.0(상업적으로도 쓸 수 있는 공개 라이선스)이고 Hugging Face의 Vela 2.0 모음에서 네 모델을 받을 수 있어요. 0.3B의 토크나이저(글을 토큰으로 자르는 부품)에는 Gemma 이용 약관이 따로 붙고, 학습 데이터는 각자의 라이선스를 따라요.
X 게시물 보기 · https://x.com/vllm_project/status/2107690067619930450