Claude Haiku 5.5 공개: 10만 토큰 이하 요청은 Haiku 4.5의 10분의 1 값, 평균으로는 약 75% 싸져요
Anthropic이 가장 작은 모델 Haiku를 새로 내놨어요. 입력 100만 토큰당 $0.10부터 시작하고, Haiku 중 처음으로 추론 강도(effort)를 고를 수 있어요. 다만 프롬프트가 10만 토큰을 넘으면 값이 5배가 되고, 어려운 코딩은 여전히 Sonnet 5.5가 앞서요.
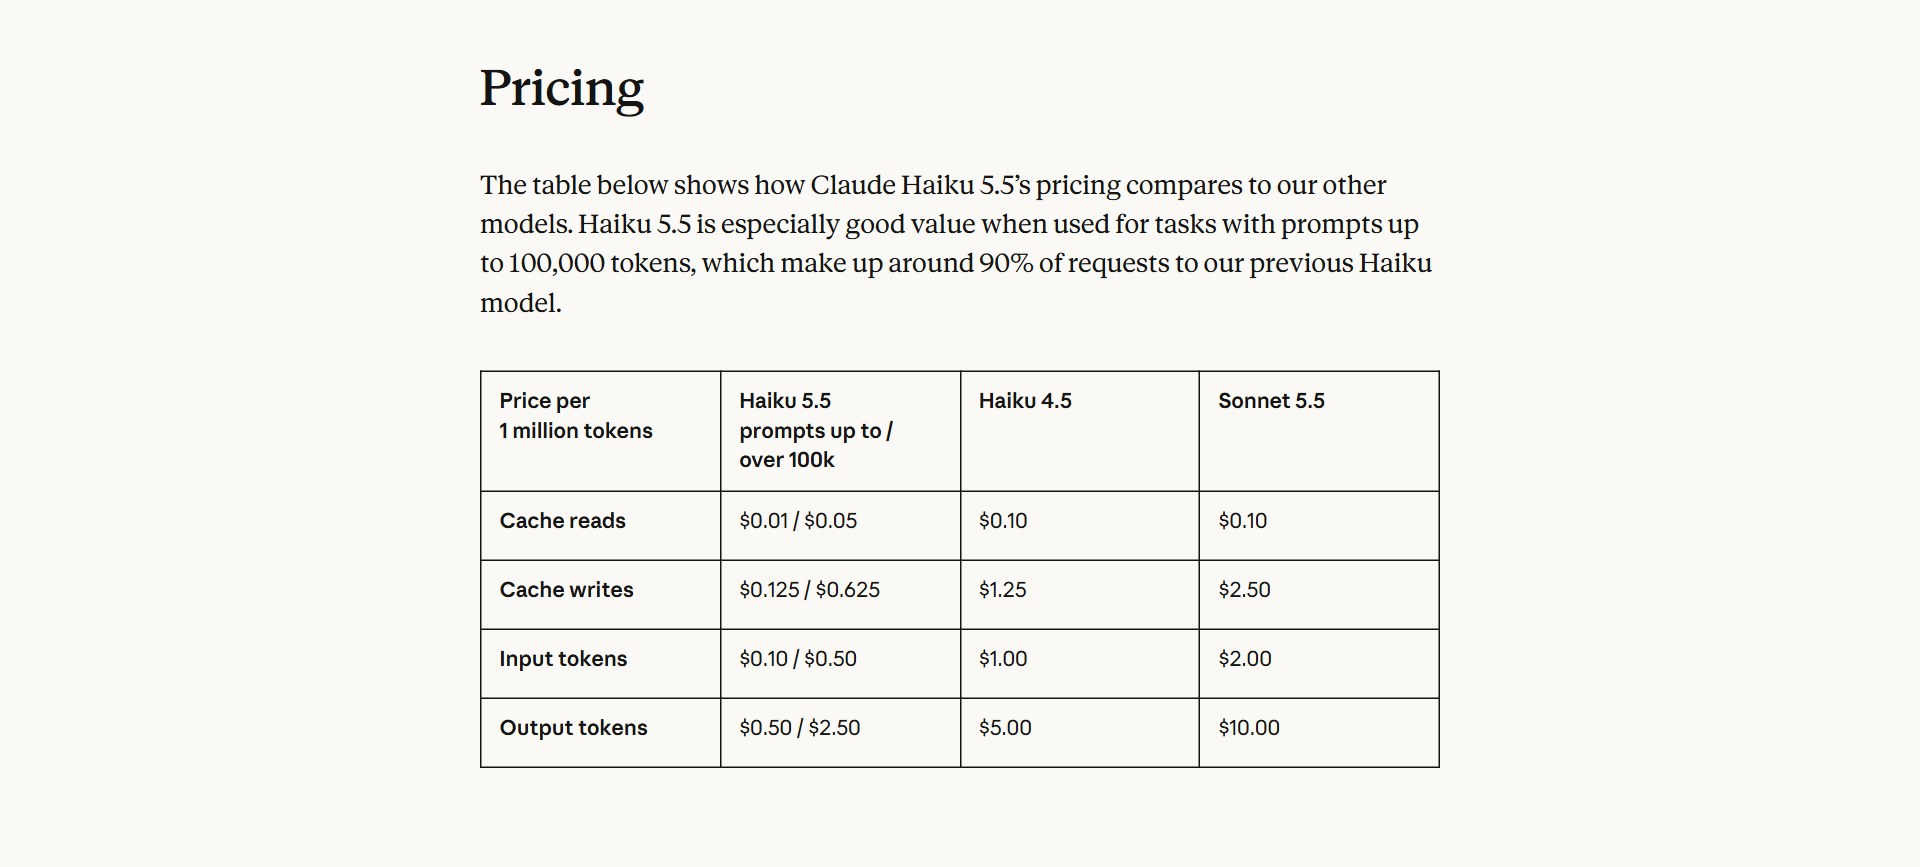
- 프롬프트가 10만 토큰 이하면 입력 $0.10·출력 $0.50(100만 토큰당)이에요. Haiku 4.5($1.00·$5.00)의 10분의 1이에요. 10만 토큰을 넘는 요청은 $0.50·$2.50으로 Haiku 4.5의 절반이에요. Anthropic은 평균으로 약 75% 싸진다고 밝혔어요.
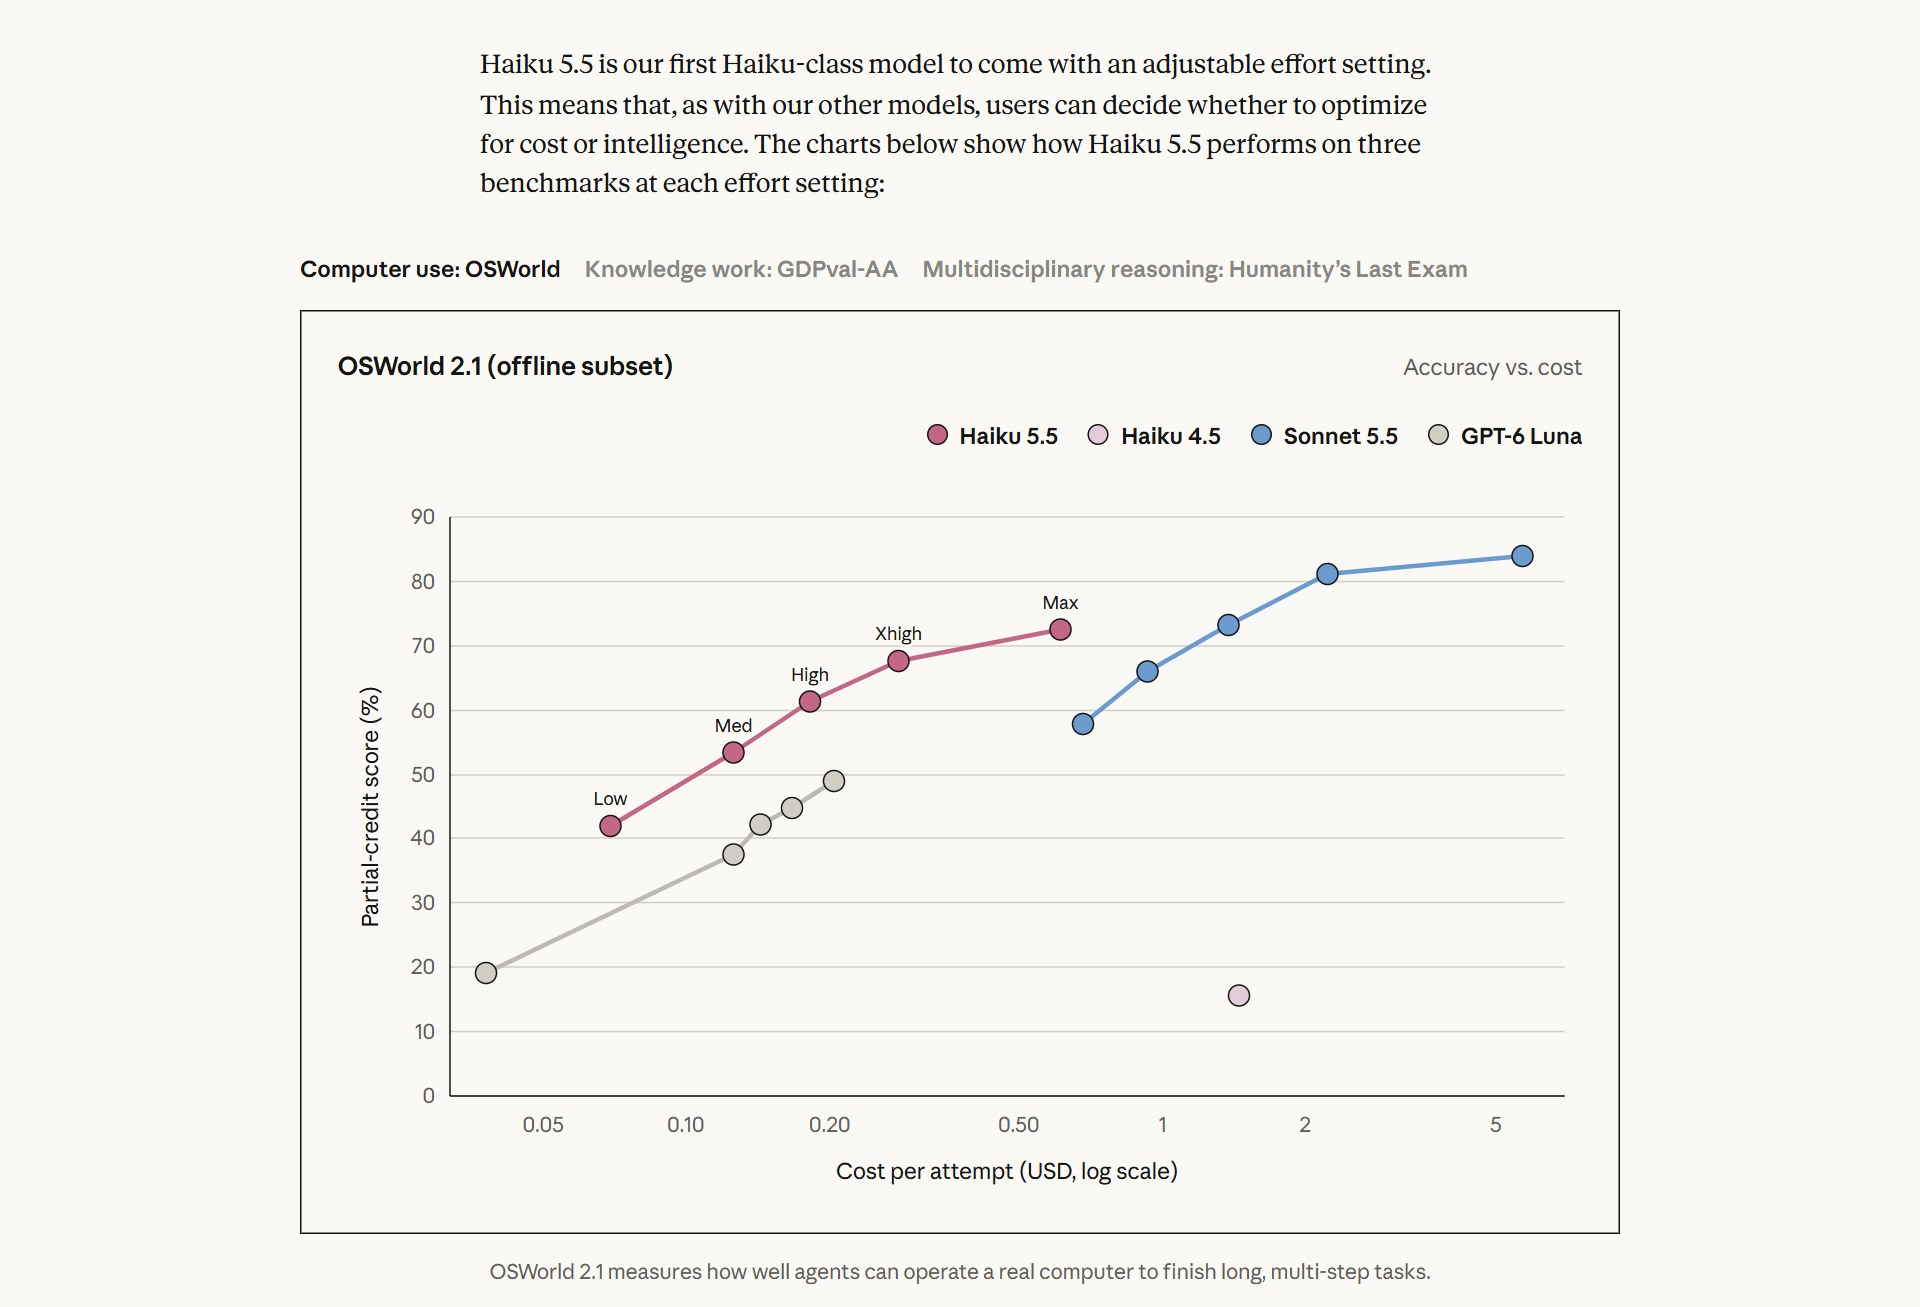
- Haiku 중 처음으로 추론 강도(effort, 얼마나 깊이 생각할지)를 Low부터 Max까지 고를 수 있어요. 문맥 창은 100만 토큰, 최대 출력은 12만 8천 토큰이에요. 컴퓨터 조작 시험 OSWorld 2.1에서 72.4%로 Haiku 4.5(15.7%)를 크게 앞섰어요(회사 발표 값).
- 어려운 코딩은 Sonnet 5.5가 여전히 앞서요(Terminal-Bench 4.0에서 Sonnet 5.5 70.6%, Haiku 5.5 39.2%). Anthropic도 Haiku 5.5는 요약·분류·보조 에이전트처럼 범위가 좁은 일에 맞다고 적었어요. 같은 날 Sonnet 5.5의 캐시 읽기 값도 절반으로 내렸어요.
분류·요약·추출처럼 짧은 요청을 많이 보내는 스크립트라면 모델 ID를 claude-haiku-5-5로 바꿔 같은 입력으로 결과를 비교해 볼 만해요. 프롬프트가 10만 토큰 이하일 때 입력 $0.10·출력 $0.50이에요. 다만 같은 글이 Haiku 4.5보다 토큰으로 약 30% 더 많이 세어지니 실제 청구액으로 확인하세요.
댓글 수백 개를 주제별로 나누기, 영상 자막 요약, 제목 후보 수십 개 뽑기 같은 반복 작업을 API로 돌릴 때 비용 부담이 줄어요. 한 번에 넣는 양을 10만 토큰 아래로 나누면 싼 구간 값이 적용돼요.
큰 모델이 계획과 어려운 수정을 맡고, Haiku 5.5는 파일 찾기·로그 요약 같은 보조 에이전트로 붙이는 구성이 Anthropic이 권하는 쓰임이에요. 복잡한 코딩 전체를 맡기기엔 Sonnet 5.5·Opus 5.5가 낫다고 Anthropic이 직접 적었어요.
이번 주부터 매달 API 크레딧이 나와요(Max 5x $100, Max 20x $200, Team 최대 $500). 구독만 하고 API는 안 써 봤다면 이 크레딧으로 작은 도구를 만들어 볼 수 있어요.
1) Claude Console(platform.claude.com)에서 API 키 만들기
2) 요청의 model 값을 claude-haiku-5-5로 바꾸기. effort는 기본값 medium으로 시작
3) temperature·top_p·top_k는 빼기 (기본값이 아니면 400 오류가 난다고 문서에 적혀 있어요)
4) 프롬프트 한 건을 10만 토큰 아래로 유지하기. 넘으면 그 요청은 5배 요금($0.50·$2.50)이에요
5) 결과가 부족하면 effort를 high로 올려 보고, 그래도 부족하면 Sonnet 5.5로
댓글 분류·자막 요약·제목 후보 뽑기처럼 짧고 자주 도는 자동화 작업을 Haiku 5.5로 옮겨 보면 좋을 것 같아요. 다만 요청 하나가 10만 토큰을 넘으면 값이 5배가 되니, 긴 자료는 나눠서 넣는 쪽이 유리해 보여요.
Anthropic이 10월 7일(현지 시각) Claude Haiku 5.5를 공개했어요. Haiku는 Claude 가운데 가장 작고 빠른 모델이에요. Anthropic은 이번 모델을 "지금까지 낸 작은 모델 중 가장 싸고, 가장 빠르고, 가장 유능하다"고 소개했어요. 요약, 분류, 데이터베이스 조회처럼 짧고 반복되는 일을 많이 처리하는 용도로 만들었다고 해요.
X 게시물 보기 · https://x.com/claudeai/status/2107894039626277339
가격: 10만 토큰이 기준선이에요
값이 프롬프트 길이에 따라 두 구간으로 나뉘어요. Anthropic은 예전 Haiku로 들어온 요청의 약 90%가 10만 토큰 이하였다고 밝혔어요.
| 100만 토큰당 | Haiku 5.5 10만 이하 / 초과 | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|
| 입력 | $0.10 / $0.50 | $1.00 | $2.00 |
| 출력 | $0.50 / $2.50 | $5.00 | $10.00 |
| 캐시 읽기 | $0.01 / $0.05 | $0.10 | $0.10 |
| 캐시 쓰기 | $0.125 / $0.625 | $1.25 | $2.50 |
캐시(같은 지시문을 다시 보낼 때 싸게 읽는 기능) 값도 같은 비율로 내려갔어요. 개발 문서에는 배치 API(모아서 처리)를 쓰면 입력·출력이 50% 할인된다고 적혀 있어요.
성능: Anthropic이 밝힌 숫자
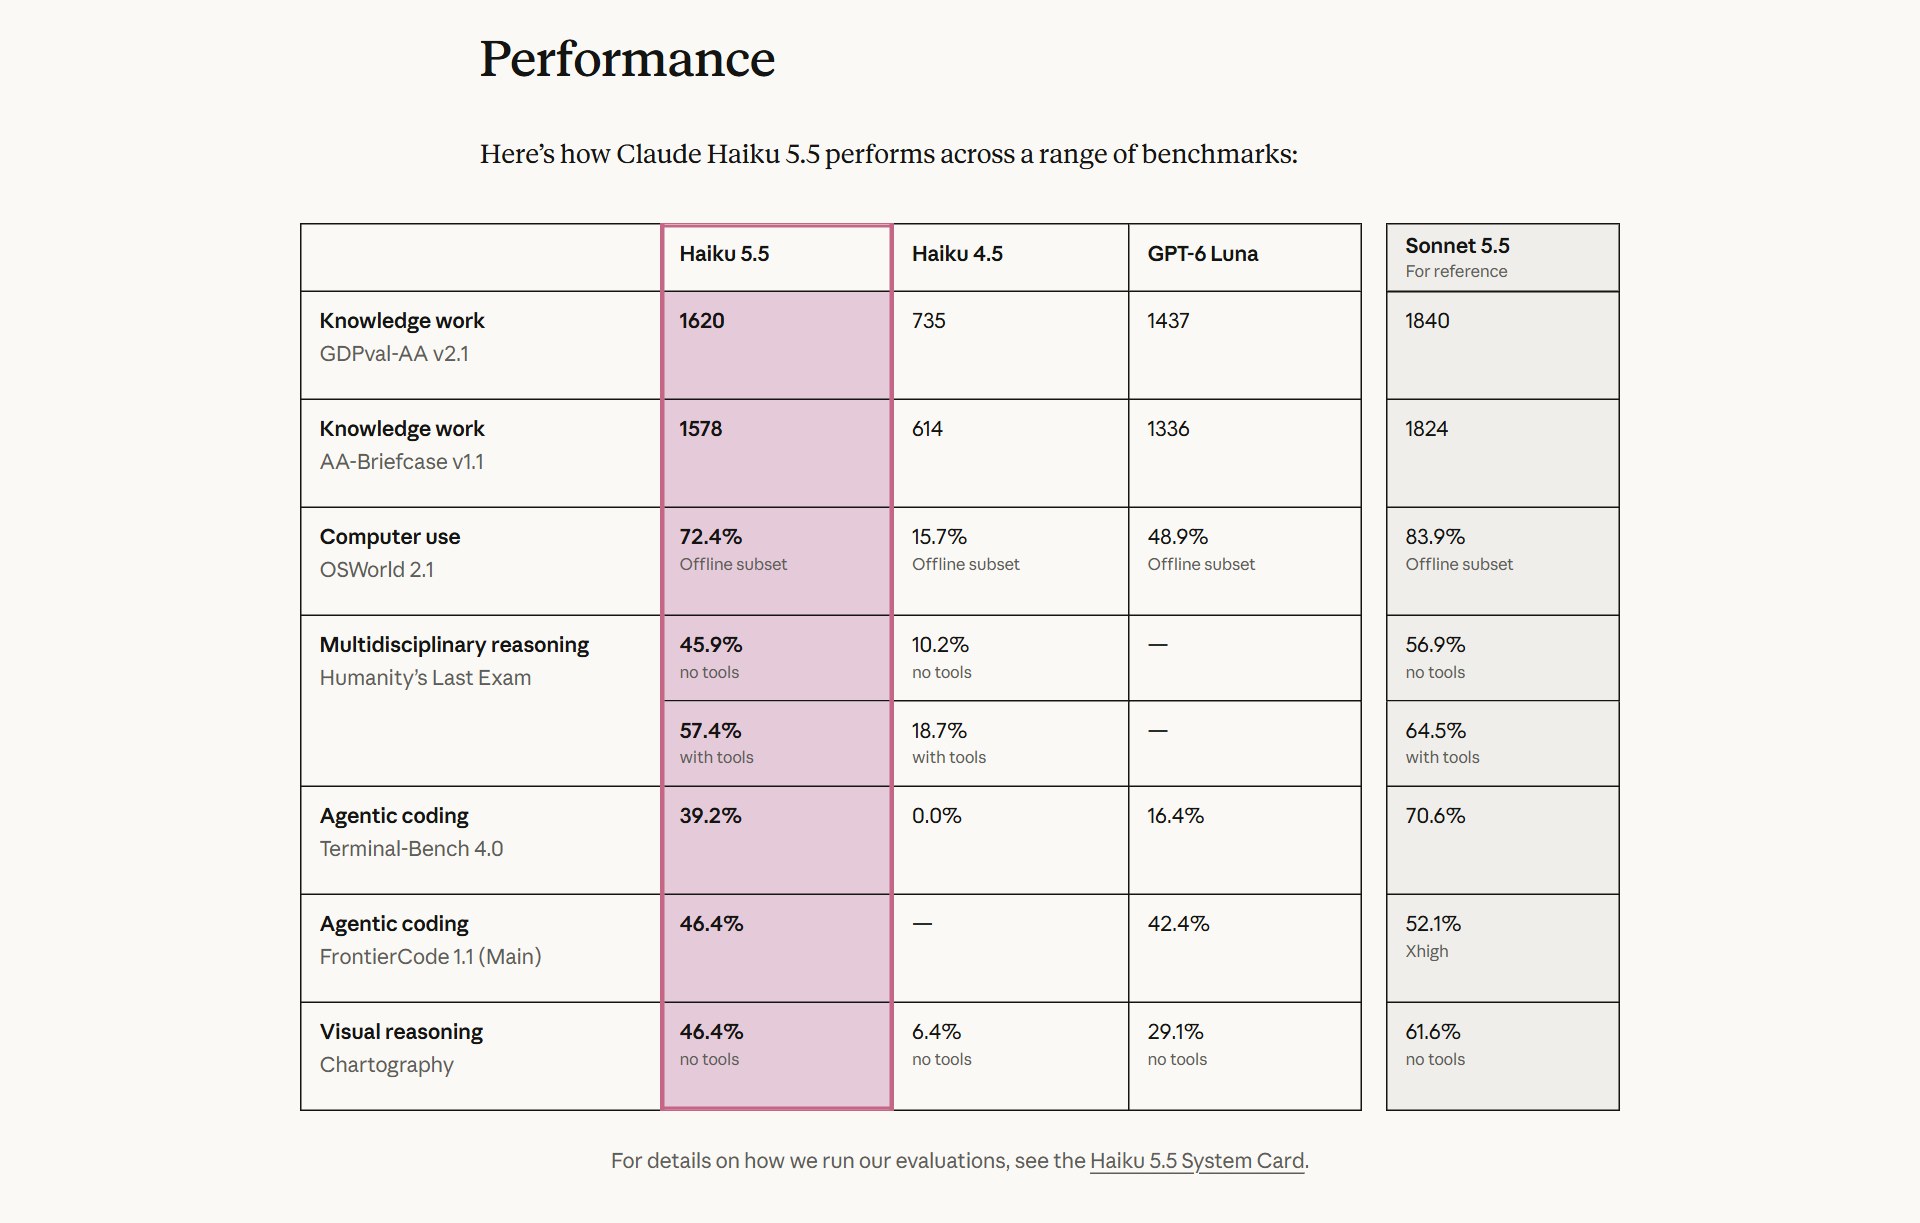
아래는 모두 Anthropic이 직접 재서 발표한 값이에요.
- 컴퓨터 조작 · OSWorld 2.1 (오프라인 일부) Haiku 5.5 72.4%, Haiku 4.5 15.7%, GPT-6 Luna 48.9%, Sonnet 5.5 83.9%
- 지식 업무 · GDPval-AA v2.1 Haiku 5.5 1620, Haiku 4.5 735, GPT-6 Luna 1437, Sonnet 5.5 1840
- 여러 분야 추론 · Humanity's Last Exam (도구 없이) Haiku 5.5 45.9%, Haiku 4.5 10.2%, Sonnet 5.5 56.9%
- 에이전트 코딩 · Terminal-Bench 4.0 Haiku 5.5 39.2%, Haiku 4.5 0.0%, GPT-6 Luna 16.4%, Sonnet 5.5 70.6%
- 에이전트 코딩 · FrontierCode 1.1 Haiku 5.5 46.4%, GPT-6 Luna 42.4%, Sonnet 5.5 52.1%
- 차트 읽기 · Chartography (도구 없이) Haiku 5.5 46.4%, Haiku 4.5 6.4%, GPT-6 Luna 29.1%, Sonnet 5.5 61.6%
이전 Haiku보다는 크게 올랐지만, 참고용으로 함께 실린 Sonnet 5.5에는 모든 항목에서 못 미쳐요.
추론 강도를 고를 수 있는 첫 Haiku
Haiku 5.5는 Haiku 가운데 처음으로 추론 강도(effort) 설정이 들어갔어요. 발표 글의 차트에는 Low, Med, High, Xhigh, Max 다섯 단계가 나와요. 낮게 두면 싸고 빠르고, 높이면 더 오래 생각해서 점수가 올라가요. 개발 문서 기준 API 기본값은 medium이에요.
- 문맥 창 100만 토큰
- 최대 출력 12만 8천 토큰 (배치 API는 베타로 30만 토큰까지)
- 모델 ID claude-haiku-5-5
- 쓸 수 있는 곳 Claude Platform(API), Amazon Web Services, Google Cloud, Microsoft Azure
같이 발표된 것
- Sonnet 5.5 캐시 읽기 값 절반 100만 토큰당 $0.20에서 $0.10으로 내렸어요. Anthropic은 대부분의 에이전트 작업에서 Sonnet 5.5 비용이 약 20% 줄어든다고 했어요.
- 구독자 월 API 크레딧 이번 주부터 Max 5x는 월 $100, Max 20x는 월 $200, Team은 최대 $500(구성원 공동)을 받아요. Claude Platform에서 모든 모델에 쓸 수 있어요.
- SDK에 컴퓨터·브라우저 조작(베타) Claude 파이썬·타입스크립트 SDK에 컴퓨터 사용과 브라우저 사용 지원이 베타로 들어가요.
알아 둘 점
- 같은 글도 토큰이 더 나와요 개발 문서에 따르면 새 토크나이저를 써서 같은 글이 Haiku 4.5보다 약 30% 많은 토큰으로 세어져요. 토큰당 값이 10분의 1이어도 실제 절감은 그보다 작아요.
- 10만 토큰을 넘으면 5배 긴 프롬프트는 $0.50·$2.50 구간이에요. 그래도 Haiku 4.5의 절반이에요.
- 어려운 코딩은 큰 모델 Anthropic은 Terminal-Bench 4.0 같은 복잡한 코딩에는 Sonnet 5.5와 Opus 5.5가 더 나은 선택이고, Haiku 5.5는 대화 압축·요약·보조 에이전트처럼 범위가 좁은 일에 맞다고 적었어요.
- '가장 빠르다'의 조건 각 모델의 표준 속도 기준이에요. Opus의 Fast Mode보다는 느리다고 각주에 밝혔어요.
먼저 써 본 회사들의 말
발표 글에 실린 고객사 평가예요. Box는 초기 시험에서 Haiku 4.5보다 11점 높은 점수를 지연 시간 약 절반으로 얻었다고 했어요. AlphaSense는 질문 400개로 시험해 Haiku 4.5의 0.76보다 높은 0.84를 얻었다고 했고, Asana는 지금 쓰는 모델과 견줘 작업 완료 지연이 30% 넘게 줄었다고 전했어요. 모두 각 회사의 자체 시험이에요.