말이 끝나기 전에 통역한다 — 텐센트 'Hy-SimulMT' 오픈소스 공개, 내 목소리 그대로 중↔영 동시통역
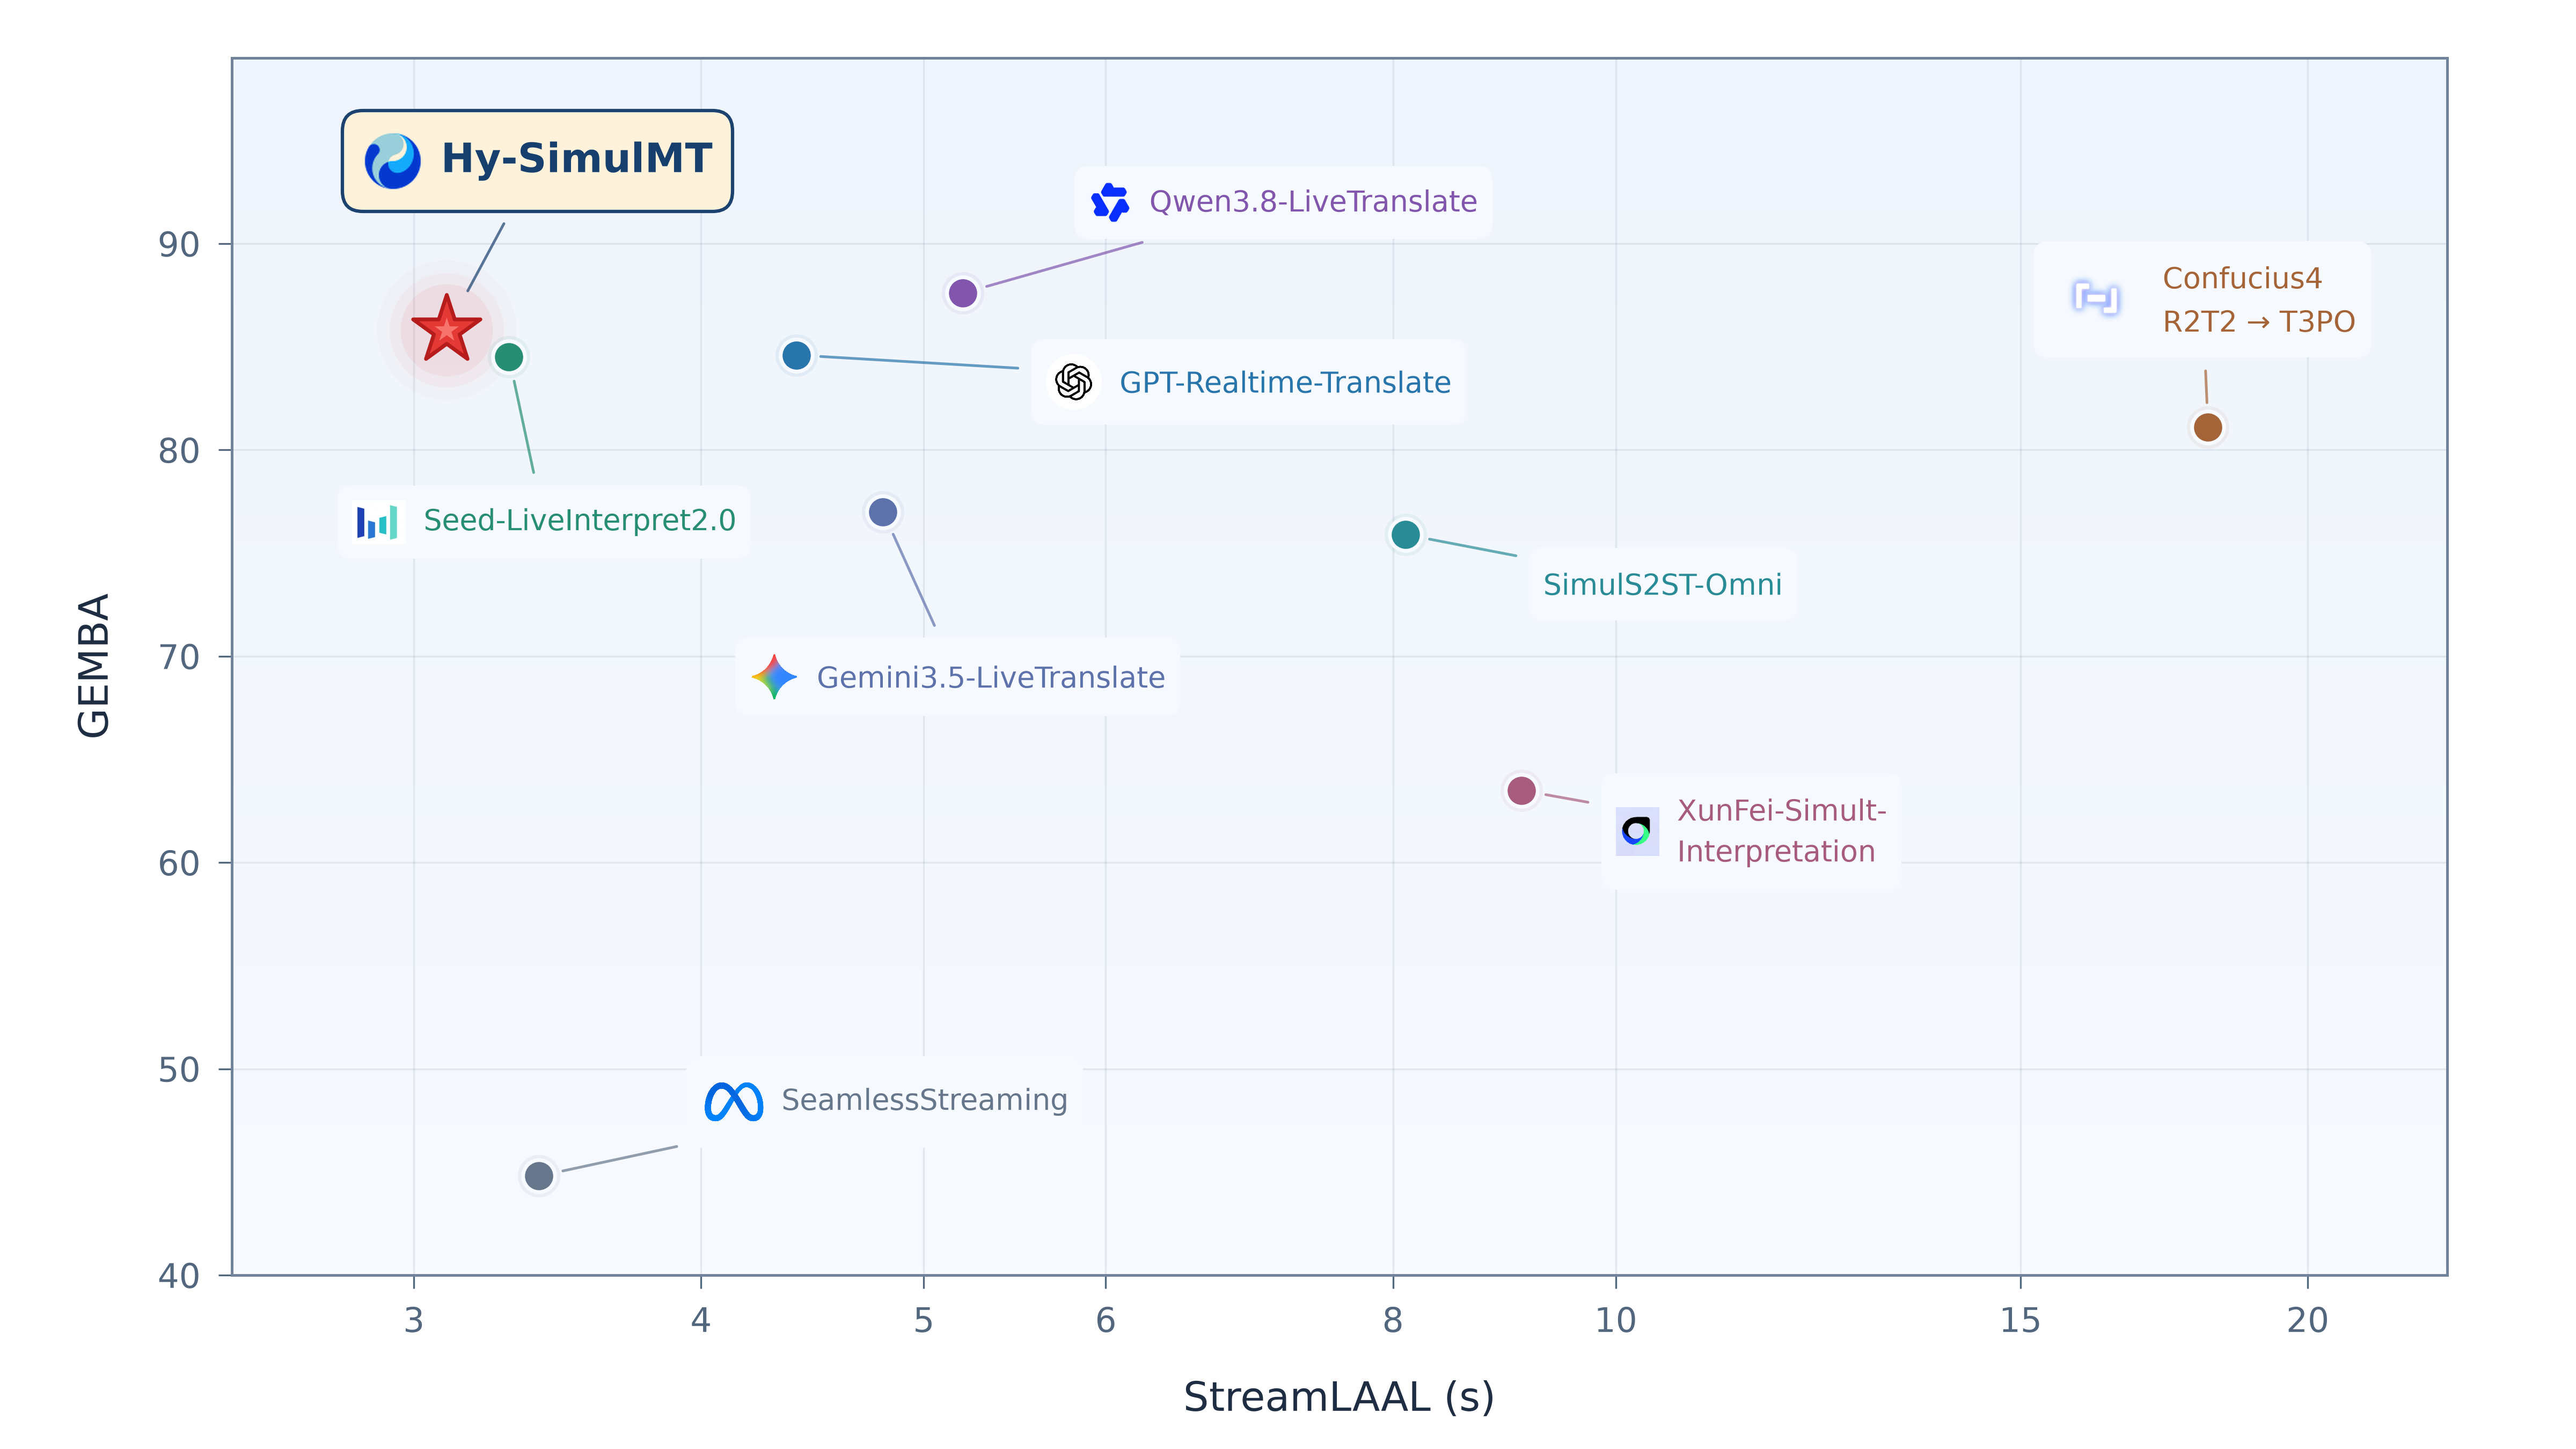
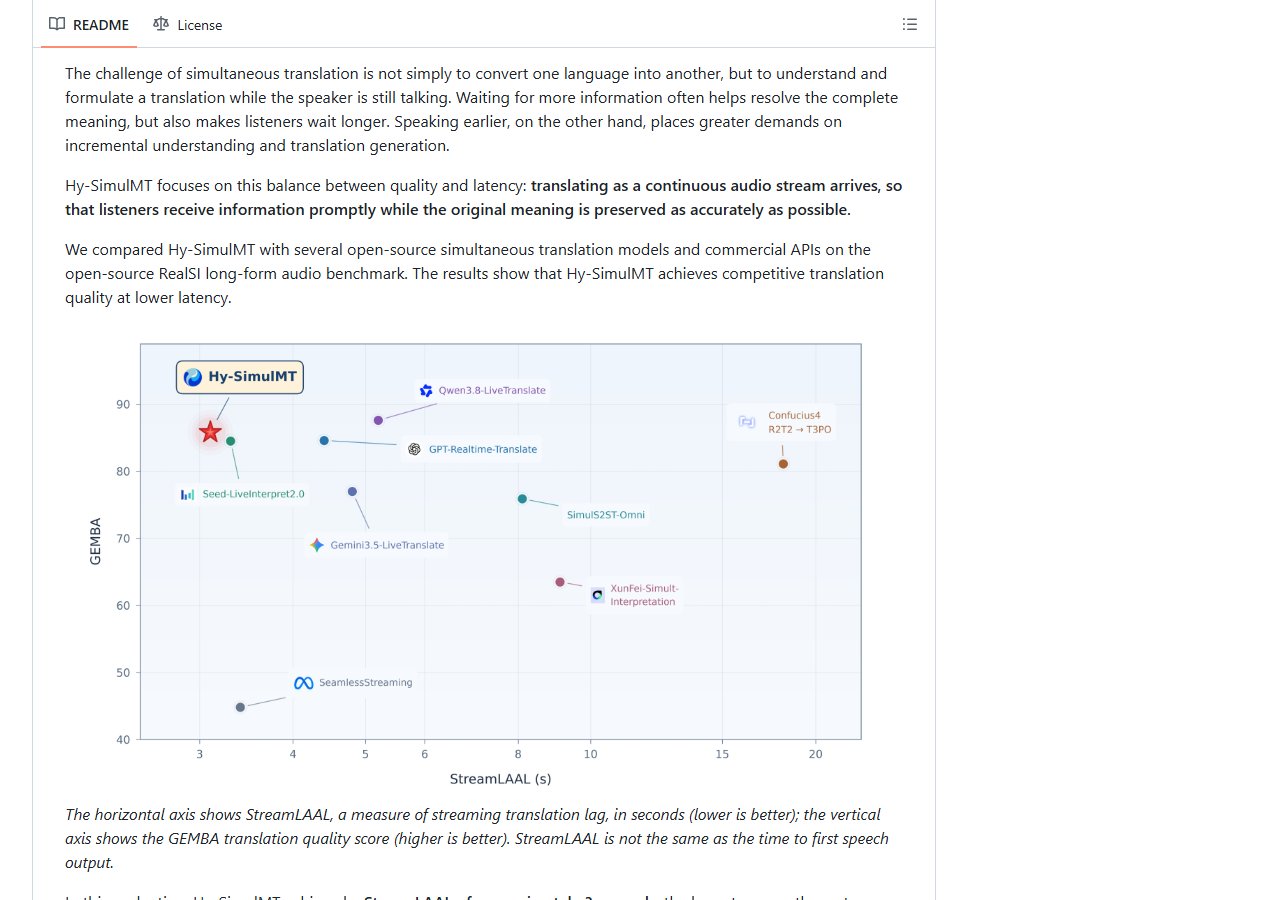
텐센트가 중국어 ↔ 영어 실시간 동시통역 모델 Hy-SimulMT를 Apache 2.0으로 풀었어요. 말하는 도중에 번역 글과 음성을 내고, 말하는 사람의 목소리 특징을 살려 읽어 줘요. 긴 음성 평가에서 지연(StreamLAAL)은 약 3초였어요.
- Hy-SimulMT는 중국어 ↔ 영어 양방향 '음성 → 음성' 동시통역 모델이에요. 소리를 계속 받으면서 번역 글과 음성을 내고, 실시간 목소리 복제로 말하는 사람의 목소리 특징을 살려요. 2026년 10월 26일 GitHub · Hugging Face에 공개됐어요.
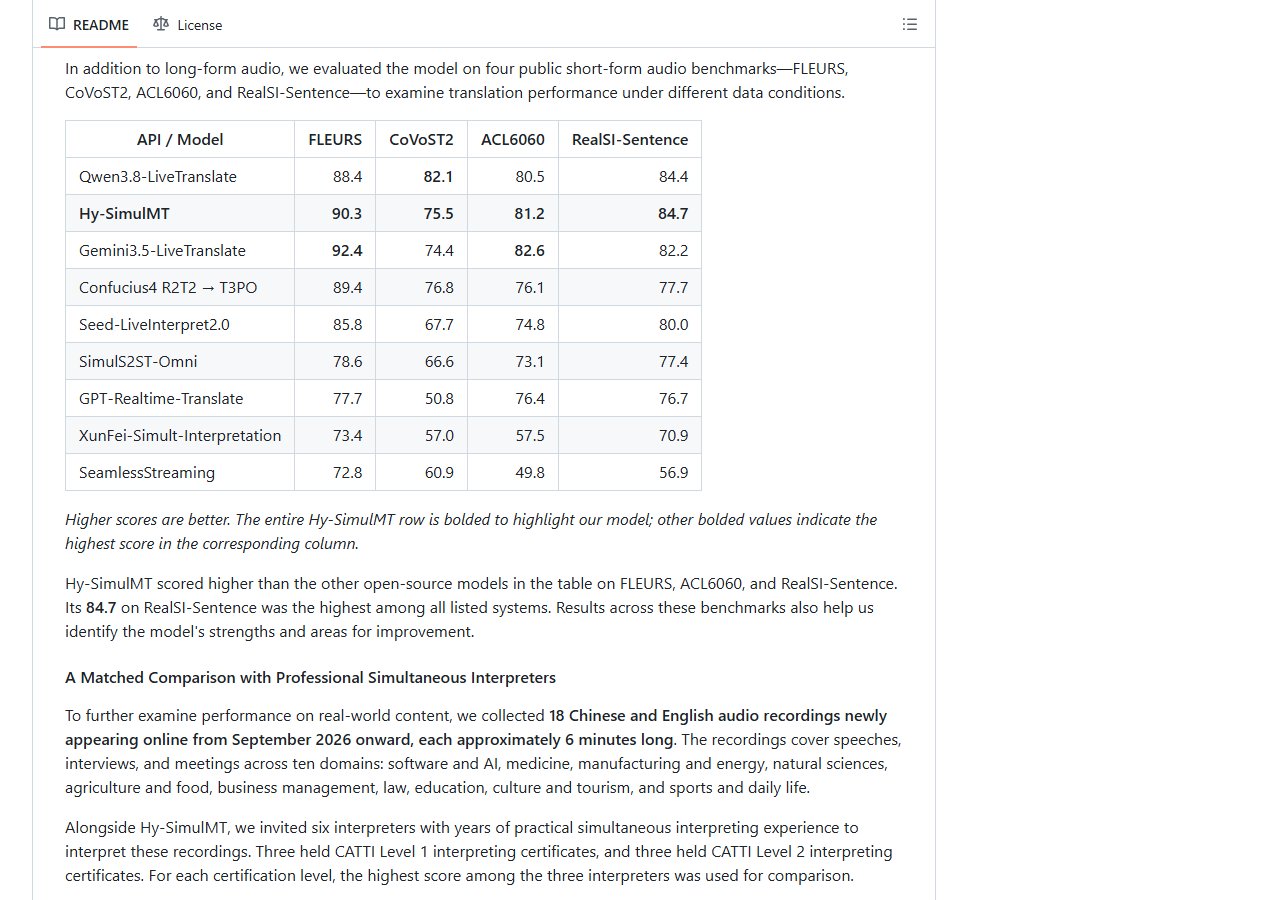
- README 기준: 긴 음성 벤치마크 RealSI에서 StreamLAAL(번역이 따라오는 지연)이 약 3초로 비교 대상 중 가장 낮았고, 번역 품질(GEMBA)은 비교한 오픈소스 모델과 상용 API 5개 중 4개보다 높았어요. 짧은 음성 RealSI-Sentence에선 84.7점으로 표 안 1위예요.
- 다만 음성 출력 · 목소리 복제는 TTS(음성 합성) 서비스를 따로 연결해야 하고, 지금 바로 돌리려면 리눅스 + NVIDIA GPU + vLLM이 필요해요. llama.cpp 지원은 아직 공식 저장소에 합쳐지지 않았어요.
README의 deploy.sh 한 줄로 vLLM 모델 서버와 웹 페이지(8080 포트)를 함께 띄울 수 있어요. WebSocket · 파일 업로드 API가 있어서 회의 · 방송용 실시간 자막 도구의 출발점으로 좋아요.
중국어 인터뷰 · 강연 영상을 영어로, 영어 영상을 중국어로 옮길 때 원래 목소리 느낌을 살린 더빙 시안을 뽑아 볼 수 있어요. 공식 Hy Translate 앱(안드로이드 · iOS)으로 먼저 맛보기 해 보세요.
중국 거래처와의 화상 회의에 쓸 수 있을지 앱으로 시험해 볼 만해요. README도 계약 · 중요한 결정처럼 책임이 큰 자리는 전문 통역사가 여전히 중요하다고 적었어요.
1) 가볍게: README의 QR로 Hy Translate 앱(안드로이드 · iOS)을 받아 써 본다 2) 직접 돌리기: 리눅스 · Python 3.12+ · NVIDIA GPU를 준비하고 git clone https://github.com/Tencent-Hunyuan/Hy-SimulMT.git Hy-SimulMT → cd Hy-SimulMT → cd SimulInfer 3) bash deploy.sh --install-server --model tencent/Hy-SimulMT-30B-A3B-Interleave 4) 'Ready: http://127.0.0.1:8080/'가 뜨면 열어서 번역 방향을 고르고 음성 파일을 올리거나 마이크를 켠다 5) 음성 출력 · 목소리 복제는 TTS 설정 문서(SimulInfer/docs/TTS.en.md)를 따른다 · 라이선스: Apache 2.0
중국어 ↔ 영어 인터뷰 · 강연 영상을 원래 목소리 느낌을 살려 더빙 시안으로 만들어 볼 때 써 보면 좋을 것 같아요.
텐센트 Hunyuan 팀이 실시간 동시통역 모델 Hy-SimulMT를 2026년 10월 26일 오픈소스로 공개했어요. 중국어 ↔ 영어 양방향 음성 → 음성 번역을 하고, 말하는 사람이 말을 끝내기 전에 소리를 계속 받으면서 번역 글과 음성을 내요. 실시간 목소리 복제(voice cloning)로 원래 말하는 사람의 목소리 특징을 살린다는 게 README 설명이에요. 회의 · 강연 · 인터뷰 같은 자리를 겨냥했어요.
숫자로 보면
README에 실린 평가는 이래요.
- 긴 음성(RealSI): StreamLAAL(번역이 말을 얼마나 늦게 따라오는지 재는 지연 값)이 약 3초로 비교 그림 속 시스템 중 가장 낮았어요. 번역 품질 점수(GEMBA)는 비교한 오픈소스 모델들과 상용 API 5개 중 4개보다 높았어요. README는 StreamLAAL이 '첫 음성이 나오기까지 걸리는 시간'과는 다르다고 따로 적었어요.
- 짧은 음성 벤치마크 4개: Hy-SimulMT는 FLEURS 90.3 · CoVoST2 75.5 · ACL6060 81.2 · RealSI-Sentence 84.7이에요. RealSI-Sentence 84.7은 표에 있는 모든 시스템 중 가장 높고, FLEURS(Gemini3.5-LiveTranslate 92.4) · CoVoST2(Qwen3.8-LiveTranslate 82.1) · ACL6060(Gemini3.5-LiveTranslate 82.6)에선 1위가 아니에요.
- 사람 통역사와 비교: 2026년 9월 이후 새로 올라온 약 6분짜리 중 · 영 음성 18개를 CATTI(중국 통번역 자격) 1급 3명 · 2급 3명과 나눠 통역했어요. README는 번역 품질이 전문 통역사와 비슷하고 지연은 더 낮을 때가 많았다고 했지만, 이 표본 · 참가자 · 조건에만 해당하는 작은 규모 평가라고 단서를 달았어요.
무엇이 공개됐나
- 모델 6종: Hy-SimulMT-30B-A3B(번역만 출력)와 Interleave 판(원문 글 + 번역 함께 출력), 각각 FP8 · GGUF 판
- SimulInfer: 웹 페이지 · 음성 파일 업로드 · 실시간 WebSocket · 목소리 복제가 되는 TTS(선택)를 묶은 추론 서비스
- SimulTrain: 받은 체크포인트에서 이어서 학습하는 도구
라이선스는 Apache 2.0이에요(Hugging Face 모델 카드 기준). 직접 설치하지 않고 써 보려면 텐센트의 Hy Translate 앱(안드로이드 · iOS)에서 Hy-SimulMT를 써 볼 수 있다고 README에 적혀 있어요.
돌리려면 알아 둘 것
vLLM으로 돌리려면 리눅스 · Python 3.12 이상 · 모델이 들어갈 만한 메모리의 NVIDIA GPU가 필요해요. deploy.sh 한 줄이 필요한 것을 설치하고 모델 서버와 웹 서비스(기본 8080 포트)를 띄워요. 음성 출력과 목소리 복제는 TTS 서비스를 따로 설정해야 해요. GGUF 판을 쓰는 llama.cpp 지원은 아직 공식 저장소에 합쳐지지 않아서, README는 지원 판이 나올 때까지 기다리라고 권해요.