쉬운 코딩 작업은 내 PC 모델이, 어려운 건 클라우드가… GitHub Copilot 자동 배분 '이달 말까지'
GitHub와 마이크로소프트가 Copilot이 작업마다 기기 안 모델과 클라우드 모델 중 맞는 쪽을 고르는 기능을 예고했어요. 기기용 모델 MAI Code 1.1 Flash는 53GB이고, 시험은 메모리가 최대 128GB인 Surface Laptop Ultra에서 했어요.
- GitHub Copilot이 작업을 기기 안 모델과 클라우드 모델 사이에서 알아서 나눠 보내는 기능이 '이달 말까지' 온다고 공식 글(10월 7일)이 밝혔어요. 아직 쓸 수 있는 기능은 아니에요.
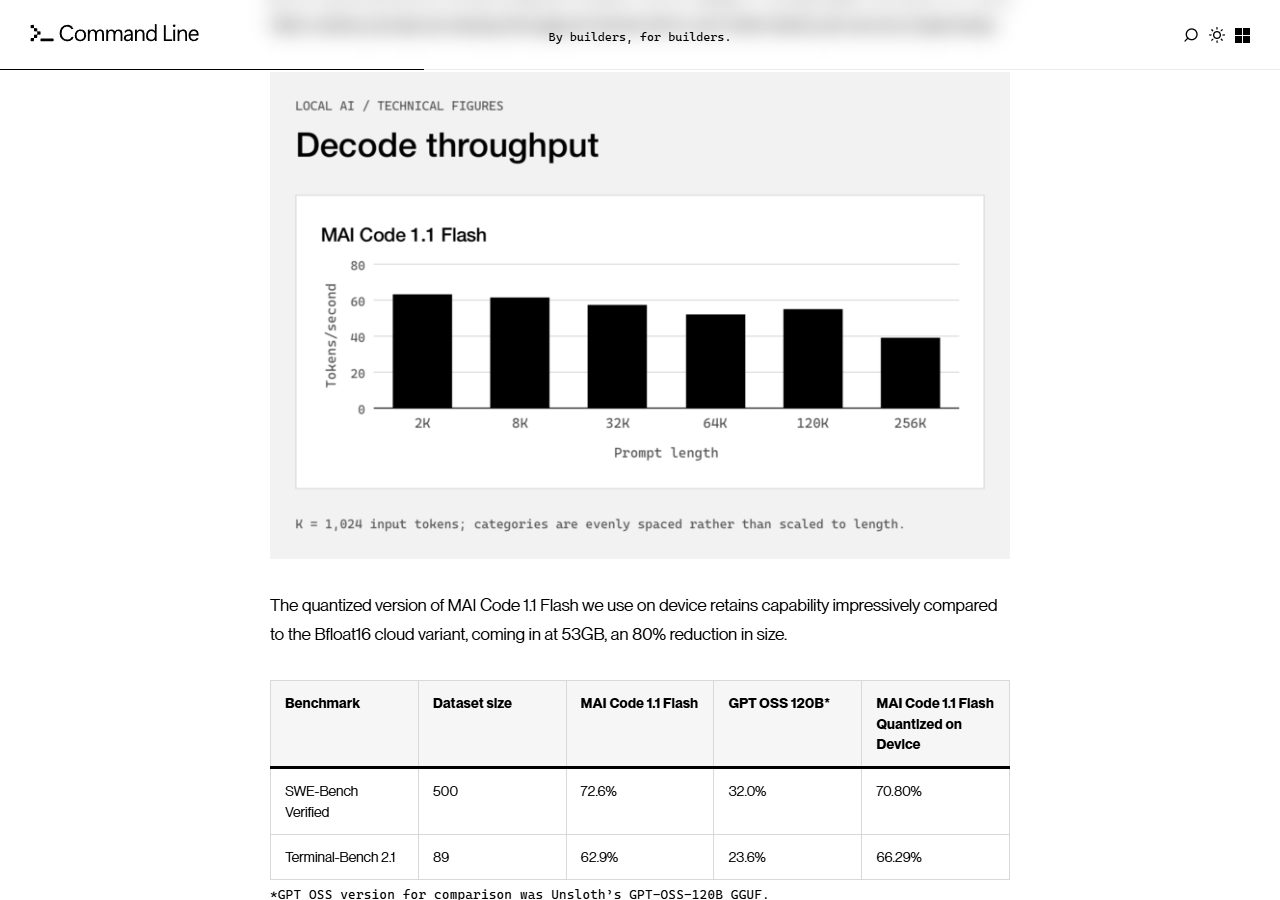
- 기기용 모델은 MAI Code 1.1 Flash예요. 크기를 줄인 버전이 53GB(클라우드 버전보다 80% 작음)이고, 256k 컨텍스트에서 메모리를 최대 75.5GB 써요. 시험 기기는 NVIDIA RTX Spark가 든 Surface Laptop Ultra(통합 메모리 최대 128GB)예요.
- 에이전트가 실행하는 명령은 샌드박스(격리된 실행 공간) 안에서 돌려 파일·네트워크·자격 증명 접근을 정책으로 제한해요. 다만 Copilot에 내장된 파일 도구와 원격 MCP 서버는 운영체제 수준 격리 밖이라고 원문이 적었어요.
Copilot 크레딧이 '코드 구조 설명해 줘', '이 프로젝트 어떻게 실행해?' 같은 쉬운 질문에 많이 나간다면 눈여겨볼 소식이에요. 다만 원문이 시험한 기기는 메모리 최대 128GB급이라, 지금 쓰는 PC에서 될지는 '지원 기기' 기준이 나온 뒤에 판단하는 게 좋아요.
AI 에이전트에게 터미널 명령을 맡기는 게 불안했다면, Copilot CLI의 /sandbox 설정으로 작업 폴더만 읽고 쓰게 묶어 두는 쪽은 로컬 모델과 상관없이 살펴볼 만해요.
자동 배분을 기다리는 동안, 클라우드 모델끼리 나눠 쓰는 HydraFusion(연구용 미리보기)은 지금 써 볼 수 있어요.
1. GitHub Copilot CLI에서 /update 로 최신 버전 받기
2. /experimental on 실행
3. /model 메뉴에서 HydraFusion 고르기
4. 에이전트 명령을 묶어 두려면 /sandbox 로 설정 열기
매일 아침 같은 보고서를 만드는 예약 작업처럼 오래 걸리고 반복되는 일을 로컬 모델에 맡겨 볼 수 있을 것 같아요. 다만 필요한 기기 사양이 높아서, 지금은 지원 기기 목록과 요금 안내가 나오는지 지켜보는 편이 좋아 보여요.
GitHub와 마이크로소프트가 10월 7일(현지 시간) 공식 글에서 GitHub Copilot이 작업마다 기기 안 모델과 클라우드 모델 중 맞는 쪽을 알아서 고르는 기능을 예고했어요. 원문 표현은 "Coming by the end of the month"(이달 말까지)이고, GitHub 공식 X는 "Coming soon"(곧)이라고 알렸어요. 아직 쓸 수 있는 기능은 아니에요.
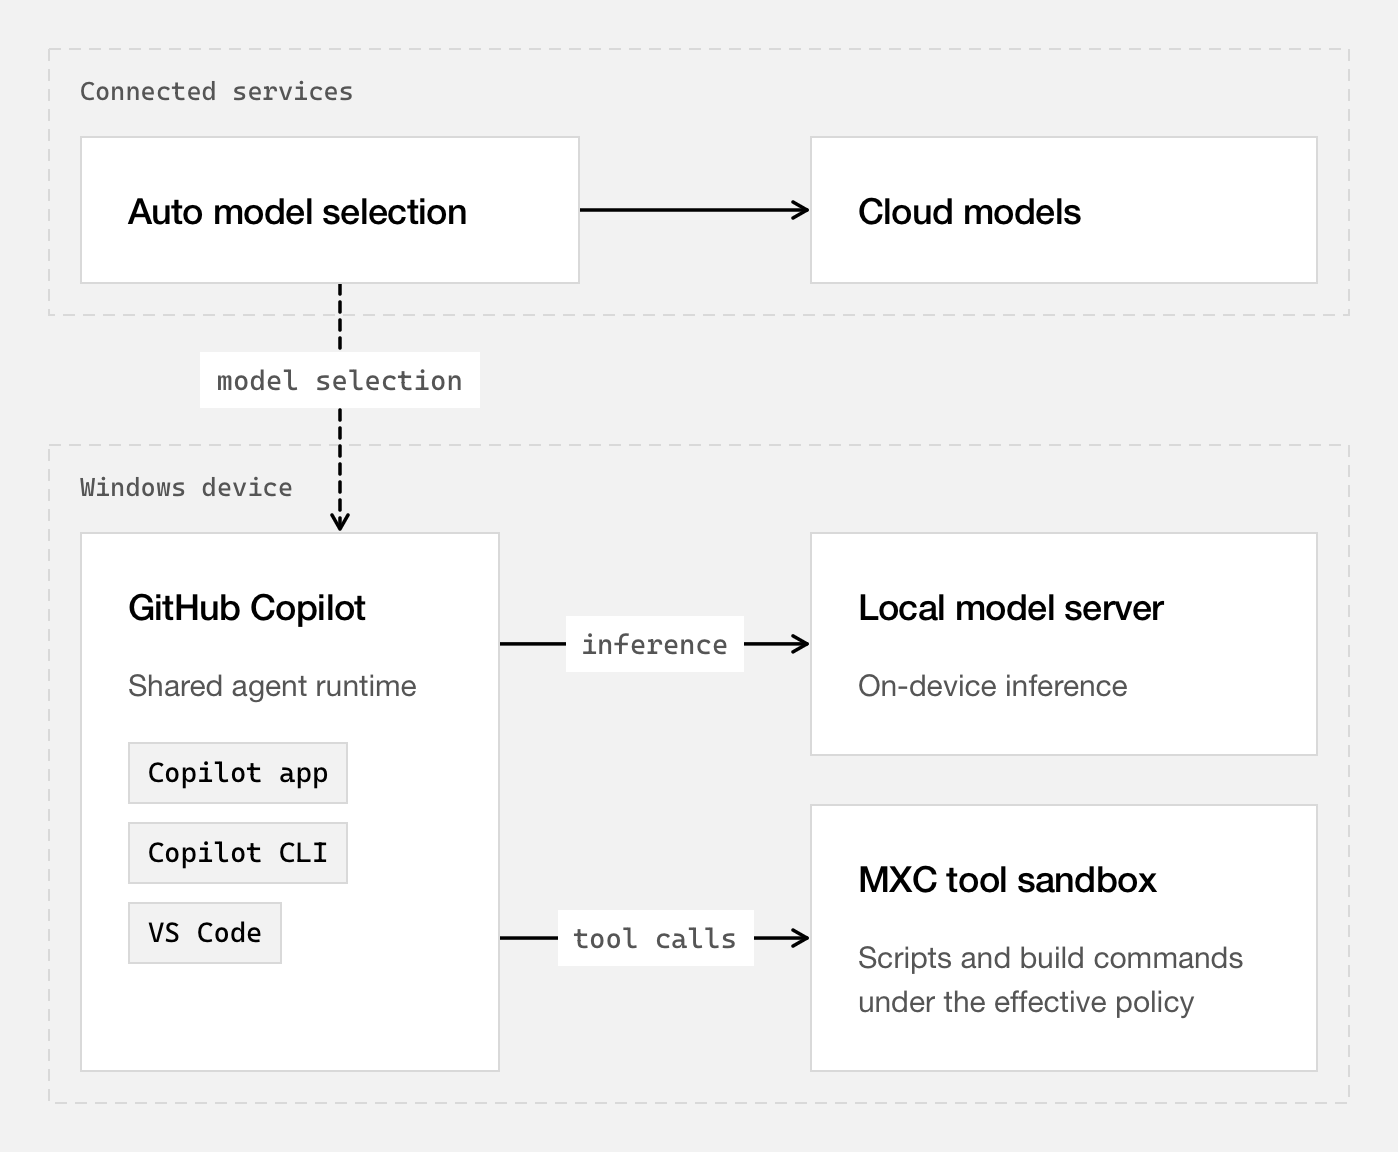
무엇이 바뀌나 — 지금은 개발자가 어느 모델을 쓸지 직접 골라요. 앞으로는 두 가지 방법이 생겨요. Auto를 켜 두면 Copilot이 작업 내용과 캐시 상태를 보고 로컬(내 컴퓨터)과 클라우드 사이에서 일을 나눠 보내고, 직접 통제하고 싶으면 로컬 모델을 지정할 수 있어요. 적용 대상은 GitHub Copilot CLI, Copilot 앱, VS Code예요. 공식 X는 이 기능이 "AI 크레딧을 아끼는 데 도움이 된다"고 적었고, 공식 영상은 로컬 모델을 쓰는 작업은 AI 크레딧이 0이라고 말해요.
기기용 모델 MAI Code 1.1 Flash — 마이크로소프트 AI가 만든 코딩용 모델이에요. 전체 파라미터(모델 크기를 나타내는 숫자)는 1,370억 개이고, 한 번에 실제로 쓰는 것은 68억 개예요(필요한 부분만 골라 쓰는 '전문가 혼합' 구조). 기기용은 양자화(숫자를 덜 정밀하게 저장해 크기를 줄이는 방법)로 53GB까지 줄였고, 원문은 이것이 클라우드 버전보다 80% 작다고 했어요.
어떤 기기가 필요한가 — 원문이 시험한 기기는 NVIDIA RTX Spark가 든 Surface Laptop Ultra예요. 통합 메모리(CPU와 GPU가 함께 쓰는 메모리)가 최대 128GB이고, 256k 컨텍스트(한 번에 읽는 글의 양)에서 메모리를 최대 75.5GB 썼어요. 시험은 Windows ARM64 환경에서 했다고 적혀 있어요. '지원 기기'의 최소 사양과 기기 가격은 원문에서 확인하지 못했어요.
성적 (만든 회사가 10월 5일에 직접 잰 값) — 코딩 시험 SWE-Bench Verified(500문제)에서 클라우드 버전 72.6%, 기기용 70.80%였어요. 터미널 작업 시험 Terminal-Bench 2.1(89문제)에서는 클라우드 버전 62.9%, 기기용 66.29%로 적혀 있어요. 같은 표에서 비교 대상인 공개 모델 GPT OSS 120B는 32.0%, 23.6%예요.
격리(샌드박스)가 막는 것 — 에이전트가 실행하는 셸 명령은 원래 그 계정의 권한을 그대로 물려받아요. 모델을 기기로 옮겨도 이 점은 같아요. 그래서 Copilot은 MXC(Microsoft Execution Containers, 윈도우 팀의 오픈소스 라이브러리)로 에이전트가 띄우는 프로세스에 정책을 걸어 파일, 네트워크, 자격 증명(로그인 정보), 시스템 기능, 실행 경로 접근을 제한해요. 윈도우에서는 ProcessContainer, macOS에서는 Seatbelt, 리눅스에서는 bubblewrap을 써요. Copilot 앱에서 프로젝트별로 켜면 기본으로 작업 폴더만 읽고 쓸 수 있고, 나머지는 대부분 읽기 전용이거나 접근이 막혀요. Copilot CLI에서는 /sandbox 명령으로 설정해요. MXC 자체는 같은 날 정식 출시됐다고 윈도우 개발자 블로그가 밝혔어요.
다만 — 격리가 전부를 감싸지는 않아요. 원문에 따르면 Copilot에 내장된 파일 도구는 Copilot 안에서 정책을 확인할 뿐 운영체제가 강제하는 격리는 아니고, 원격 MCP 서버(에이전트에 외부 도구를 붙이는 연결)도 로컬 샌드박스 밖이에요. 또 원문 그림 설명은 "로컬 추론이 세션을 오프라인으로 만들지는 않는다"고 적었어요. 공식 영상은 인터넷 없이도 로컬 모델을 쓸 수 있다고 말하니, 어디까지 오프라인으로 되는지는 출시 뒤에 확인이 필요해요. 요금제별 조건도 원문에서 확인하지 못했어요.
지금 되는 것 — 이번 발표의 바탕인 Project HydraFusion(9월 4일 공개, 연구용 미리보기)은 클라우드 모델 여러 개 중에서 작업에 맞는 것을 골라 쓰는 기능이에요. 모든 Copilot 요금제에서 Copilot CLI의 /experimental로 켤 수 있고, GitHub의 오프라인 평가에서는 TerminalBench 2.1 기준 Claude Opus 5보다 품질이 4.9%포인트 높으면서 추정 비용이 67% 낮았다고 해요.
X 게시물 보기 · https://x.com/github/status/2107896916595884177
- Copilot이 곧 '지원 기기'에서 로컬 모델로 작업을 알아서 보낸다고 예고해요. Microsoft Foundry Local이나 Ollama로 설치해 둔 모델은 따로 설정하지 않아도 모델 선택 창에 뜬다고 해요.
- 지원 기기에서는 Copilot 안에서 MAI Code 1.1 Flash를 바로 설치할 수 있고, Auto로 두면 코드 구조 설명 같은 쉬운 작업을 로컬 모델에 넘겨요.
- 예약해 두고 돌리는 자동화처럼 오래 걸리는 작업에 잘 맞고, 로컬 모델을 쓰는 동안은 AI 크레딧이 들지 않는다고 말해요. HydraFusion은 오늘부터 실험 설정에서 쓸 수 있어요.