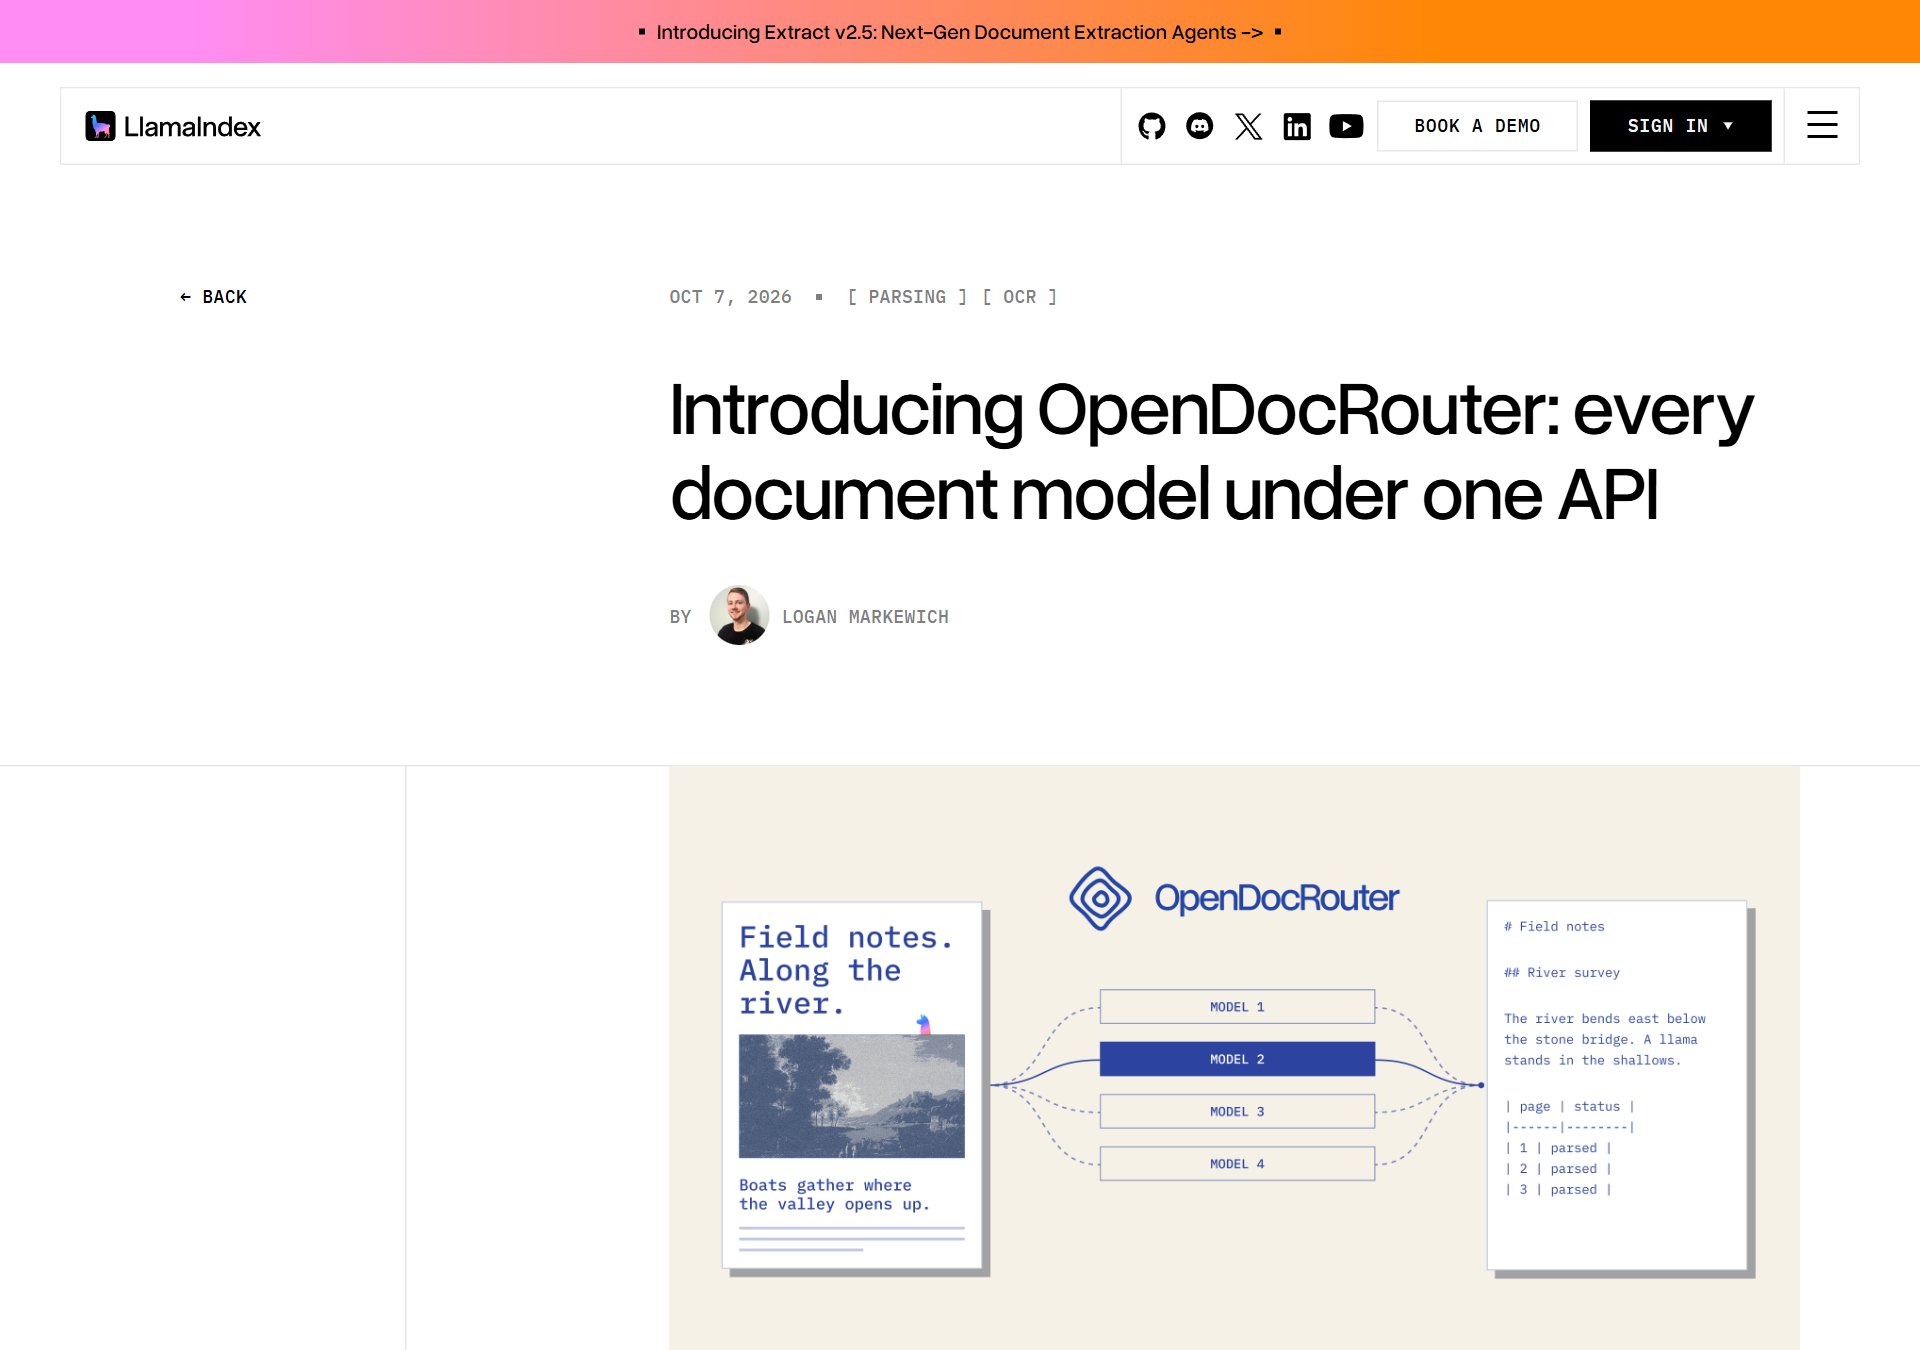
PDF 읽는 AI, 모델 이름만 바꿔 갈아 끼워요… LlamaIndex가 OpenDocRouter를 열었어요
PDF·스캔 문서를 글로 바꿔 주는 모델 여러 개를 주소 하나로 골라 쓰는 유료 API예요. 모델 표에는 지금 11개가 있고, 1,000쪽 예상 값은 $0.80부터 $48.82까지예요.
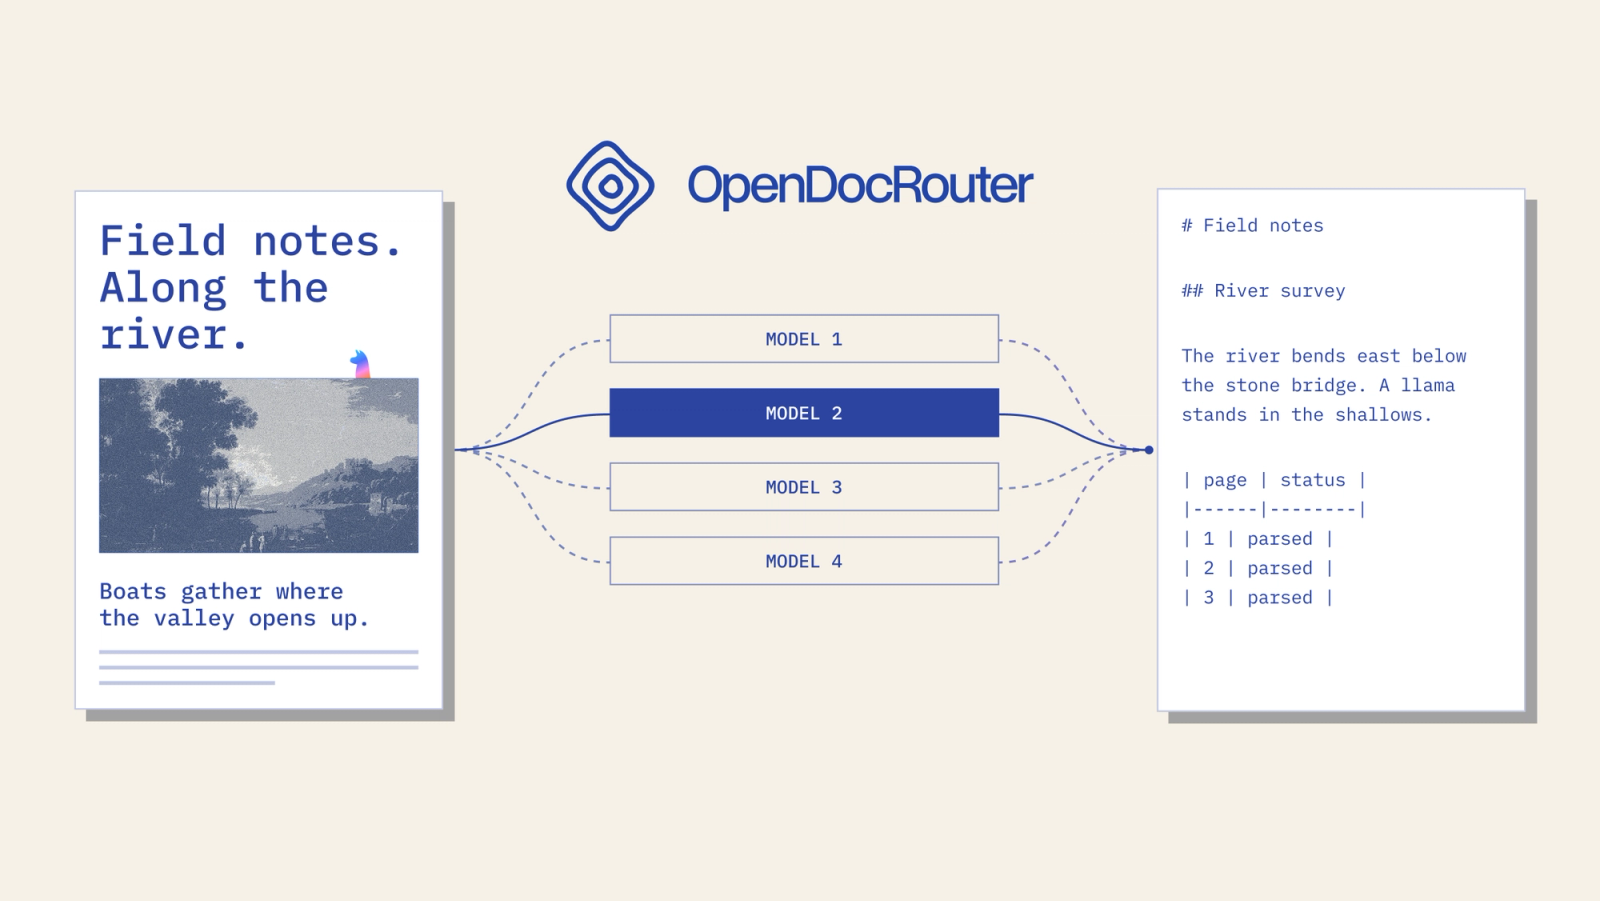
- OpenDocRouter는 PDF·PNG·JPEG를 마크다운(제목·표가 표시된 글 형식)으로 바꿔 주는 API예요. 요청의 model 값만 바꾸면 다른 모델로 같은 문서를 읽혀 볼 수 있어요.
- 공식 블로그는 출시 모델로 10개(대형 AI 회사 모델 5개 + 오픈소스 문서 읽기 모델 5개)를 적었고, 모델 표에는 Claude Haiku 5.5가 더해져 지금 11개예요.
- 무료 구간은 원문에서 찾지 못했어요. 선불 충전은 $25부터이고 충전할 때마다 수수료 5%가 붙어요. 실패한 쪽은 값을 받지 않아요. 공개된 코드는 파이썬·타입스크립트 SDK(MIT)예요.
PDF를 글로 바꿔 검색·요약에 넣는 파이프라인을 운영한다면, 자주 깨지던 문서 20쪽을 골라 값이 싼 모델(GPT-6 Luna, MinerU2.5-Pro)과 비싼 모델(Claude Opus 5.5)로 같은 쪽을 읽혀 표·차트가 어디서 깨지는지 비교해 볼 만해요. 응답에 쪽마다 charge_usd(청구액)가 찍혀서 실제 값도 같이 볼 수 있어요.
코드를 쓰지 않는다면 당장 쓸 곳은 없어요. 다만 영수증·계약서·보고서 PDF를 자동으로 정리하는 일을 맡길 때, 견적서의 '문서 읽기' 값이 모델에 따라 1,000쪽에 $1 안팎에서 $49까지 벌어진다는 기준표로 쓸 수 있어요.
ChatGPT나 Claude에 PDF를 올려 요약하는 정도라면 바꿀 것이 없어요. 수백 쪽짜리 자료집을 통째로 글로 바꿔 쌓아 두려는 경우에만 개발자와 함께 살펴볼 도구예요.
1) opendocrouter.ai에서 가입하고 API 키 만들기 (충전은 $25부터, 충전마다 수수료 5%)
2) pip install opendocrouter 또는 npm install @llamaindex/opendocrouter
3) 자주 깨지던 PDF를 pages "1-3"처럼 몇 쪽만 골라 openai/gpt-6-luna로 보내기
4) model 값만 opendatalab/mineru2.5-pro, anthropic/claude-opus-5-5로 바꿔 같은 쪽을 다시 보내기
5) 쪽마다 나온 마크다운과 charge_usd를 나란히 놓고 고르기
표와 차트가 섞인 PDF를 글로 바꾸다 자주 깨졌다면, 문제 되는 쪽만 골라 싼 모델과 비싼 모델로 한 번씩 읽혀 보는 비교용으로 써 보면 좋을 것 같아요. 다만 점수와 예상 값은 모두 만든 회사가 잰 것이라, 내 문서로 직접 확인한 뒤에 옮겨 가는 편이 안전해 보여요.
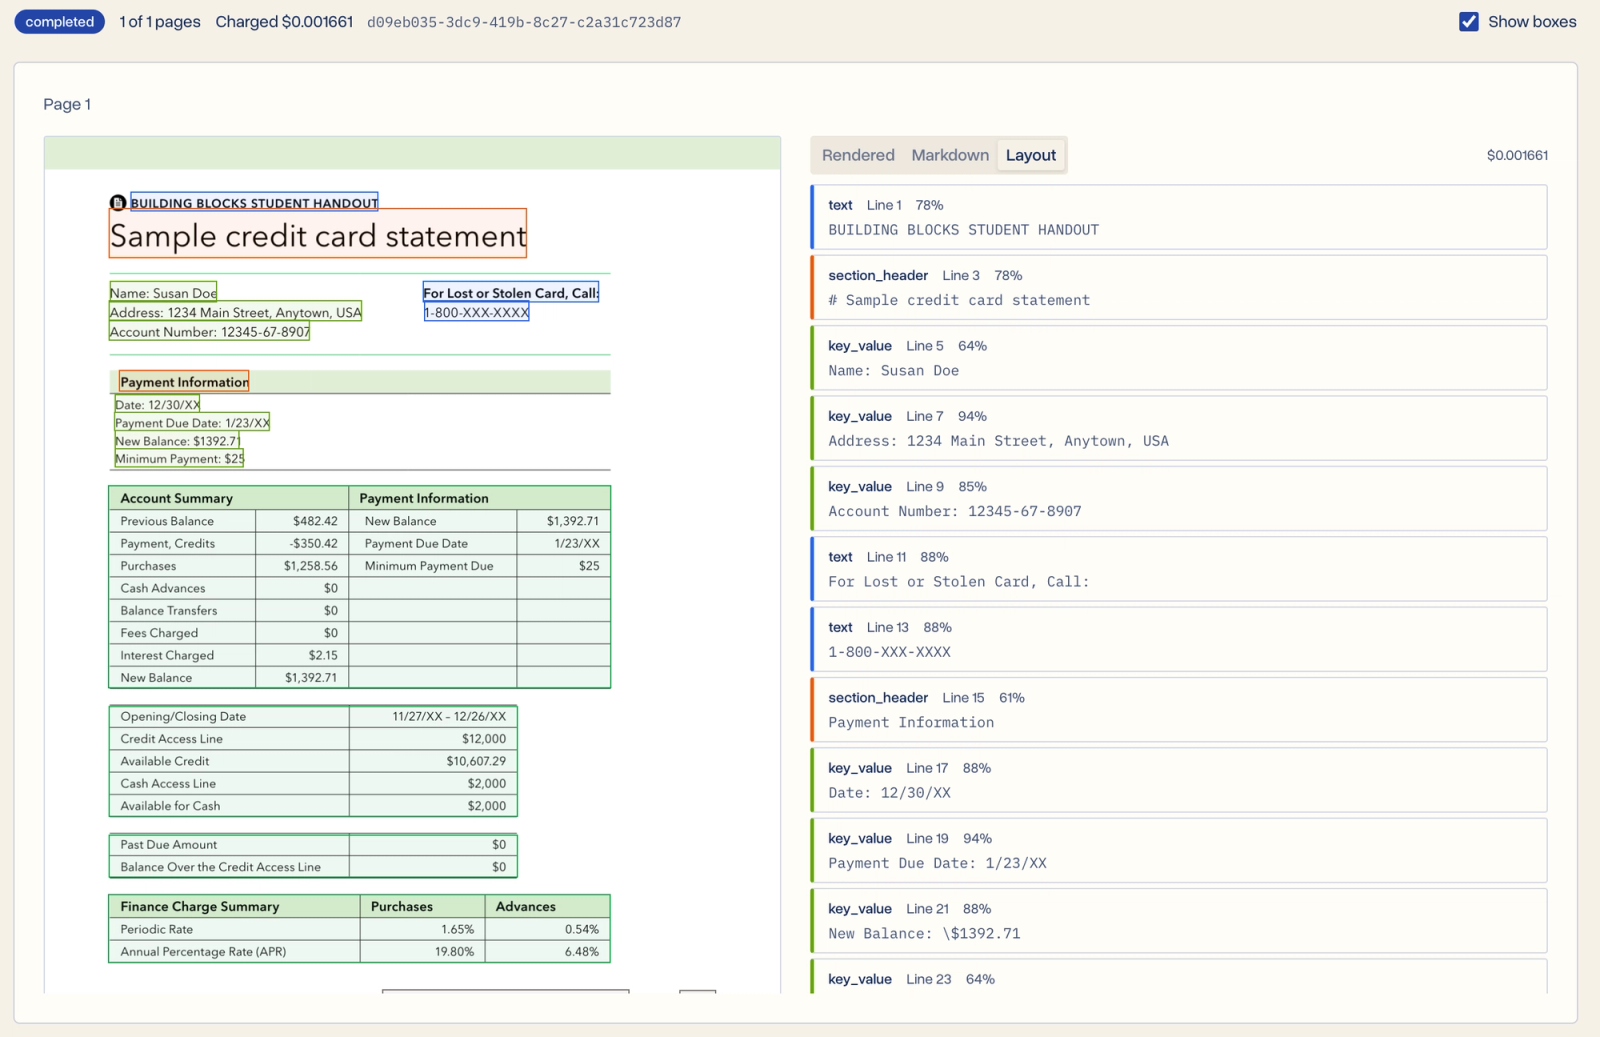
LlamaIndex가 10월 7일(현지 시간) OpenDocRouter를 열었어요. 쉽게 말하면 PDF·스캔 문서를 글로 바꿔 주는 도구를 여러 개 놓고 골라 쓰게 해 주는 창구예요. 개발자가 쓰는 API(프로그램끼리 주고받는 창구)이고, 문서를 보내면 쪽마다 마크다운(제목·표가 표시된 글 형식)으로 돌려줘요.
X 게시물 보기 · https://x.com/llama_index/status/2107863919536595237
왜 만들었나
LlamaIndex는 공식 X에서 Hugging Face에 OCR(그림 속 글자를 읽는 기술) 모델이 약 4,000개 있고, 대형 AI 회사들도 거의 매달 새 모델을 낸다고 적었어요. 그러면서 "Whatever's best for your docs today won't be by Q1"(오늘 내 문서에 가장 잘 맞는 모델이 다음 1분기에는 아닐 것)이라고 했어요.
공식 블로그는 모델을 바꿀 때마다 같은 일이 되풀이된다고 설명해요. 프롬프트(모델에게 주는 지시문) 맞추기, 호출 한도 다루기, 모델을 서버에 올리고 값 관리하기, 새 모델 성능 재기예요. OpenDocRouter는 이 일을 대신 해 두고, 쓰는 사람은 요청의 model 값만 바꾸게 한 서비스예요.
어떤 모델이 있나
블로그가 적은 출시 모델은 10개예요.
- 대형 AI 회사 모델 5개 — Claude Opus 5.5, Gemini 3 Flash, Gemini 3.8 Flash, GPT-5.6 Terra, GPT-6 Luna
- 오픈소스 모델 5개 — Infinity-Parser2-Flash, MinerU2.5-Pro, TeleOCR, dots.mocr, PaddleOCR-VL-1.6
10월 8일 새벽(한국 시간) 모델 표에는 Claude Haiku 5.5가 더해져 11개가 올라와 있어요. 블로그는 새 모델이 나오면 시험을 거쳐 빠르게 더하겠다고 했어요.
점수와 값 (모두 LlamaIndex가 잰 값)
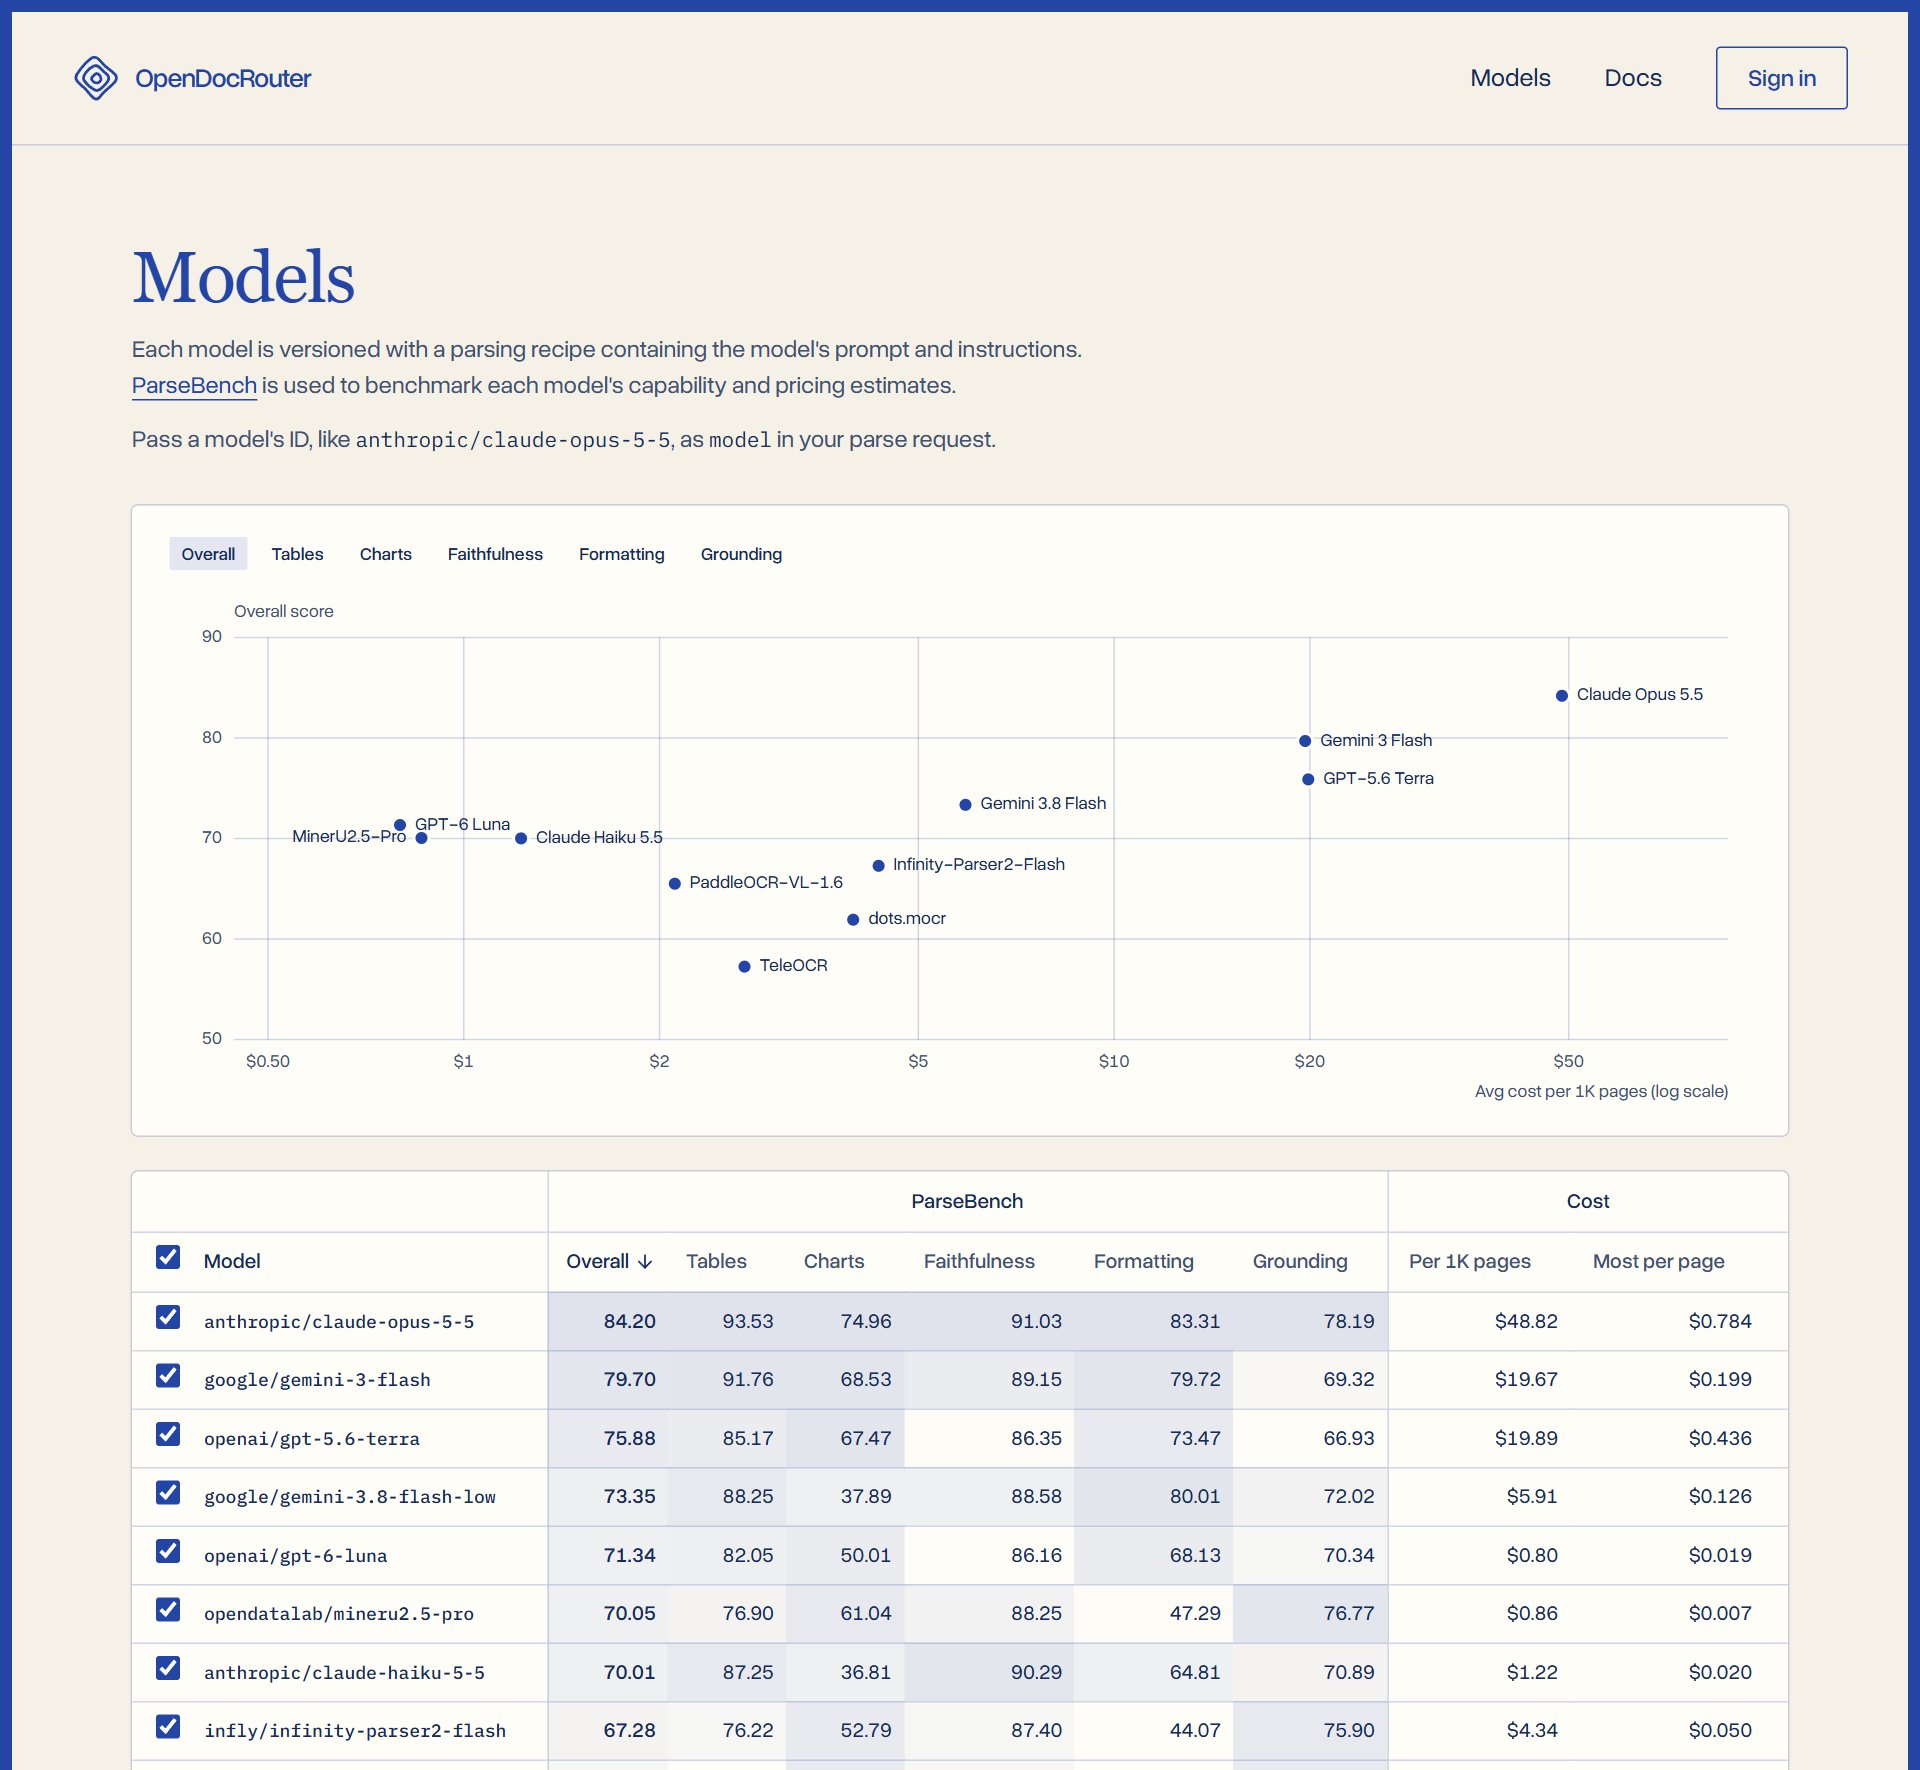
모델마다 ParseBench라는 시험의 점수와 예상 값이 붙어 있어요. LlamaIndex가 블로그에서 "우리 벤치마크"라고 부르는 시험이라, 아래 숫자는 만든 회사의 측정값으로 읽어야 해요. 종합 점수는 표·차트·충실도·서식·위치 표시 다섯 항목의 평균이에요.
| 모델 | 종합 점수 | 1,000쪽 예상 값 |
|---|---|---|
| Claude Opus 5.5 | 84.20 | $48.82 |
| Gemini 3 Flash | 79.70 | $19.67 |
| GPT-5.6 Terra | 75.88 | $19.89 |
| Gemini 3.8 Flash (low) | 73.35 | $5.91 |
| GPT-6 Luna | 71.34 | $0.80 |
| MinerU2.5-Pro | 70.05 | $0.86 |
| Claude Haiku 5.5 | 70.01 | $1.22 |
| Infinity-Parser2-Flash | 67.28 | $4.34 |
| PaddleOCR-VL-1.6 | 65.50 | $2.11 |
| dots.mocr | 61.92 | $3.97 |
| TeleOCR | 57.25 | $2.70 |
1위와 값이 가장 싼 모델의 차이는 종합 점수로 약 13점, 값으로는 약 61배예요($48.82 대 $0.80). 항목별로는 차이가 더 커요. 차트 항목에서 Claude Opus 5.5는 74.96점인데 dots.mocr는 0.84점, TeleOCR는 1.34점이에요. 차트가 많은 문서라면 종합 점수만 보고 고르면 안 된다는 뜻이에요.
1,000쪽 예상 값은 시험 문서에서 쪽마다 쓴 토큰(글을 잘게 자른 조각) 양으로 계산한 값이라, 내 문서에서는 더 들거나 덜 들 수 있다고 모델 표에 적혀 있어요. PaddleOCR-VL-1.6의 값은 모델 표($2.11)와 블로그($2.17)가 조금 달라요. 위 표는 모델 표의 값이에요.
값은 어떻게 내나
- 선불 충전 — $25부터 충전하고, 충전할 때마다 5% 수수료가 붙어요.
- 토큰만큼 — 성공한 쪽마다 쓴 토큰만큼 내요. 대형 AI 회사 모델은 그 회사의 토큰 값 그대로이고 덧붙는 값이 없다고 문서에 적혀 있어요.
- 안 받는 것 — 실패한 쪽, 캐시에서 나온 쪽, 빈 쪽은 무료예요.
- 위치 표시 옵션 — layout을 켜면 100만 토큰당 $0.2가 더 붙어요(블로그).
요청을 시작하려면 '그 모델의 쪽당 최대 값 × 쪽 수'만큼 잔액이 있어야 해요. 그 금액은 처리하는 동안 잡혀 있다가, 쓰지 않은 만큼은 끝난 뒤 풀려요.
쓸 때 알아 둘 것
- 받는 파일 — PDF, PNG, JPEG. 주소로 보내거나 올린 파일은 50MB 또는 500쪽까지예요.
- 한 번에 — 바로 답을 받는 방식은 50쪽까지, 그보다 길면 맡겨 두고 나중에 받는 방식(비동기)으로 500쪽까지예요.
- 쪽마다 따로 — 쪽 하나하나가 따로 처리돼서 상태와 청구액이 쪽마다 나와요. 실패한 쪽만 골라 다시 보내거나 다른 모델로 보낼 수 있어요.
- 위치 표시 — layout을 켜면 제목·표·그림·차트 같은 요소가 페이지 어디에 있는지 네모 좌표로 함께 줘요. 블로그는 어떤 모델을 골라도 같은 15가지 종류로 나온다고 설명해요.
- 보관 — cache를 켜지 않으면 문서와 결과를 저장하지 않는다고 문서에 적혀 있어요. 켜면 결과를 암호화해 24시간 보관해요.
'오픈'은 무엇이 열려 있나
GitHub에 공개된 것은 API를 부르는 SDK(개발 도구 묶음) 두 개예요. 파이썬(opendocrouter-py)과 타입스크립트(opendocrouter-ts)이고 둘 다 MIT(상업적으로도 쓸 수 있는 공개 라이선스)예요. 두 저장소는 10월 7일에 만들어졌어요.
서비스 자체는 LlamaIndex 서버에서 돌아가는 유료 API예요. 서비스의 소스 코드 공개나 내 서버에 설치하는 방법은 사이트·문서·저장소에서 확인하지 못했어요. 블로그는 자체 서버 설치(self-hosted)가 되는 쪽으로 자사의 다른 제품 LlamaParse를 들어요. 목록에 있는 오픈소스 모델 다섯 개의 개별 라이선스도 이 원문들에는 적혀 있지 않았어요.