같은 오픈 모델도 어디서 돌리냐에 따라 비용 최대 2.3배 — Vals 'Inference Provider Index'
Vals AI가 같은 오픈웨이트 모델을 여러 추론 제공사에서 돌려 정확도 · 비용 · 속도를 나란히 잰 순위표를 공개했어요. 전체 정확도는 오차 안이었지만, 비용과 속도는 제공사마다 크게 달랐어요.
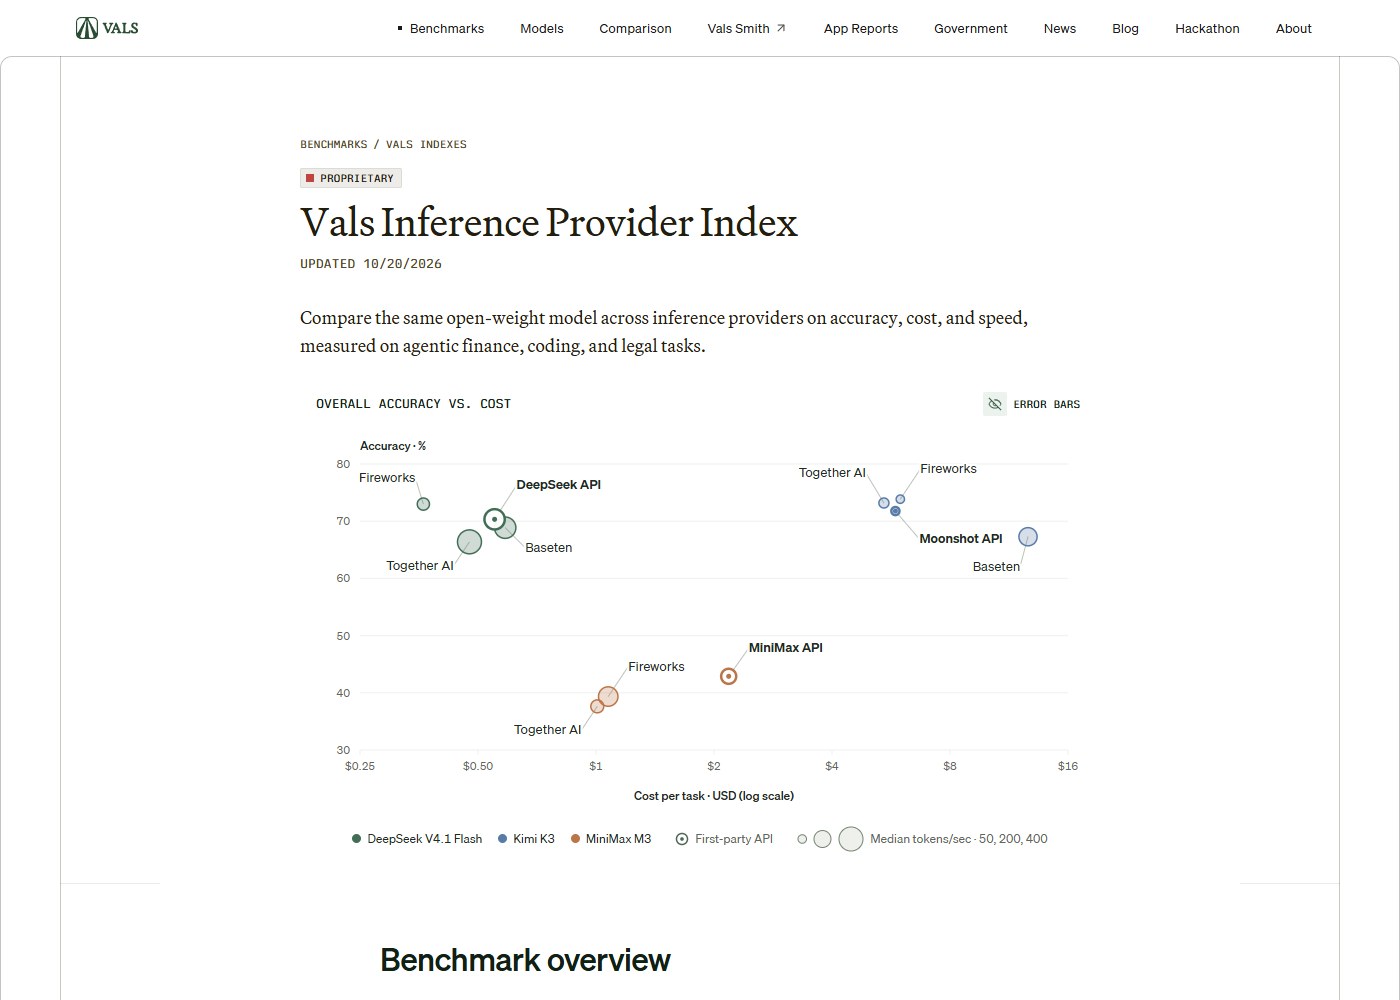
- Vals AI가 DeepSeek V4.1 Flash · Kimi K3 · MiniMax M3를 만든 회사 API와 Together AI · Fireworks · Baseten에서 같은 165개 과제로 돌렸더니, 같은 모델의 비용이 제공사에 따라 최대 2.3배 차이 났어요(10월 20일 업데이트).
- Kimi K3 기준 과제당 비용은 Baseten $12.65, 다른 곳 $5.43~$5.97였고, 생성 속도는 Baseten 초당 229토큰으로 Moonshot API(45토큰)의 다섯 배였어요. 세 모델 모두 만든 회사 API가 가장 싸지도, 가장 빠르지도 않았어요.
- 전체 정확도는 모든 제공사가 만든 회사 API와 오차 범위 안이었어요. 다만 분야 하나만 보면 차이가 났어요 — Kimi K3 법률 점수가 Baseten 60.6%, Moonshot API 75.8%예요.
Kimi K3 · DeepSeek V4.1 Flash · MiniMax M3 같은 오픈 모델을 API로 쓴다면, 제공사를 고르기 전에 이 표에서 과제당 비용 · 첫 토큰 시간 · 캐시 적중률을 먼저 보세요. Vals는 2주마다 다시 잰다고 했으니 고른 뒤에도 한 번씩 확인하면 좋아요.
OpenRouter처럼 요청을 여러 제공사로 나눠 보내는 서비스를 쓴다면, 같은 모델 이름이라도 응답 속도와 비용이 다를 수 있다는 점을 기억해 두세요. MiniMax M3는 Together AI($1.01)에서 MiniMax API($2.18)의 절반쯤이었어요.
AI 기능 운영비를 짤 때 '모델'만 정하지 말고 '어느 제공사'까지 정해서 비용을 계산하세요. 같은 모델로도 비용이 두 배 넘게 벌어질 수 있어요.

오픈 모델을 API로 쓰는 자동화가 있다면, 같은 작업 몇 개를 제공사만 바꿔 돌려 비용과 응답 시간을 나란히 적어 보는 데 써 보면 좋을 것 같아요.
Vals AI가 벤치마크(성능 시험) Vals Inference Provider Index를 공개했어요. Vals 소식 페이지에는 10월 22일 'Introducing the Vals Inference Provider Index: does it matter where you run an open-weight model?'라는 제목으로 올라왔고, 순위표는 10월 20일 업데이트예요.
무엇을 쟀나
오픈웨이트 모델(가중치가 공개된 모델)은 만든 회사 말고도 여러 추론 제공사(모델을 대신 돌려 주는 API 회사)가 서비스해요. 제공사마다 하드웨어 · 캐싱 · 도구 호출 해석 방식이 달라서 결과가 바뀐다고 Vals는 설명해요. 그래서 같은 모델을 제공사별로 같은 에이전트 과제에 돌리고, 만든 회사 API와 정확도 · 과제당 비용 · 속도를 과제마다 비교했어요.
- 모델과 제공사 — DeepSeek V4.1 Flash(DeepSeek · Together AI · Fireworks · Baseten), Kimi K3(Moonshot AI · Together AI · Fireworks · Baseten), MiniMax M3(MiniMax · Together AI · Fireworks). MiniMax M3는 평가 당시 Baseten Model APIs에서 쓸 수 없었어요.
- 과제 — 조합마다 165개. Finance Agent v2 66개(기업 공시로 금융 분석), Vibe Code Bench 33개(명세서대로 웹 앱 만들기), Legal Research 66개(미국 법률 리서치).
- 조건 — 모든 제공사가 같은 에이전트와 과제를 쓰고, 프롬프트 캐싱은 모든 제공사에서 켰어요. 한 모델의 제공사들은 거의 같은 시간에 돌렸어요.
비용 — 최대 2.3배
- 같은 모델의 비용이 제공사에 따라 최대 2.3배 차이 났어요.
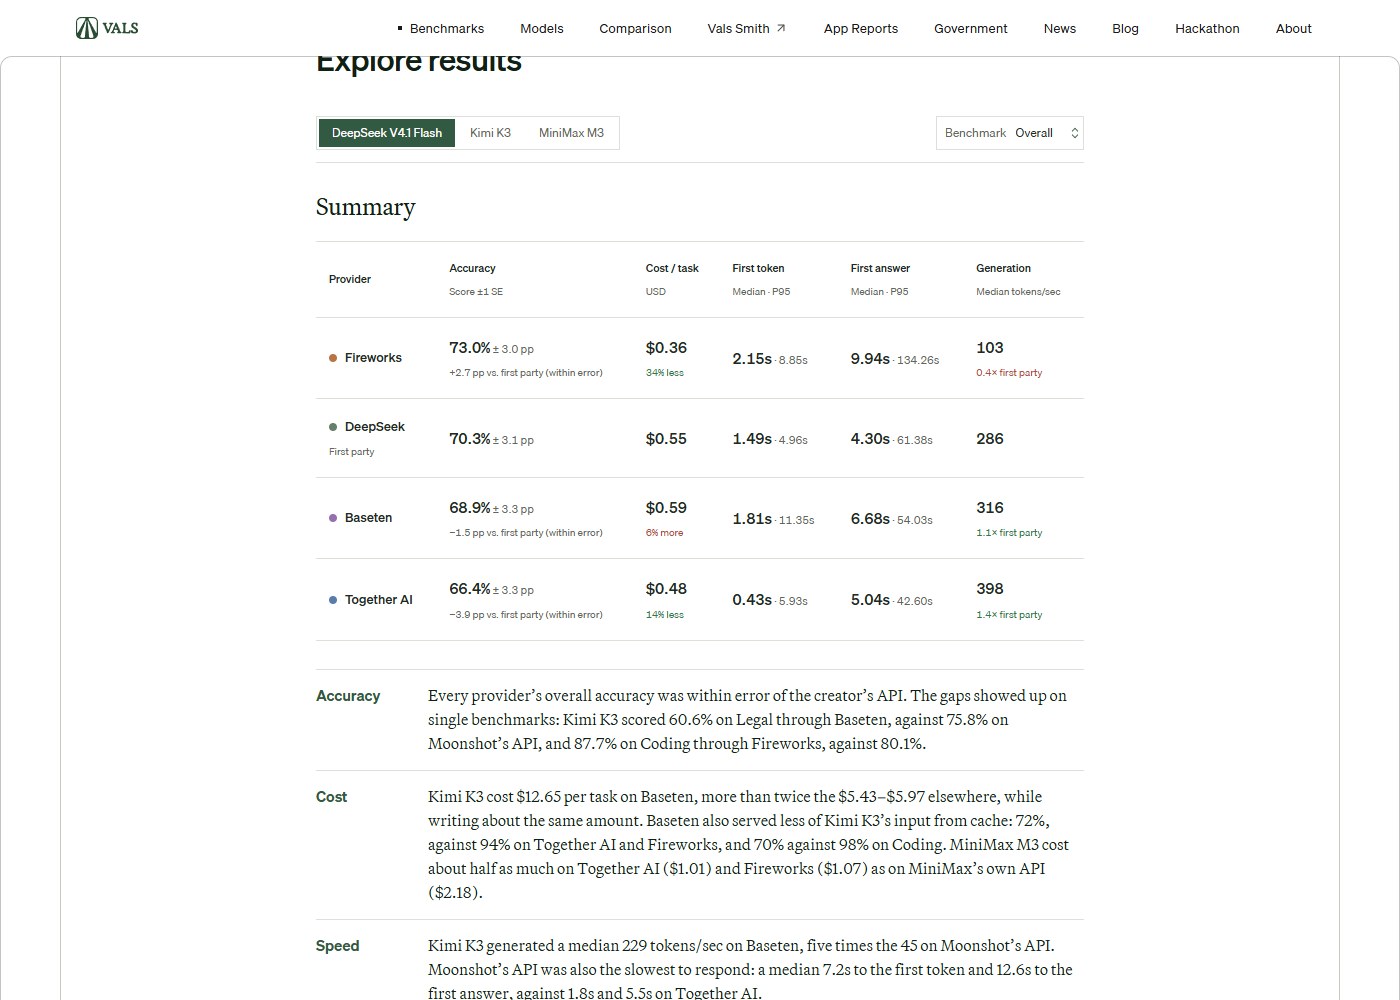
- Kimi K3 — Baseten은 과제당 $12.65로, 다른 곳($5.43~$5.97)의 두 배가 넘었어요. 만들어 낸 글(출력) 양은 비슷했어요. Baseten은 입력 중 캐시에서 처리한 몫도 72%로, Together AI · Fireworks(94%)보다 낮았어요(코딩 과제만 보면 70% 대 98%).
- MiniMax M3 — Together AI $1.01 · Fireworks $1.07로, MiniMax API($2.18)의 절반쯤이었어요.
- DeepSeek V4.1 Flash — 과제당 Fireworks $0.36 · Together AI $0.48 · DeepSeek API $0.55 · Baseten $0.59였어요.
속도 — 다섯 배 차이도
- Kimi K3는 Baseten에서 초당 229토큰(중간값)을 만들어, Moonshot API(45토큰)의 다섯 배였어요.
- Kimi K3 제공사 가운데 Moonshot API는 응답 시작도 가장 느렸어요 — 첫 토큰까지 7.2초, 첫 답까지 12.6초(중간값). Together AI는 1.8초 · 5.5초였어요.
- 세 모델 모두 만든 회사 API가 가장 싸지도, 가장 빠르지도 않았어요.
정확도 — 전체로는 오차 안
- 모든 제공사의 전체 정확도가 만든 회사 API와 오차 범위 안이었어요. DeepSeek V4.1 Flash는 Fireworks 73.0% · DeepSeek API 70.3% · Baseten 68.9% · Together AI 66.4%예요.
- 분야 하나만 보면 차이가 났어요. Kimi K3는 법률에서 Baseten 60.6% · Moonshot API 75.8%, 코딩에서 Fireworks 87.7% · Moonshot API 80.1%였어요.
- 도구 호출 실패율은 같은 모델 · 같은 분야에서 제공사끼리 약 2%p 안이었어요. 금융 · 코딩은 약 1~6%, 법률은 6~12%가 실패했어요.
왜 이런 표를 만들었나
Vals에 따르면 OpenRouter에서 오픈웨이트 모델이 4월부터 전체 토큰의 절반 넘게, 7월부터는 62% 넘게 차지해요. 또 제공사들은 같은 모델 이름 뒤에서 추론 엔진 · 양자화(모델을 가볍게 줄이는 기술) 같은 것을 바꾸기 때문에 결과가 시간이 지나며 달라질 수 있다고 적었어요. 그래서 같은 과제 · 같은 설정으로 2주마다 다시 잰다고 해요.