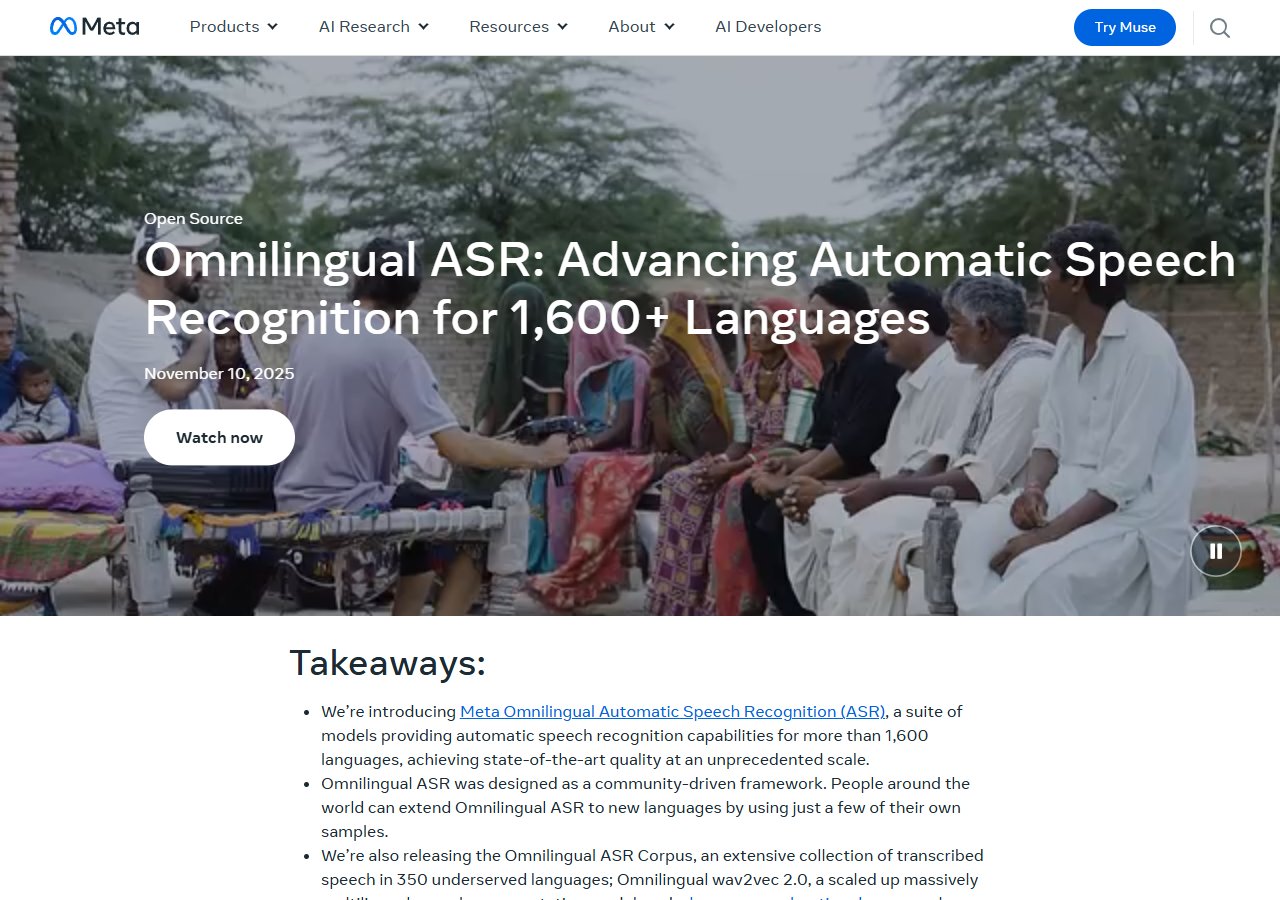
Meta Omnilingual ASR, TIME '올해의 발명품' 선정 — 1,600개 언어를 알아듣는 오픈소스 음성 인식
Meta가 작년 11월 공개한 Omnilingual ASR이 TIME '2026 올해의 발명품'에 올랐어요. 1,600개 이상의 언어를 인식하고, 그중 500개는 AI가 처음 받아쓰는 언어입니다. 모델은 Apache 2.0 오픈소스예요.
- Meta가 2025년 11월 공개한 Omnilingual ASR은 1,600개 이상의 언어를 인식해요. 그중 500개는 이전에 어떤 AI도 받아쓰지 못했던 언어입니다.
- wav2vec 2.0 기반으로 300M·1B·3B·7B 크기가 있고, 모델은 Apache 2.0·데이터는 CC-BY로 공개됐어요. 7B LLM-ASR 모델 기준으로 지원 언어의 78%에서 글자 오류율(CER)이 10 미만입니다.
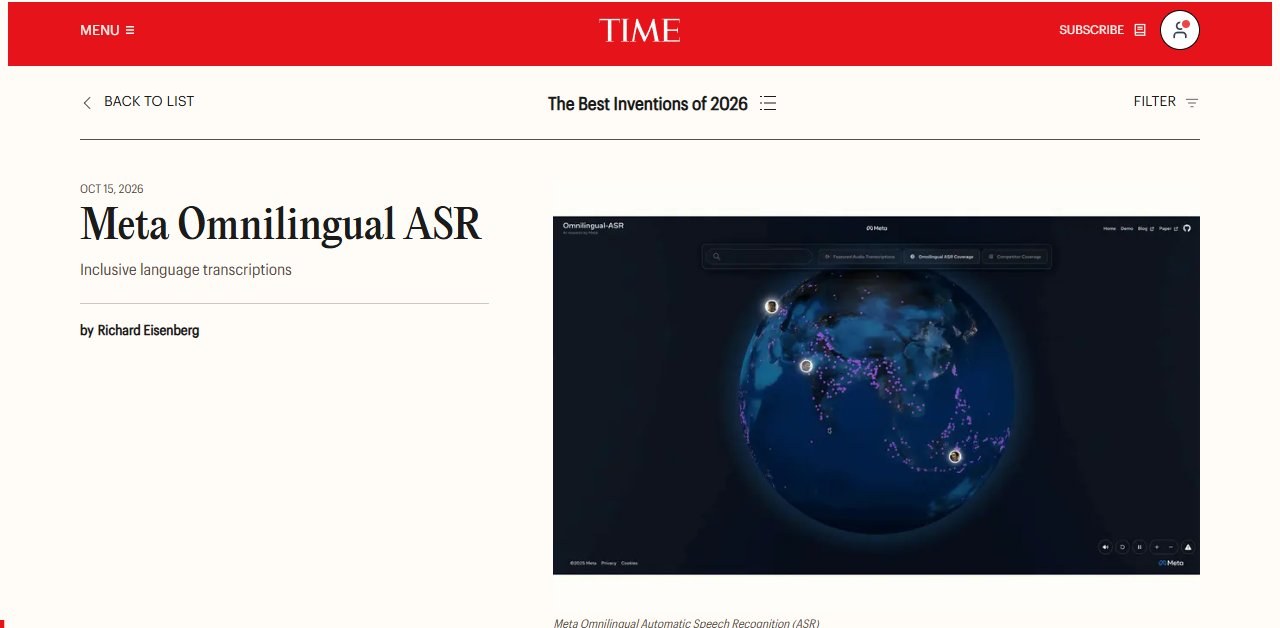
- TIME이 '2026 올해의 발명품(Best Inventions of 2026)'에 선정했어요. 나이지리아에서는 의료진이 지역 진료소의 환자 진료 개선에 쓰고 있습니다.
소수 언어를 다루는 앱에 오픈소스 ASR을 붙일 수 있어요. 가벼운 CTC 300M 모델은 저사양 기기용이고, 7B 모델은 정확도가 더 높습니다. GitHub에서 Apache 2.0으로 바로 쓸 수 있어요.
해외 시장 콘텐츠의 음성을 텍스트로 바꿔 번역 초안을 만들 때 활용할 수 있어요. 기존 음성 인식이 다루지 못하던 소수 언어까지 넓게 지원하는 게 강점입니다.
다국어 고객 상담 녹음을 텍스트로 변환하는 파이프라인에 붙여 볼 수 있어요. 다만 호스팅 API는 없고(Hugging Face 데모만 있음) 직접 모델을 돌려야 해서 기술 허들이 있습니다.
1. 설치: pip install omnilingual-asr
2. 모델 고르기: 300M · 1B · 3B · 7B 중 선택 (가벼운 기기면 CTC 300M)
3. 파이썬에서 ASRInferencePipeline(model_card="omniASR_LLM_Unlimited_7B_v2") 로 음성 파일 받아쓰기 — CTC·LLM 모델은 40초보다 짧은 음성만, Unlimited 모델은 길이 제한 없음
4. 출력된 텍스트를 번역 API에 연결해 다국어 파이프라인 완성
다국어 자막이 필요한 영상 작업에서 소수 언어까지 커버하고 싶을 때 시험해 보면 좋을 것 같아요.
Meta가 2025년 11월 공개한 Omnilingual ASR(Automatic Speech Recognition)이 TIME '올해의 발명품'에 올랐어요. 1,600개 이상의 언어를 알아듣는 음성 인식 모델 세트인데, 그중 500개 언어는 지금까지 어떤 AI도 받아쓴 적 없는 언어입니다.
규모와 구조
모델은 wav2vec 2.0을 기반으로 자기지도학습(self-supervised learning)으로 사전훈련됐어요. 크기는 300M · 1B · 3B · 7B 네 가지가 있습니다(12월에 v2 업데이트). 디코더는 두 종류 — CTC 기반 디코더와 트랜스포머 디코더(LLM-ASR)를 제공해요.
7B LLM-ASR 모델 기준으로 지원 언어의 78%에서 글자 오류율(CER, Character Error Rate)이 10 미만이에요. 300M 모델은 저전력 기기에서 돌릴 수 있고, 7B 모델은 정확도를 최대로 끌어올릴 때 쓸 수 있습니다.
함께 공개된 것들
Meta는 모델과 함께 세 가지를 더 공개했어요.
- Omnilingual ASR Corpus — 350개 소외 언어의 음성·텍스트 짝 데이터
- Omnilingual wav2vec 2.0 — 대규모 다국어 음성 표현(representation) 모델
- 언어 탐색 데모 — 지원 언어를 직접 둘러보고 들어 볼 수 있는 데모
모델은 Apache 2.0, 데이터는 CC-BY 라이선스예요.
TIME '올해의 발명품' 선정
TIME은 Omnilingual ASR을 '2026 올해의 발명품(Best Inventions of 2026)'에 선정했어요. 전 세계 약 7,000개 언어가 있지만 기존 음성 인식 서비스가 다루는 언어는 극히 일부였는데, 이 격차를 크게 좁혔다는 평가입니다.
모델은 몇 개의 음성 샘플만으로 새 언어를 익힐 수 있게 설계됐어요. 나이지리아에서는 의료진이 지역 진료소의 환자 진료를 개선하는 데 Omnilingual ASR을 쓰고 있습니다. 프로젝트 리드 연구원 Jean Maillard는 TIME에 "기술이 가능한 한 많은 언어를 지원하도록 하는 데 열정을 갖고 있다"고 밝혔습니다.
X 게시물 보기 · https://x.com/aiatmeta/status/2110861420321759269