금융 · 코딩 · 법률 · 세금 일을 묶은 Vals Index v2.2 — 1위 Claude Sonnet 5.5 70.85%, 다만 '대체 모델' 답을 빼면 Gemini 4 Argon이 1위
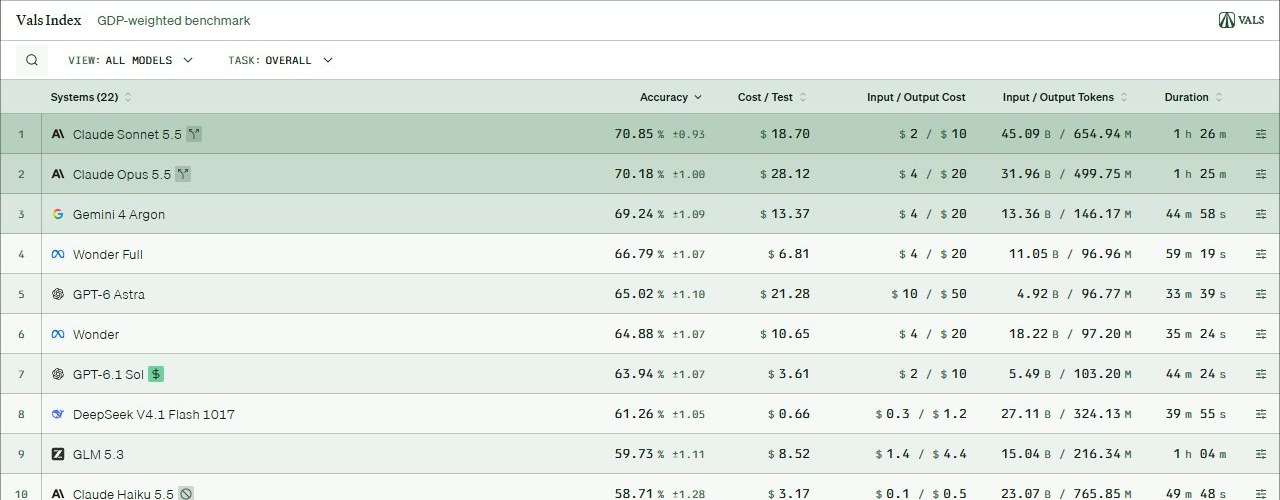
벤치마크 회사 Vals AI가 10월 19일 Vals Index를 v2.2로 올렸어요. 구성 평가 4개를 새 버전으로 바꾸고 세금 평가는 'all-pass' 기준으로 바꿨어요. 1~3위 차이는 1.61%p예요.
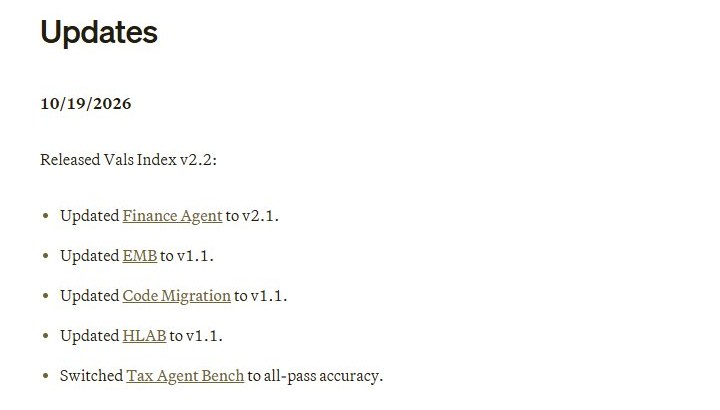
- Vals AI가 10월 19일 Vals Index v2.2를 냈어요. Finance Agent v2.1 · EMB v1.1 · Code Migration v1.1 · HLAB v1.1로 바꾸고, Tax Agent Bench는 all-pass accuracy로 바꿨어요.
- 1위 Claude Sonnet 5.5 70.85%, 2위 Claude Opus 5.5 70.18%, 3위 Gemini 4 Argon 69.24%예요. 22개 모델 기준이에요.
- 원문은 Sonnet 5.5 · Opus 5.5 점수에 '제공사 거절 뒤 대체(fallback) 모델이 푼 문제'가 섞여 있다고 밝혔어요. 이를 실패로 치면 69.03% · 64.16%가 되고, 대체가 없던 Gemini 4 Argon이 1위가 된대요.
코딩 에이전트 모델을 고를 때 원문의 Code Migration v1.1 표(1위 Claude Sonnet 5.5 86.88%)와 언어별 통과율을 같이 보고, 내가 옮기려는 언어 쪽 점수가 높은 모델부터 시험해 볼 수 있어요.
모델 비교 콘텐츠를 만들 때 '1위'만 쓰지 말고 원문의 대체(fallback) 각주처럼 기준에 따라 순위가 바뀐다는 점을 함께 적으면 더 정확한 글이 돼요.
엑셀 재무 모델 · 세금 · 법률 리서치처럼 실제 업무에 AI를 붙일지 볼 때, 전체 점수보다 해당 분야 칸(예: Tax Agent 1위 Claude Opus 5.5 45.57%)을 먼저 확인해 볼 수 있어요. 점수당 비용(Cost / Test) 칸도 같이 보면 좋아요.
1. 원문 리더보드(vals.ai/benchmarks/vals_index)를 열어요.
2. 표 위 'TASK' 메뉴에서 내 일에 가까운 평가(예: Finance Agent, Code Migration)를 골라요.
3. Accuracy와 Cost / Test를 나란히 보고 후보 2~3개를 골라요.
4. 이름 옆 갈래 아이콘이 있는 모델은 대체(fallback) 답이 섞인 줄이니, 아이콘을 눌러 어떤 문제인지 확인해요.
5. 후보 모델에 내 실제 업무 예시를 넣어 직접 비교해요.

모델을 고를 때 전체 1위보다 내 일에 맞는 칸의 점수와 테스트당 비용을 나란히 보는 데 쓰면 좋을 것 같아요. 다만 이번처럼 대체 모델 답을 어떻게 세느냐로 1위가 바뀔 수 있어서, 1~3위 차이 1~2%p는 같은 수준으로 읽는 게 좋을 것 같아요.
벤치마크 회사 Vals AI가 2026년 10월 19일 종합 지표 Vals Index를 v2.2로 올렸어요. Vals Index는 에이전트(스스로 여러 단계를 실행하는 AI) 방식으로 금융 · 코딩 · 법률 · 세금 일을 풀게 하고, 분야마다 미국 GDP 비중으로 가중치를 줘서 한 점수로 합친 지표예요. 원문은 비공개 평가 6개와 공개 평가 2개를 묶는다고 설명해요.
v2.2에서 바뀐 것
- Finance Agent를 v2.1로 올렸어요. 전문가 검토 뒤 일부 문제를 고치거나 빼고 채점 기준도 손봤어요. 채점단(심사 AI 3개)은 GPT-6.1 Sol · Gemini 3.8 Flash · Claude Sonnet 5.5로 바뀌었고, 값을 두 개 이상 내놓고 하나로 정하지 않는 '얼버무린 답'은 이제 실패로 쳐요. 원문은 "v2 점수와 비교할 수 없다"고 적었어요.
- EMB(엑셀로 재무 모델을 만드는 평가)를 v1.1로 올렸어요.
- Code Migration(프로그램을 다른 언어로 다시 짜는 평가)을 v1.1로 올렸어요. 모든 모델을 mini-SWE-agent 대신 Pi 에이전트 하네스(모델을 돌리는 틀)로 돌리고, 고친 숨은 테스트로 채점해요. 과제는 같지만 v1과 바로 비교할 수 없대요.
- HLAB(Harvey의 법률 에이전트 평가)를 v1.1로 올렸어요.
- Tax Agent Bench는 채점을 all-pass accuracy로 바꿨어요.
순위 (10월 19일 기준, 22개 모델)
- 1위 Claude Sonnet 5.5 70.85% — 테스트당 비용 $18.70
- 2위 Claude Opus 5.5 70.18% — $28.12
- 3위 Gemini 4 Argon 69.24% — $13.37
- 4위 Wonder Full 66.79% ($6.81), 5위 GPT-6 Astra 65.02% ($21.28), 6위 Wonder 64.88%, 7위 GPT-6.1 Sol 63.94% ($3.61), 8위 DeepSeek V4.1 Flash 1017 61.26% ($0.66)
원문은 "모든 분야에서 1등인 모델은 없다"고 정리했어요. Claude Opus 5.5는 Finance Agent v2.1(67.85%) · Terminal-Bench 4.0(65.15%) · Tax Agent(45.57%), Claude Sonnet 5.5는 EMB v1.1(75.90%) · Vibe Code Bench v1.1(92.39%) · Code Migration v1.1(87.37%), Gemini 4 Argon은 Legal Research(54.81%) · HLAB v1.1(27.08%)에서 1위예요.
참고로 Code Migration은 지표 안에서 전체 120개 과제 중 50개 + COBOL 10개를 고른 부분 집합으로 채점해요. 그래서 지표 칸의 Sonnet 5.5 점수(87.37%)와 Code Migration 단독 리더보드 점수(86.88%)가 조금 달라요.
각주 하나가 1위를 바꿔요
원문은 Claude Sonnet 5.5와 Claude Opus 5.5의 점수에 "제공사 거절 뒤 대체(fallback) 모델이 푼 문제"가 일부 들어 있다고 밝혔어요. 이것을 실패로 세면 Sonnet 5.5는 69.03%, Opus 5.5는 64.16%로 내려가고, 대체가 없었던 Gemini 4 Argon(69.24%)이 1위가 된다고 적었어요. 리더보드에서 해당 줄에는 갈래 모양 아이콘이 붙어 있어요.
점수는 이렇게 합쳐요
분야 가중치는 미국 GDP 비중이에요: 금융 약 8.0% · 코딩 약 5.6% · 법률 약 1.2% · 세금 약 0.5%. 식은 (8.0×금융 + 5.6×코딩 + 1.2×법률 + 0.5×세금) ÷ 15.3이에요. 금융은 Finance Agent v2.1과 EMB v1.1의 평균, 코딩은 Terminal-Bench 4.0 · Vibe Code Bench v1.1 · Code Migration v1.1의 평균, 법률은 Legal Research와 HLAB v1.1의 평균, 세금은 Tax Agent Bench예요. 원문도 이것이 경제 영향을 "크게 단순화한 것"이라고 적었어요.