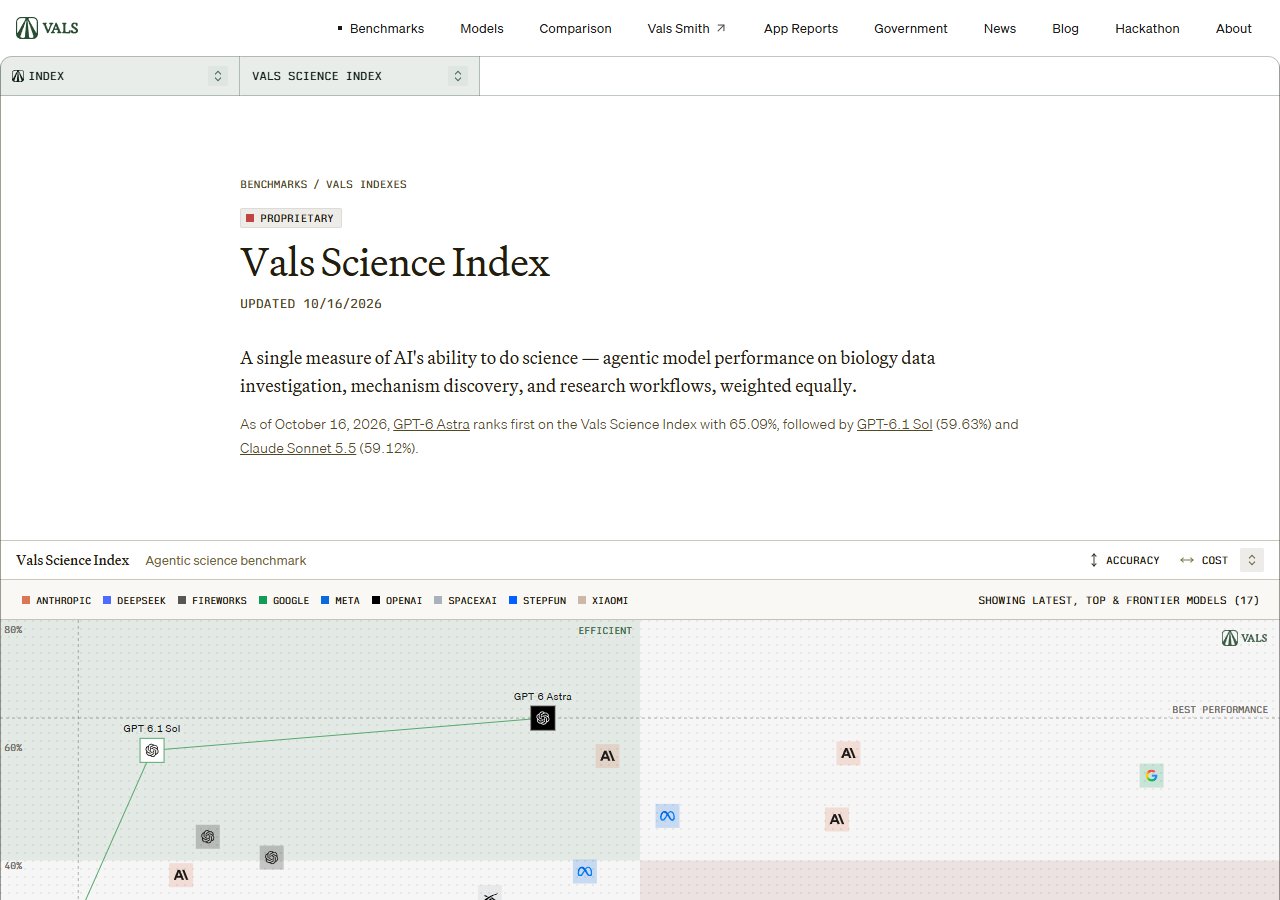
Vals AI 과학 지수에서 GPT-6 Astra가 65.09%로 1위, 종합 1위 Gemini 4 Argon은 5위예요
AI 벤치마크 회사 Vals AI가 과학 분야 에이전트 능력을 측정하는 Science Index를 공개했어요. GPT-6 Astra가 65.09%로 1위지만, 종합 Vals Index에서는 7위에 머물러요.
- Vals AI가 10월 16일 Science Index를 공개했어요. 생물 데이터 조사(BioMysteryBench), 메커니즘 발견(MysteryMechanism), 연구 워크플로(Terminal-Bench-Science) 세 벤치마크의 평균으로, AI 모델의 과학 연구 에이전트 능력을 측정해요.
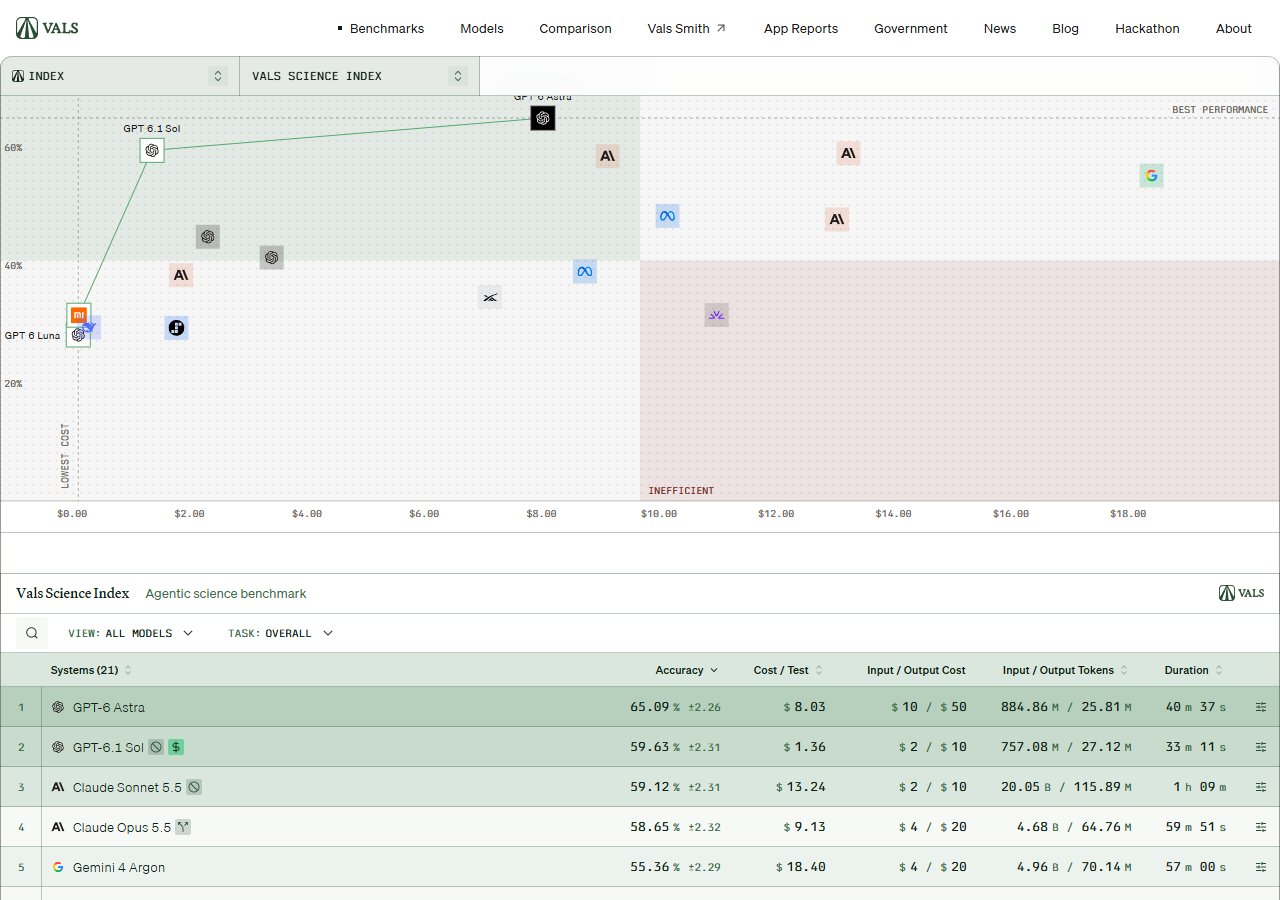
- GPT-6 Astra가 65.09%로 1위예요. GPT-6.1 Sol(59.63%), Claude Sonnet 5.5(59.12%), Claude Opus 5.5(58.65%), Gemini 4 Argon(55.36%)이 뒤를 이어요. 21개 모델이 평가됐어요.
- GPT-6 Astra는 종합 Vals Index에서 7위에 머물러요. 과학 분야에서 특히 강하지만 종합 1위는 Gemini 4 Argon이에요(과학 지수에선 5위). 모델마다 강한 분야가 달라요.
과학·연구 데이터를 다루는 에이전트를 만들 때, Vals Science Index 순위를 모델 선택 기준 하나로 참고할 수 있어요. GPT-6 Astra가 과학 분야 1위지만 종합 7위이므로, 범용 작업과 과학 작업을 구분해서 모델을 골라야 해요.
AI 모델 비교 콘텐츠를 만들 때, '종합 순위와 분야별 순위가 다를 수 있다'는 시각으로 풀면 차별화된 글감이 돼요. Vals AI 사이트에서 정확도와 비용을 함께 보는 산점도 차트를 참고할 수 있어요.
AI 도구를 고를 때 '1위 모델이 모든 분야에서 1위는 아니다'라는 점을 기억하면, 내 작업 분야에 맞는 모델을 고르는 데 도움이 돼요.
모델별로 강한 분야가 다르다는 걸 보여 주는 벤치마크라서, 도구를 고를 때 '종합 순위만 보지 말고 내 작업 분야 순위를 확인하자'는 관점으로 참고하면 좋을 것 같아요.
AI 벤치마크 회사 Vals AI가 10월 16일 Science Index를 공개했어요. AI 모델이 과학 연구를 에이전트로 수행하는 능력을 하나의 숫자로 보여 주는 지수예요.
세 벤치마크의 평균
Science Index는 세 가지 벤치마크를 동일 가중치로 평균해요.
- BioMysteryBench — 생물 데이터셋을 조사해 열린 질문에 답하는 과제
- MysteryMechanism — 실험을 설계해 숨겨진 메커니즘을 찾아내는 과제
- Terminal-Bench-Science — 생명과학·물리·지구과학·수학·공학 분야의 연구 워크플로 과제
상위 5위
| 순위 | 모델 | 정확도 | 시험당 비용 |
|---|---|---|---|
| 1 | GPT-6 Astra | 65.09% | $8.03 |
| 2 | GPT-6.1 Sol | 59.63% | $1.36 |
| 3 | Claude Sonnet 5.5 | 59.12% | $13.24 |
| 4 | Claude Opus 5.5 | 58.65% | $9.13 |
| 5 | Gemini 4 Argon | 55.36% | $18.40 |
21개 모델이 평가됐어요. 6위부터는 Wonder Full(48.54%), Claude Opus 5(47.93%), GPT-6 Sol(45.00%) 순이에요.
종합 순위와의 차이
GPT-6 Astra는 Science Index에서 1위지만, 종합 Vals Index에서는 7위에 머물러요. 종합 지수에서는 다른 모델이 앞서요.
반대로 2위 GPT-6.1 Sol은 시험당 비용이 $1.36으로 1위 GPT-6 Astra($8.03)의 약 6분의 1이면서 정확도 차이는 5.46%p예요. 비용 대비 성능을 따지면 눈여겨볼 만해요.
X 게시물 보기 · https://x.com/valsai/status/2111205341237256554