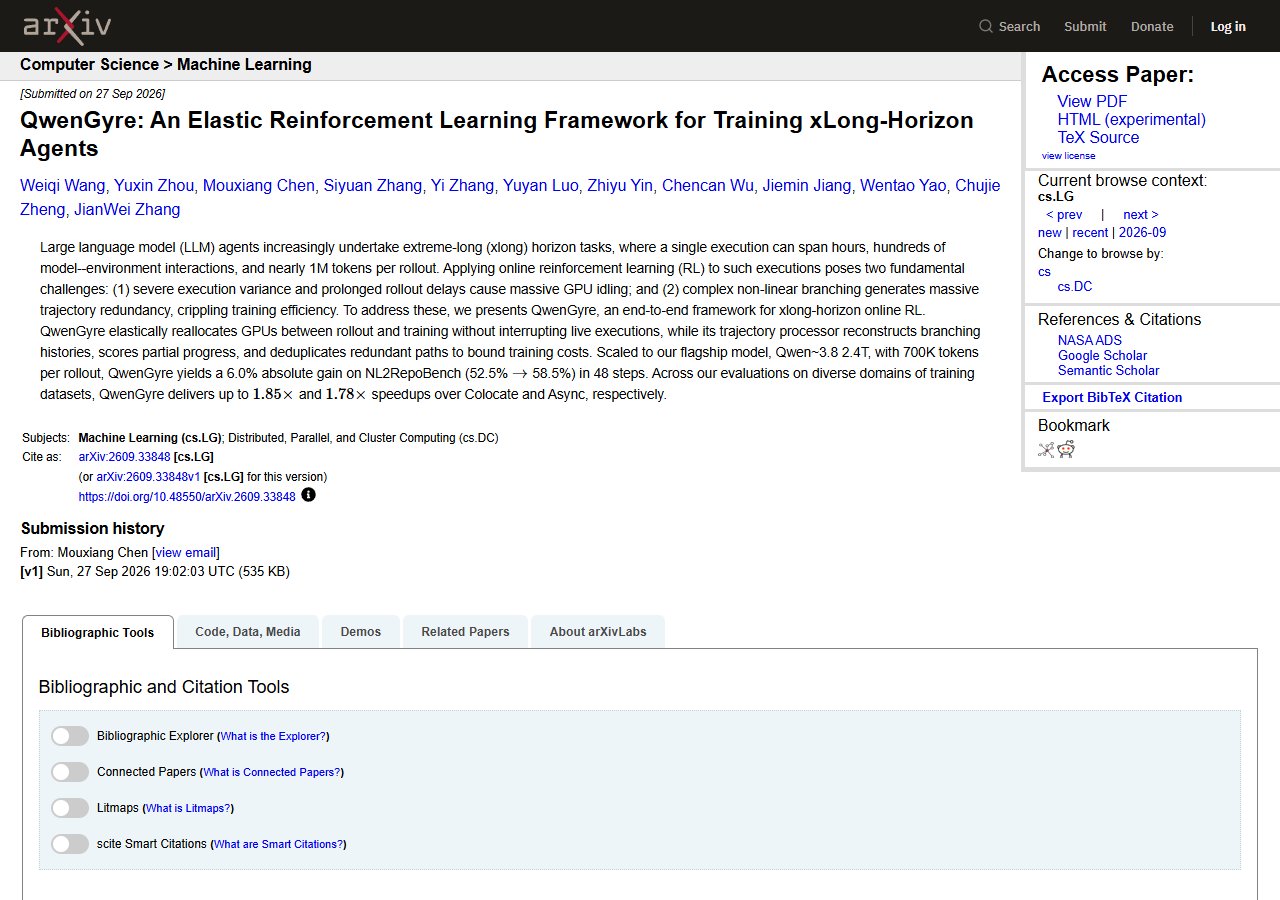
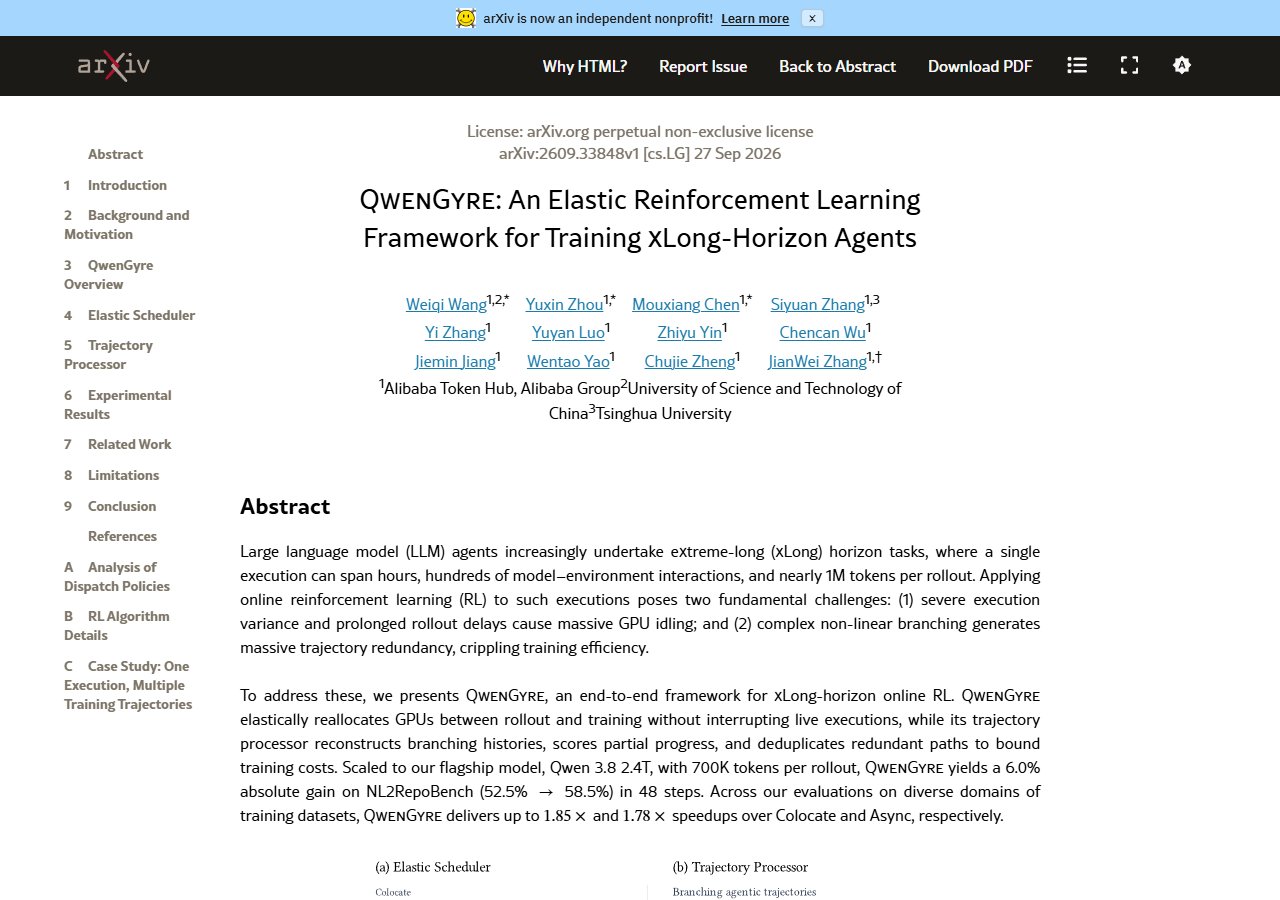
QwenGyre — 몇 시간짜리 에이전트 학습, GPU를 탄력 배분해 최대 1.85배 빨라졌어요 (Qwen 3.6 122B 기준)
알리바바 Qwen 팀이 롤아웃과 학습 사이에서 GPU를 실시간으로 재배치하는 강화학습 프레임워크 QwenGyre를 공개했어요. Qwen 3.8 2.4T 기준으로 Async 방식보다 학습 시간이 약 44% 짧았고(134.6시간 → 75.4시간), 정확도는 6%p 올랐어요.
- QwenGyre는 롤아웃(환경 실행)과 모델 학습 사이에서 GPU를 탄력적으로 재배분하는 강화학습 프레임워크예요. 실행 중인 롤아웃을 끊지 않고도 남는 GPU를 학습에 돌려요.
- Qwen 3.8 2.4T 모델 기준 NL2RepoBench에서 정확도가 52.5%에서 58.5%로 6.0%p 올랐어요. 48스텝 학습에 걸린 시간은 75.4시간으로, Async 방식(134.6시간)보다 약 44%, Colocate 방식(91.5시간)보다 약 17.5% 짧았어요.
- 속도는 Qwen 3.6 122B의 TerminalBench에서 Colocate 대비 최대 1.85배(Async 대비는 1.38~1.43배), Qwen 3.8 2.4T의 NL2RepoBench에서 Async 대비 1.78배(Colocate 대비 1.21배)였어요. 롤아웃 하나가 수 시간, 70만~100만 토큰에 달하는 환경에서 잰 값이에요.
수 시간짜리 에이전트 태스크를 RL로 학습할 때 GPU 유휴를 줄이는 탄력 스케줄링 설계를 참고할 수 있어요. Elastic Scheduler의 waterlevel 알고리즘은 자체 학습 인프라에 바로 적용해 볼 만해요.
Trajectory Processor가 분기 이력을 재구성하고 중복 경로를 제거하는 방식은, 긴 에이전트 궤적에서 학습 데이터를 효율적으로 뽑는 데 설계 참고가 돼요.
논문에 코드 주소가 없어 당장 써 볼 수는 없지만, Qwen 3.8 급 모델의 에이전트 학습이 어디까지 왔는지 기준점으로 삼을 수 있어요.
1. 논문 읽기: https://arxiv.org/abs/2609.33848 (특히 Section 4 Elastic Scheduler, Section 5 Trajectory Processor)
2. Figure 1의 Elastic Scheduler vs Colocate vs Async 비교 다이어그램으로 GPU 배분 차이 파악
3. Table 2의 벤치마크별 속도 비교에서 자기 태스크와 비슷한 시간 규모(hour-long) 찾기
4. Ablation(Table 1)에서 streaming training과 standalone pool의 각각의 기여도 확인
에이전트 태스크가 길어질수록 GPU가 노는 시간이 문제인데, 롤아웃 중에도 남는 자원을 학습에 돌리는 접근이 깔끔해요. 긴 에이전트 워크플로를 직접 학습시키는 팀이라면 설계를 참고해 볼 만할 것 같아요.
알리바바 Qwen 팀이 QwenGyre를 공개했어요. 한 번 실행에 수 시간, 수백 번의 모델-환경 상호작용, 70만~100만 토큰이 드는 극한 길이(xLong-horizon) 에이전트 태스크를 강화학습으로 훈련하기 위한 프레임워크예요.
왜 필요한가요?
에이전트가 코드 저장소를 통째로 만들거나, 터미널에서 장시간 작업하는 태스크는 롤아웃(rollout, 환경에서 실행해 보는 것) 한 번에 평균 2시간 가까이 걸려요(Qwen 3.6 122B 기준 실행당 평균 1.93시간, 질문 하나당 2.96시간). 기존 방식은 두 가지 문제가 있었어요.
- Colocate 방식 — 같은 GPU에서 롤아웃과 학습을 번갈아 하니, 롤아웃이 끝날 때까지 학습이 멈춰요.
- Async 방식 — GPU를 롤아웃/학습 전용으로 나누니, 한쪽이 바쁠 때 다른 쪽이 놀아요.
QwenGyre의 해법: 두 가지 핵심 모듈
1. Elastic Scheduler(탄력 스케줄러) — GPU 묶음을 '셀' 단위로 관리해요. 롤아웃이 바쁘면 셀을 롤아웃에, 여유가 생기면 학습에 실시간으로 재배치해요. 진행 중인 롤아웃은 끊기지 않아요. 'waterlevel'이라는 지표가 남은 작업량을 추적하고, 여유가 확인될 때만 셀을 학습에 합류시켜요.
2. Trajectory Processor(궤적 처리기) — 에이전트의 분기 실행 이력을 트리 구조로 재구성하고, 공유 접두어(prefix)는 한 번만 손실에 반영해요. 실행당 최대 5개 궤적만 골라 학습 비용을 제한해요.
벤치마크 결과
세 가지 벤치마크에서 기존 방식보다 빨랐어요.
- NL2RepoBench(코드 저장소 생성) — Qwen 3.8 2.4T 기준, 정확도 52.5% → 58.5%(+6.0%p). 48스텝 학습 시간은 QwenGyre 75.4h, Async 134.6h, Colocate 91.5h예요. Async보다 약 44%, Colocate보다 약 17.5% 짧아요(속도로는 Async 대비 1.78배, Colocate 대비 1.21배). 퍼센트는 논문의 시간 값으로 계산한 것이에요.
- TerminalBench(터미널 태스크, Qwen 3.6 122B, 24스텝) — Colocate 대비 최대 1.85배, Async 대비 최대 1.43배 빠름
- DeepSWE(기존 저장소 수정, Qwen 3.6 122B, 24스텝) — Colocate 대비 최대 1.82배, Async 대비 1.57배 빠름
Qwen 3.6 122B의 NL2RepoBench에서도 Async 대비 1.42~1.53배, Colocate 대비 1.36~1.47배 빨랐어요.
설계 트레이드오프
셀을 크게 잡으면 한 번에 배분할 GPU가 많아 유연성이 줄어요(4노드 셀 8개를 8노드 셀 4개로 묶었더니 12스텝 학습 시간이 2.2% 늘었어요). 반대로 너무 잘게 나누면 학습 병렬성이 떨어져요. 또 스트리밍 학습에서 마이크로배치가 도착 순서대로 처리되기 때문에, 전역 셔플이 불가능하다는 제한이 있어요.
공개 범위
논문은 arXiv에 공개돼 있어요(2026년 9월 27일 제출). 논문에는 코드 저장소 주소가 없고, 코드나 모델 가중치를 공개한다는 말도 없어요.