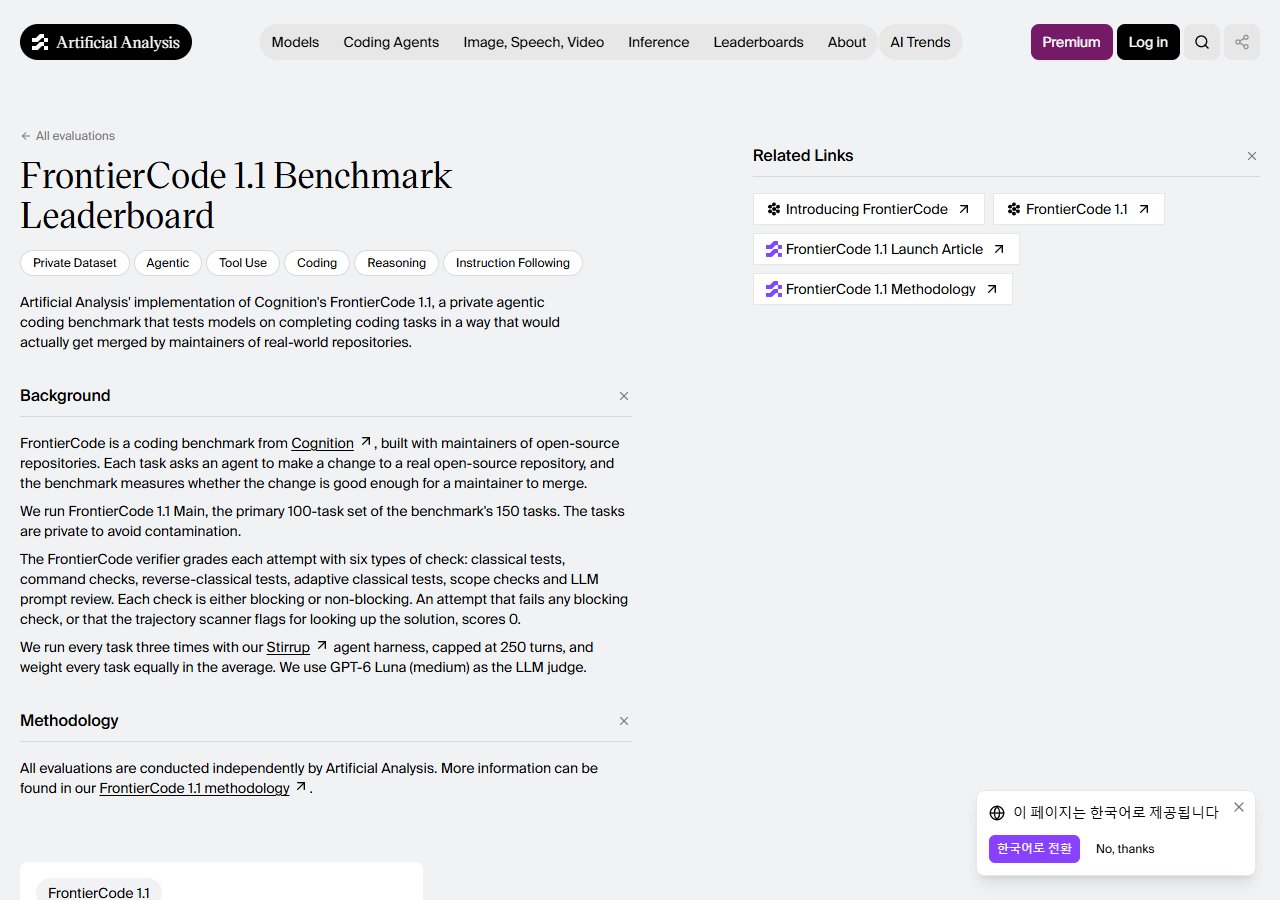
FrontierCode 1.1 — AI가 짠 코드, 진짜 머지될 수준인지 채점해요
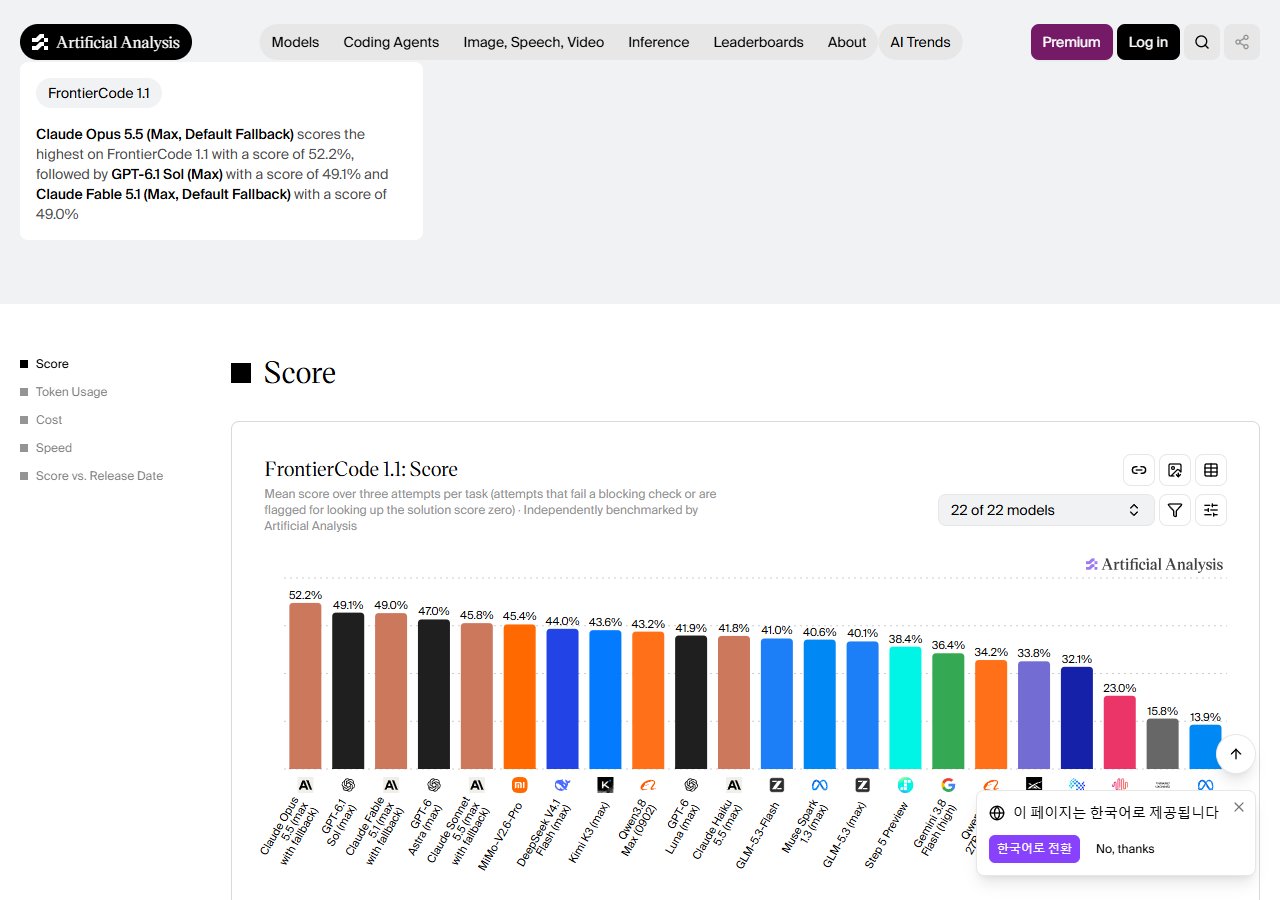
Cognition이 만든 FrontierCode 벤치마크의 1.1 버전을 Artificial Analysis가 22개 모델로 독립 평가했어요. 1위 Claude Opus 5.5가 52.2%, 나머지는 모두 50% 미만이에요.
- FrontierCode 1.1은 AI 코딩 에이전트가 실제 오픈소스 저장소에서 "메인테이너가 머지할 만한 코드"를 짜는지 채점해요. 150개 태스크 중 주요 100개로 평가해요.
- 22개 모델 중 1위는 Claude Opus 5.5(52.2%), 2위 GPT-6.1 Sol(49.1%), 3위 Claude Fable 5.1(49.0%)이에요. 절반을 넘긴 모델은 하나뿐이에요.
- SWE-Bench보다 거짓 양성(false positive)이 81% 적다고 해요. 유닛 테스트·역테스트·스코프 검사·LLM 리뷰까지 6단계로 채점해요.
코딩 에이전트를 고를 때 SWE-Bench 점수만 보지 말고, FrontierCode 점수를 비교해서 실제 코드 리뷰 통과율이 높은 모델을 골라 볼 수 있어요.
코딩 에이전트 비교 콘텐츠를 만들 때 FrontierCode 점수를 인용하면, 기존 벤치마크보다 실전에 가까운 근거가 돼요.
AI로 코드를 짜달라고 할 때, 1위(Opus 5.5)도 52%라는 점을 알면 "AI 결과물도 꼭 사람이 코드 리뷰해야 한다"는 기준이 잡혀요.
코딩 에이전트를 실무에 쓸 때, SWE-Bench 점수와 FrontierCode 점수를 나란히 비교해 보면 어떤 모델이 진짜 머지 가능한 코드를 짜는지 감을 잡는 데 도움이 될 것 같아요.
AI 코딩 에이전트가 테스트만 통과하는 코드가 아니라, 진짜 메인테이너가 머지할 만한 코드를 짜는지 — 이 질문에 답하려고 만든 벤치마크가 FrontierCode예요. Cognition(Devin을 만든 회사)이 2026년 6월에 처음 공개했고, 이번에 1.1 버전을 Artificial Analysis가 독립 평가해 리더보드를 냈어요.
기존 벤치마크와 뭐가 다른가요?
SWE-Bench 같은 기존 코딩 벤치마크는 유닛 테스트 통과만 보는 경우가 많아요. FrontierCode는 6단계 검증을 거쳐요.
- 클래식 유닛 테스트 — 기능이 맞는지
- 커맨드 검사 — 빌드·린트·스타일 통과 여부
- 역(reverse-classical) 테스트 — 에이전트가 쓴 테스트가 일부러 망가뜨린 코드에서 실패하는지
- 적응형 테스트(mutagent) — 구현 방식이 달라도 맞는 답인지
- 스코프 검사 — 고쳐야 할 파일·줄만 건드렸는지
- LLM 리뷰 — 코드 품질·설계 패턴을 GPT-6 Luna(medium)가 심사
각 검사는 블로커(하나라도 실패하면 0점)와 논블로커(품질 신호)로 나뉘어요. Cognition은 이 방식이 SWE-Bench Pro 대비 거짓 양성을 81% 줄였다고 해요.
리더보드 결과 — 절반을 넘긴 모델은 하나
Artificial Analysis가 자체 에이전트 플랫폼 Stirrup으로 22개 모델을 평가했어요. 태스크당 3번 시도, 최대 250턴이에요. 주요 100개 태스크(Main) 기준 상위 결과:
- Claude Opus 5.5 (Max) — 52.2%
- GPT-6.1 Sol (Max) — 49.1%
- Claude Fable 5.1 (Max) — 49.0%
- GPT-6 Astra (Max) — 47.0%
- Claude Sonnet 5.5 (Max) — 45.8%
- MiMo-V2.6-Pro — 45.4%
- DeepSeek V4.1 Flash (Max) — 44.0%
1위 Opus 5.5도 52.2%에요. 실제 오픈소스 메인테이너 기준으로 절반 정도만 머지 수준이라는 뜻이에요. 하위권에는 Gemini 3.8 Flash(34.2%), Qwen(15.8~13.9%) 등이 있어요.
태스크는 어떻게 만드나요?
20명 이상의 오픈소스 메인테이너가 참여해서, 태스크 하나에 평균 40시간 이상 들였다고 해요. 전체 150개(Extended 150, Main 100, Diamond 50) 중 Main 100개를 리더보드에 쓰고, 태스크는 비공개라 데이터 오염이 적어요.
다만
최고 점수가 52%라서 아직 AI 코딩 에이전트가 "사람 없이 머지"하기엔 먼 길이에요. 또 LLM 리뷰 단계의 심사 모델(GPT-6 Luna)이 바뀌면 점수가 달라질 수 있어요. Cognition이 Devin을 만든 회사라서, 벤치마크 설계에 자사 에이전트에 유리한 편향이 있는지는 독립 평가(Artificial Analysis)로 어느 정도 보완하고 있어요.