수백 쪽 PDF를 한 번에 글로 — Baidu 'Unlimited OCR 2' 오픈소스 공개, 길어져도 메모리가 거의 안 늘어요
Baidu가 10월 27일 문서 읽기(OCR) 모델 Unlimited OCR 2를 Hugging Face · GitHub에 MIT 라이선스로 풀었어요. 문서가 길어져도 한 단계 처리 시간과 메모리가 거의 일정하게 유지되도록 만든 게 핵심이고, 100~300쪽 문서로 만든 새 시험 MarathonDocBench도 함께 냈어요.
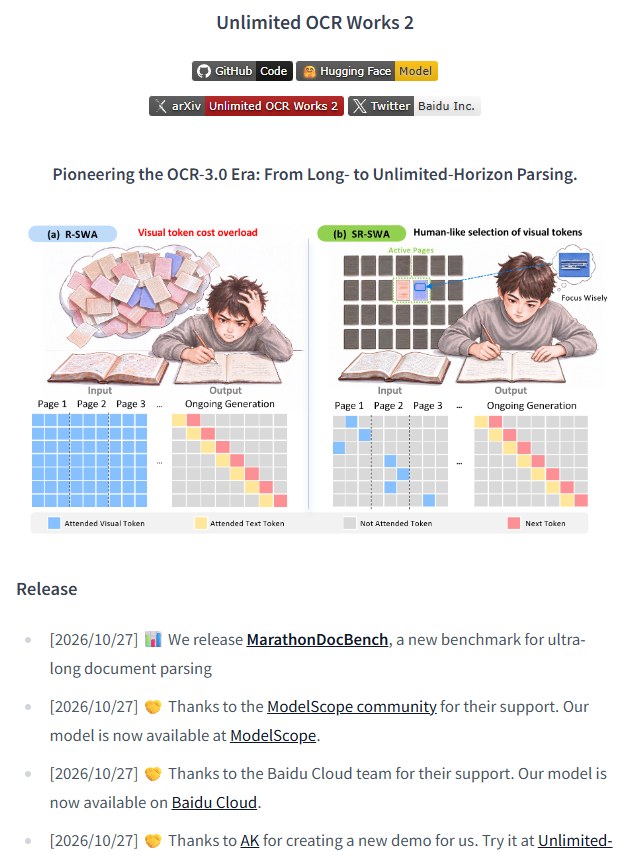
- Unlimited OCR 2는 Hugging Face 표기 3B(30억) 파라미터 모델로, 여러 쪽 문서를 한 번의 요청으로 읽어요. 새 방식 SR-SWA는 긴 문서에서 글과 그림의 주의(attention) 대상을 정해진 크기(예: 512토큰)의 '작업 참조'로 줄여서, 문서 길이와 상관없이 한 단계 처리 시간과 메모리를 거의 일정하게 유지해요.
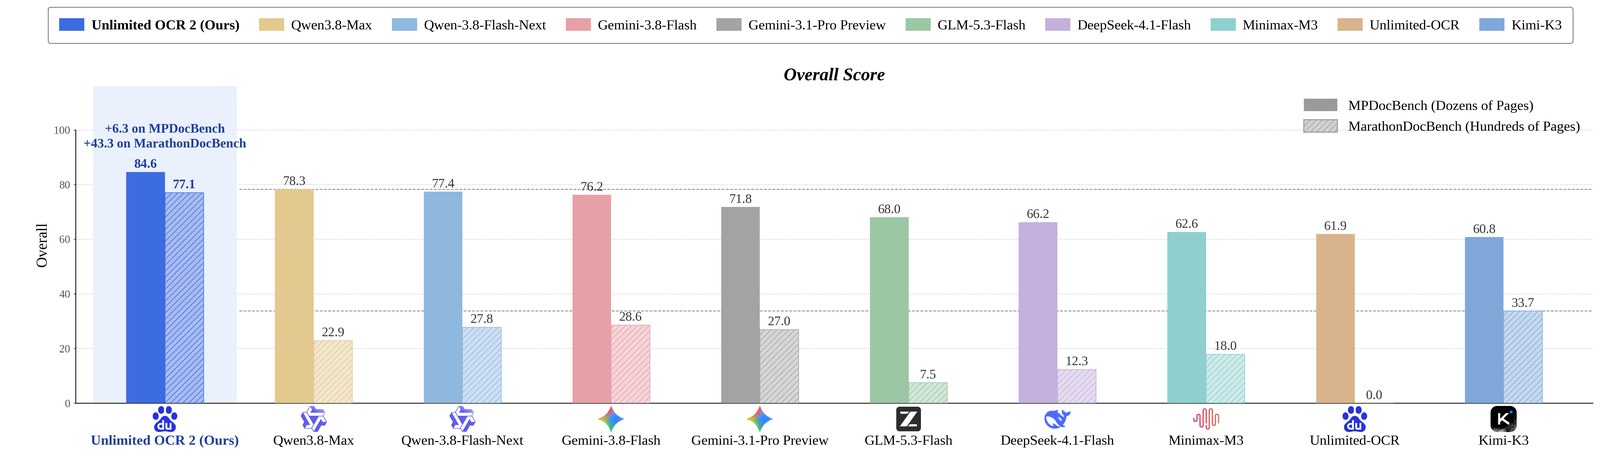
- Baidu 그림 기준 종합 점수는 수십 쪽 시험 MPDocBench 84.6(다음 Qwen3.8-Max 78.3) · 수백 쪽 시험 MarathonDocBench 77.1(그림 속 다른 모델 최고 Kimi-K3 33.7)이에요. 6월에 나온 1편(Unlimited-OCR)은 MarathonDocBench에서 0.0이었어요.
- 다만 이 점수는 Baidu가 직접 고른 비교 모델로 잰 자체 결과예요. 실행 예시는 NVIDIA A800-80GB에서 시험했다고 적혀 있어 큰 GPU가 필요하고, 가볍게는 Hugging Face 데모로 먼저 볼 수 있어요.
긴 PDF를 쪽마다 잘라 OCR한 뒤 이어 붙이던 파이프라인이 있다면, infer_multi로 한 번에 넣었을 때 쪽을 넘는 표 · 문단이 제대로 이어지는지 비교해 볼 만해요.
수백 쪽 보고서 · 전자책을 글로 뽑아 요약 · 카드뉴스 재료로 쓰는 작업에 후보로 올려 둘 수 있어요. 지금은 데모로 몇 쪽만 시험해 보는 정도가 현실적이에요.
두꺼운 계약서 · 매뉴얼 스캔본을 검색 가능한 글로 바꾸고 싶을 때, 클라우드 OCR 비용과 비교할 오픈소스 선택지로 기억해 두면 좋아요.
1) Hugging Face Space(baidu/Unlimited-OCR-2) 데모에 내 문서 몇 쪽 올려 보기
2) 결과가 좋으면 모델 카드의 Transformers 안내대로 infer_multi 시험
3) 서비스로 돌릴 땐 모델 카드의 SGLang 안내를 따르세요
라이선스: MIT · 비용: 모델은 무료, GPU는 직접 준비
두꺼운 PDF 자료를 통째로 글로 뽑아 요약 · 정리 재료로 쓰는 일에, 먼저 데모로 몇 쪽 시험해 보면 좋을 것 같아요.
Baidu가 10월 27일 Unlimited OCR 2를 공개했어요. OCR은 문서 이미지 속 글자를 읽어 텍스트로 바꾸는 일이에요. 모델 파일은 Hugging Face에, 코드는 GitHub에 올라와 있고 라이선스는 MIT예요. Hugging Face 페이지에 적힌 크기는 3B 파라미터예요.
1편에서 무엇이 바뀌었나요
1편 Unlimited-OCR은 6월 22일 나왔어요. DeepSeek OCR을 바탕으로, 글을 써 내려가는 부분(디코더)의 attention을 R-SWA라는 방식으로 바꿔 KV 캐시(앞 내용을 기억하는 메모리)가 늘지 않게 했어요. 논문은 이 덕분에 기본 최대 길이 32K 안에서 수십 쪽 문서를 한 번에 옮길 수 있다고 적었어요.
2편은 여기에 SR-SWA(Sparse Reference Sliding Window Attention)를 더했어요. 아주 긴 글 · 그림 사이의 attention을 정해진 크기(예: 512토큰)의 「작업 참조」 묶음으로 줄여서, 문서가 얼마나 길든 한 단계 처리 시간과 메모리가 거의 일정하게 유지된다고 해요. Baidu는 이를 「길이 제한 없는 문서 읽기(unlimited-horizon parsing)」라고 불러요. 모델 카드에는 책 한 권을 한 번의 요청으로 읽는 화면도 실려 있어요.
새 시험 MarathonDocBench
함께 공개한 MarathonDocBench는 100~300쪽짜리 문서 100개(약 1만 8천 쪽 · 중국어 · 영어 섞임)로 만든 시험이에요. 쪽을 넘어 이어지는 글과 표가 자주 나오고, 약 20만 5천 개의 레이아웃 요소에 정답 표시를 달았다고 해요.
점수 (Baidu 공개 그림 기준)
- MPDocBench(수십 쪽 문서): Unlimited OCR 2 84.6 — 그림 속 다음 모델 Qwen3.8-Max 78.3보다 6.3점 높아요.
- MarathonDocBench(수백 쪽 문서): 77.1 — 그림 속 다른 모델 중 가장 높은 Kimi-K3가 33.7이에요. Gemini-3.8-Flash 28.6, Qwen-3.8-Flash-Next 27.8, 1편 Unlimited-OCR은 0.0이에요.
비교 모델과 점수는 모두 Baidu가 모델 카드에 올린 그림에서 나온 숫자예요.
어떻게 써 볼 수 있나요
모델 카드는 Transformers(빠른 시험용)와 SGLang(서비스용 권장) 두 가지 방법을 안내해요. Transformers에선 infer_multi에 쪽 이미지를 순서대로 넘기면 한 요청에 모든 쪽을 읽고, 한 쪽만 읽을 땐 infer를 써요. 안내된 실행 환경은 Python 3.10 · NVIDIA A800-80GB예요. 직접 돌리기 어렵다면 Hugging Face Space의 데모로 먼저 결과를 볼 수 있어요. ModelScope와 Baidu Cloud에서도 쓸 수 있다고 적혀 있어요.