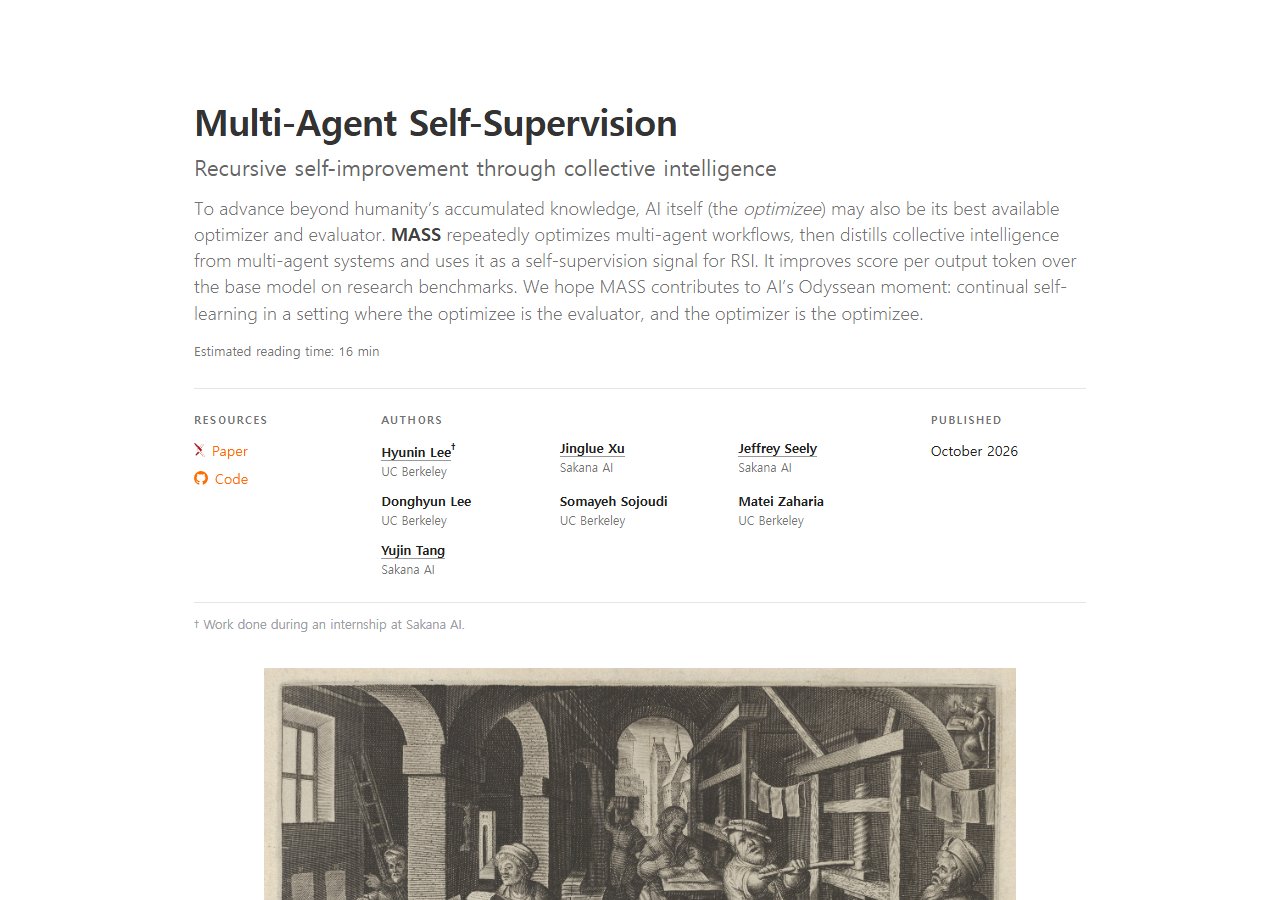
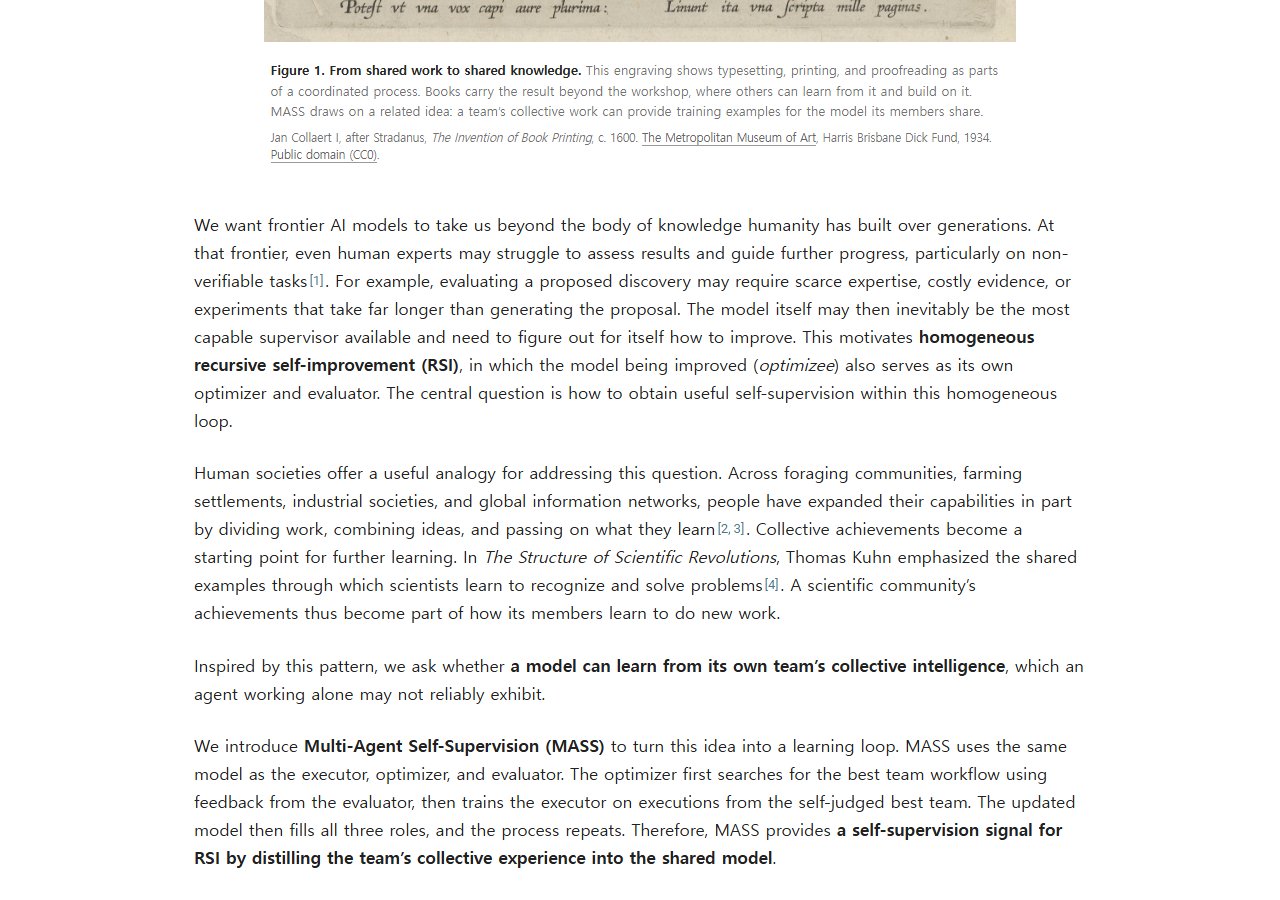
Sakana AI MASS — 27B 모델 하나가 팀·심판·교사를 다 해요
Sakana AI가 하나의 모델이 멀티 에이전트 워크플로를 스스로 최적화하고 학습하는 MASS 방법을 공개했어요. 토큰당 점수가 최대 1.6배 올라요.
- MASS(Multi-Agent Self-Supervision)는 Qwen 27B 모델 하나가 실행자·최적화자·평가자 세 역할을 돌아가며 맡아, 스스로 워크플로를 개선하고 학습해요.
- MLR-Bench에서 토큰당 점수 1.6배, DSBench 1.35배, ScienceAgentBench 1.2배 — 같은 토큰으로 더 높은 성능을 냈어요.
- 같은 수준의 성과를 내는 데 단일 에이전트보다 지도 학습 토큰이 31% 적게 들었어요. 코드와 논문이 모두 공개돼 있어요.
GPU 서버가 있다면 공개 코드(Qwen 27B + vLLM)를 돌려, 내 도메인 태스크에서 멀티 에이전트 자기 학습 파이프라인을 재현해 볼 수 있어요.
하나의 모델로 워크플로 탐색 → 궤적 수집 → LoRA 파인튜닝을 반복하는 구조를 자기 에이전트 시스템 설계에 참고할 수 있어요.
당장 API로 쓸 수 있는 서비스는 아니지만, 멀티 에이전트가 단일 에이전트보다 토큰 효율이 높다는 결과는 에이전트 도구 선택 기준이 돼요.
1. GitHub 저장소 clone: git clone https://github.com/SakanaAI/mass
2. Qwen3.6-27B 가중치 다운로드 + vLLM 서버 띄우기
3. configs/paper.json으로 첫 번째 MASS 사이클 실행 (RHI 탐색 → 궤적 수집 → 랭킹 → LoRA 학습 → 모델 내보내기)
4. 두 번째 사이클: configs/cycle2.json으로 반복
5. 공개 벤치마크(MLR-Bench 등) 어댑터로 결과 비교
멀티 에이전트 시스템을 한 모델로 압축하는 아이디어가 인상적이에요. 에이전트 워크플로를 설계할 때, 역할을 나눠 돌리는 것과 한 모델에 증류하는 것의 비용 차이를 비교해 보면 좋을 것 같아요.
Sakana AI와 UC Berkeley 공동 연구팀이 MASS(Multi-Agent Self-Supervision)를 공개했어요. 핵심은 간단해요 — 모델 하나가 여러 에이전트 역할을 동시에 맡고, 그 결과를 다시 자기 학습에 쓰는 거예요.
어떻게 작동하나요?
MASS는 두 단계를 번갈아 반복해요.
- 워크플로 탐색(RHI) — 모델 가중치는 고정한 채, 최적화자 역할의 모델이 여러 멀티 에이전트 워크플로를 시도하고 평가자 역할의 모델이 점수를 매겨요.
- 학습(Post-training) — 가장 좋은 워크플로에서 나온 궤적(trajectory)으로 LoRA 파인튜닝을 해요. 업데이트된 모델이 다시 1단계로 돌아가요.
기반 모델은 Qwen3.6-27B이고, 금융·로보틱스·제약 등 12개 합성 연구 태스크에서 훈련했어요(9개 훈련용, 3개 테스트용).
벤치마크 결과
두 번의 MASS 사이클 뒤, 공개 벤치마크에서 토큰당 점수가 크게 올랐어요.
- MLR-Bench: 1.60배 (기반 모델 대비)
- DSBench: 1.35배
- AstaBench E2E-Hard: 1.28배
- ScienceAgentBench: 1.20배
다만 Terminal-Bench 2.0(0.96배)과 SWE-bench Verified(0.94배)에서는 기반 모델과 비슷하거나 약간 낮았어요. 연구팀은 이 벤치마크들이 단일 에이전트에 더 유리한 구조라고 설명해요.
토큰 효율이 핵심
MASS 1라운드 모델(M+)은 28.8M 지도 학습 토큰으로 68.3% 승률을 냈어요. 같은 수준의 단일 에이전트 학습(S++)은 42M 토큰이 필요했어요 — 31% 적은 토큰으로 비슷한 성능을 낸 셈이에요.
멀티 에이전트 출력물이 단일 에이전트 출력물보다 선호되는 비율은 85.1%였고, MASS 평가자와 외부 심사자의 일치율은 73%에서 93%로 올랐어요.
코드·논문 공개
논문(39쪽)과 전체 파이프라인 코드가 GitHub에 공개돼 있어요. 워크플로 탐색, 궤적 수집, LoRA 학습, 벤치마크 평가 어댑터까지 포함돼요. 다만 Qwen 27B를 vLLM 서버로 띄울 수 있는 GPU 환경이 필요해요.
X 게시물 보기 · https://x.com/sakanaailabs/status/2109385006603006435