Inception Mercury 3 공개 — 초당 1,068토큰, 자체 표 12개 중 8개에서 GPT-6 Luna · Claude Haiku 5.5보다 높아요
Inception이 10월 19일 확산(diffusion) 방식 언어 모델 Mercury 3를 내놨어요. NVIDIA GPU에서 초당 1,068토큰, 컨텍스트 100만 토큰, 출시 할인가는 100만 토큰당 입력 $0.10 · 출력 $0.35예요. 새 계정엔 1억 토큰이 무료예요.
- Inception이 10월 19일 확산 방식 언어 모델 Mercury 3를 공개했어요. NVIDIA GPU에서 초당 1,068토큰, 컨텍스트는 Mercury 2.5의 26만 토큰에서 100만 토큰으로 늘었어요.
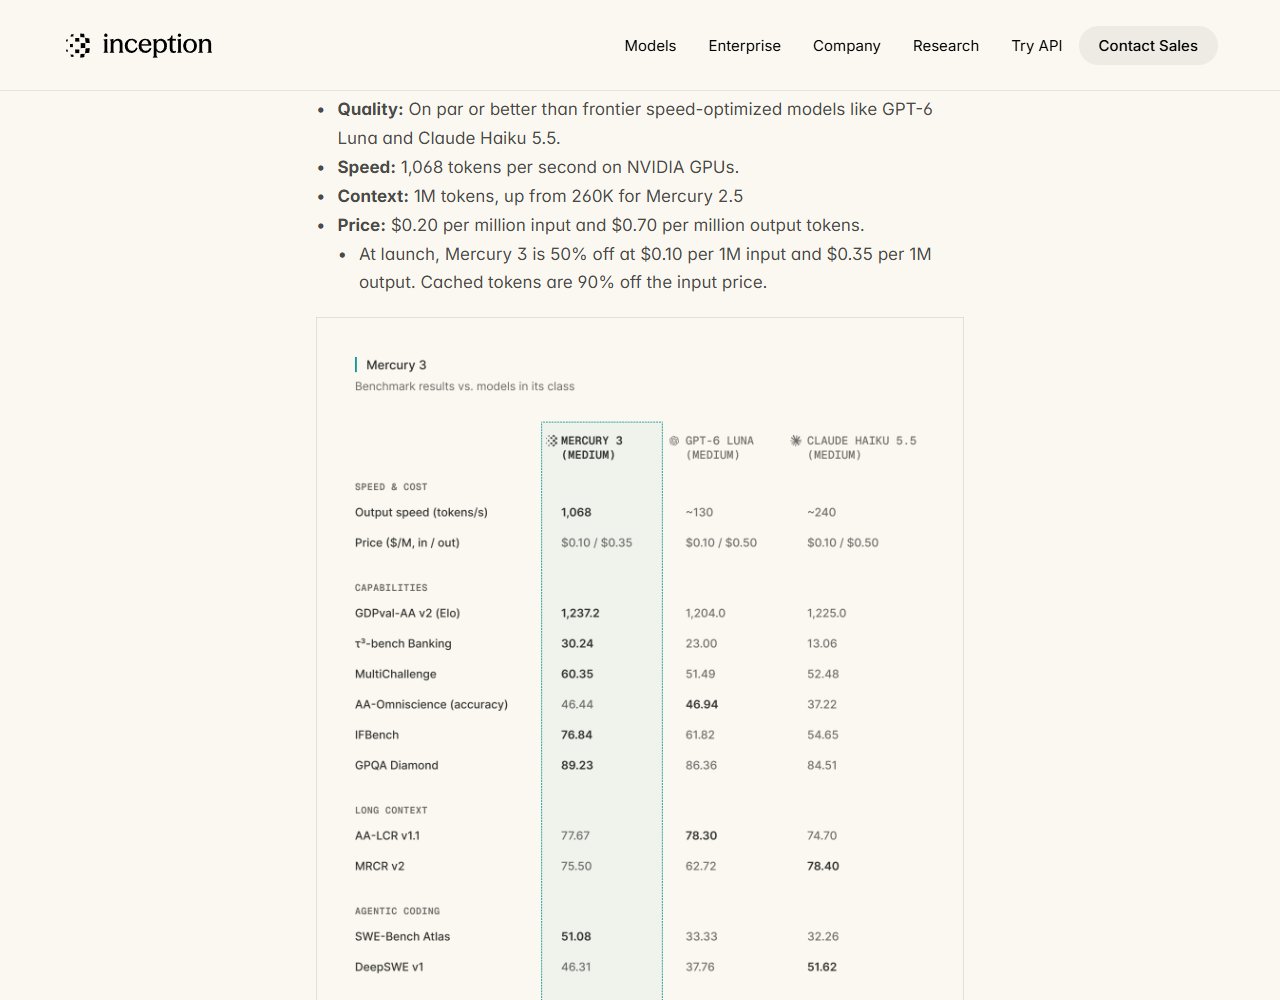
- Inception 자체 표(세 모델 모두 medium 설정)의 능력 항목 12개 중 8개에서 GPT-6 Luna · Claude Haiku 5.5보다 높았고, AA-Omniscience · AA-LCR v1.1 · MRCR v2 · DeepSWE v1 4개는 더 낮았어요.
- 정가는 100만 토큰당 입력 $0.20 · 출력 $0.70, 출시 기념 50% 할인가는 $0.10 · $0.35예요. Inception API · OpenRouter · Baseten · Vercel에서 쓸 수 있고, 새 계정엔 1억 토큰이 무료예요.
에이전트가 여러 단계를 도는 동안 모델 응답을 기다리는 시간이 길다면, OpenAI API 호환이라 base URL을 https://api.inceptionlabs.ai/v1 로, model 을 "mercury-3" 으로 바꿔 같은 작업의 걸린 시간과 결과를 지금 쓰는 모델과 비교해 볼 만해요.
실시간으로 답이 빨리 나와야 하는 챗봇·음성 응대 데모를 만들 때 후보가 될 수 있어요. 다만 한국어 품질은 원문에서 따로 다루지 않았으니 짧은 대화 몇 개로 먼저 확인해야 해요.
고객 문의 자동 답변처럼 빠른 응답이 중요한 일을 시험해 보고 싶다면, 결제 정보 없이 받는 1억 무료 토큰 안에서 실제 문의 몇 건으로 먼저 돌려 볼 수 있어요.
1. Inception Platform 계정을 만들고 API Keys 에서 키를 만들어요(새 계정 1억 토큰 무료, 결제 정보 없이 시작).
2. 터미널에서 키를 환경 변수로 넣어요: export INCEPTION_API_KEY="your_api_key_here"
3. pip install inceptionai
4. 공식 문서 Quick Start 의 첫 요청 예시(model "mercury-3")를 그대로 실행해요.
5. 평소 쓰던 작업 3~5개를 똑같이 돌려 걸린 시간 · 결과를 지금 모델과 나란히 적어요.

음성 비서나 고객 응대 챗봇처럼 답이 1~2초 안에 나와야 하는 작업이라면, 무료 토큰으로 지금 쓰는 모델과 응답 시간을 나란히 재 보면 좋을 것 같아요. 점수와 속도는 Inception이 직접 잰 값이라 내 작업에서 다시 확인하는 게 좋겠어요.
Inception이 10월 19일 공식 블로그에서 Mercury 3를 공개했어요. Inception은 이 모델을 "지금까지 나온 확산 기반 LLM 가운데 가장 뛰어난 모델"이라고 소개했어요. 확산(diffusion) 언어 모델은 글자를 한 개씩 차례로 쓰는 대신 여러 토큰을 한꺼번에 만들고 다듬는 방식이에요(OpenRouter 모델 설명 기준).
한눈에 보기 — 블로그 'at a glance'
- 속도: NVIDIA GPU에서 초당 1,068토큰. 블로그는 GPT-6 Luna · Claude Haiku 5.5보다 "4~8배 빠르다"고 했어요(표에선 Luna 약 130, Haiku 5.5 약 240).
- 컨텍스트(한 번에 넣을 수 있는 분량): 100만 토큰 — Mercury 2.5의 26만 토큰에서 늘었어요.
- 정가(100만 토큰당): 입력 $0.20 · 출력 $0.70
- 출시 할인: 50% 할인해 입력 $0.10 · 출력 $0.35. 캐시된 토큰(이미 보낸 내용을 다시 쓸 때)은 입력 가격에서 90% 할인이에요. 할인 기간은 블로그에 없어요.
- 크기: 전체 파라미터가 Mercury 1보다 40배 넘게 커졌고, Inception은 표준 벤치마크 지능 점수가 Mercury 1(mini)에서 Mercury 3까지 3배 올랐다고 했어요(그래프의 지능 점수 = 벤치마크 12개 평균).
벤치마크 — Inception이 직접 만든 표
표에는 Mercury 3 · GPT-6 Luna · Claude Haiku 5.5가 모두 medium 설정으로 실렸어요. 능력 항목 12개 중 Mercury 3가 8개에서 가장 높았어요.
- 높았던 항목: GDPval-AA v2 1,237.2(Luna 1,204.0 · Haiku 1,225.0), τ³-bench Banking 30.24(23.00 · 13.06), MultiChallenge 60.35, IFBench 76.84, GPQA Diamond 89.23, SWE-Bench Atlas 51.08(33.33 · 32.26), BrowseComp+ 55.18, DeepSearchQA 71.33
- 낮았던 항목: AA-Omniscience 정확도 46.44(Luna 46.94), AA-LCR v1.1 77.67(Luna 78.30), MRCR v2 75.50(Haiku 78.40), DeepSWE v1 46.31(Haiku 51.62)
표의 가격 줄에서 Mercury 3는 할인가 $0.10 / $0.35로, GPT-6 Luna · Haiku 5.5는 $0.10 / $0.50으로 적혀 있어요. 정가($0.20 / $0.70)는 표에 적힌 두 모델 가격보다 높아요.
먼저 써 본 회사들 — 블로그 인용
- TinyFish AI(웹 에이전트): 실제 웹사이트 길찾기 과제 Mind2Web 50개에서 Mercury 3가 50%를 끝냈고, "GPT-6.1-Sol보다 훨씬 많았다"고 했어요. GPT-6.1-Sol 숫자는 적혀 있지 않아요.
- Octen AI(스마트 안경 검색): 검색 자체는 약 80ms, Mercury 3의 생성 시간 중앙값 0.9초, 처음부터 끝까지 응답 중앙값 2.2초.
- RevisionDojo(교육): 힌트 · 채점 · 단어 풀이가 약 1초 만에 돌아온다고 했어요.
- Lorikeet(고객 지원): 초기 시험에서 다른 모델보다 지연 시간이 짧고 평가 · 실제 운영 성능도 더 높았다고 했어요.
어디서 쓰나
10월 19일부터 Inception API Platform과 OpenRouter · Baseten · Vercel에서 쓸 수 있고, OpenAI API와 호환돼요. API 문서의 모델 이름은 mercury-3이에요. 새 계정엔 1억 토큰이 무료이고 결제 정보 없이 시작할 수 있어요. 무료 토큰이 떨어지면 Billing에서 결제 정보를 넣어야 계속 쓸 수 있어요.
참고로 OpenRouter 모델 페이지에는 10월 20일 새벽 기준 처리 속도 중앙값(P50)이 초당 약 220토큰으로 찍혀 있어요. 블로그의 1,068과는 측정 조건이 달라 바로 비교할 수는 없지만, 실제 속도는 내 환경에서 재 보는 게 좋아요.
함께 소개된 Mercury Voice는 음성 앱용으로 첫 답 토큰까지 걸리는 시간(TTFAT)을 줄이도록 맞춘 모델이고, Mercury Decide는 대량 분류용 결정 모델이에요.