NVIDIA Vera Rubin NVL72, 에이전트 코딩 벤치마크에서 GB300 대비 메가와트당 처리량 최대 5.7배
Artificial Analysis가 AA-AgentPerf 벤치마크에서 NVIDIA Vera Rubin NVL72의 첫 측정 결과를 공개했어요. GB300 NVL72와 같은 전력에서 에이전트 코딩 처리량이 최대 약 5.7배 더 많아요(빠른 응답 속도 구간 기준, 최대 처리량끼리는 1.14~1.45배).
- Artificial Analysis가 10월 15일 AA-AgentPerf 리더보드에 Vera Rubin NVL72의 첫 실측 결과를 올렸어요. DeepSeek V4 Pro 기준, 메가와트당 처리량이 GB300 NVL72의 약 5.7배(사용자당 약 190 tok/s)예요.
- 모델별 GB300 대비 배수는 DeepSeek V4.1 Flash 약 5.4배(약 580 tok/s), GLM-5.2 약 3.0배(약 165 tok/s), Kimi K3 약 2.8배(약 67 tok/s)예요. 격차는 사용자당 속도가 빠른 구간에서 가장 커요.
- Vera Rubin NVL72는 72개 Rubin GPU + 36개 Vera CPU 구성이에요. GPU당 메모리 대역폭 19.2 TB/s(GB300은 8 TB/s), NVLink 3.0 TB/s(GB300은 1.8 TB/s), Dense NVFP4 기준 35 PFLOPS(GB300은 15 PFLOPS)예요.
AA-AgentPerf 리더보드에서 모델별 Vera Rubin 구성(동시 에이전트 수·속도·전력)을 확인하고, 에이전트 서빙 클러스터의 세대 교체 시점을 잡을 수 있어요.
에이전트 코딩 워크로드(요청당 최대 132K 토큰, 97% 반복 프리픽스)에서 KV 캐시·프리필 효율이 비용에 얼마나 영향을 주는지 벤치마크 방법론을 참고할 수 있어요.
전력 효율이 오르면 토큰당 운영 비용이 내려가요(원문). 차세대 GPU가 나오면 토큰당 비용이 내려갈 수 있으니 API 예산 계획 시 참고할 수 있어요.
에이전트 코딩 서빙의 전력 효율이 세대마다 크게 뛰고 있어서, 앞으로 API 토큰 비용이 더 내려갈 수 있는지 지켜보면 좋을 것 같아요.
Artificial Analysis가 10월 15일 자체 벤치마크 AA-AgentPerf에 NVIDIA Vera Rubin NVL72의 첫 실측 결과를 올렸어요. Vera Rubin은 Blackwell(GB300)의 후속 랙 스케일 시스템으로, 72개 Rubin GPU와 36개 Vera CPU로 구성돼요.
GB300 NVL72 대비 메가와트당 처리량
같은 전력(메가와트) 기준, Vera Rubin NVL72는 GB300 NVL72보다 에이전트 코딩 처리량이 크게 높았어요.
- DeepSeek V4 Pro: 약 5.7배 (사용자당 약 190 tok/s)
- DeepSeek V4.1 Flash: 약 5.4배 (사용자당 약 580 tok/s)
- GLM-5.2: 약 3.0배 (사용자당 약 165 tok/s)
- Kimi K3: 약 2.8배 (사용자당 약 67 tok/s)
Vera Rubin의 이점은 사용자당 속도가 빠를수록 커졌어요. 원문에 따르면 DeepSeek V4 Pro 기준 GB300은 사용자당 약 120에서 약 165 tok/s로 올릴 때 메가와트당 처리량의 81%를 잃는 반면, Vera Rubin은 16%만 줄었어요.
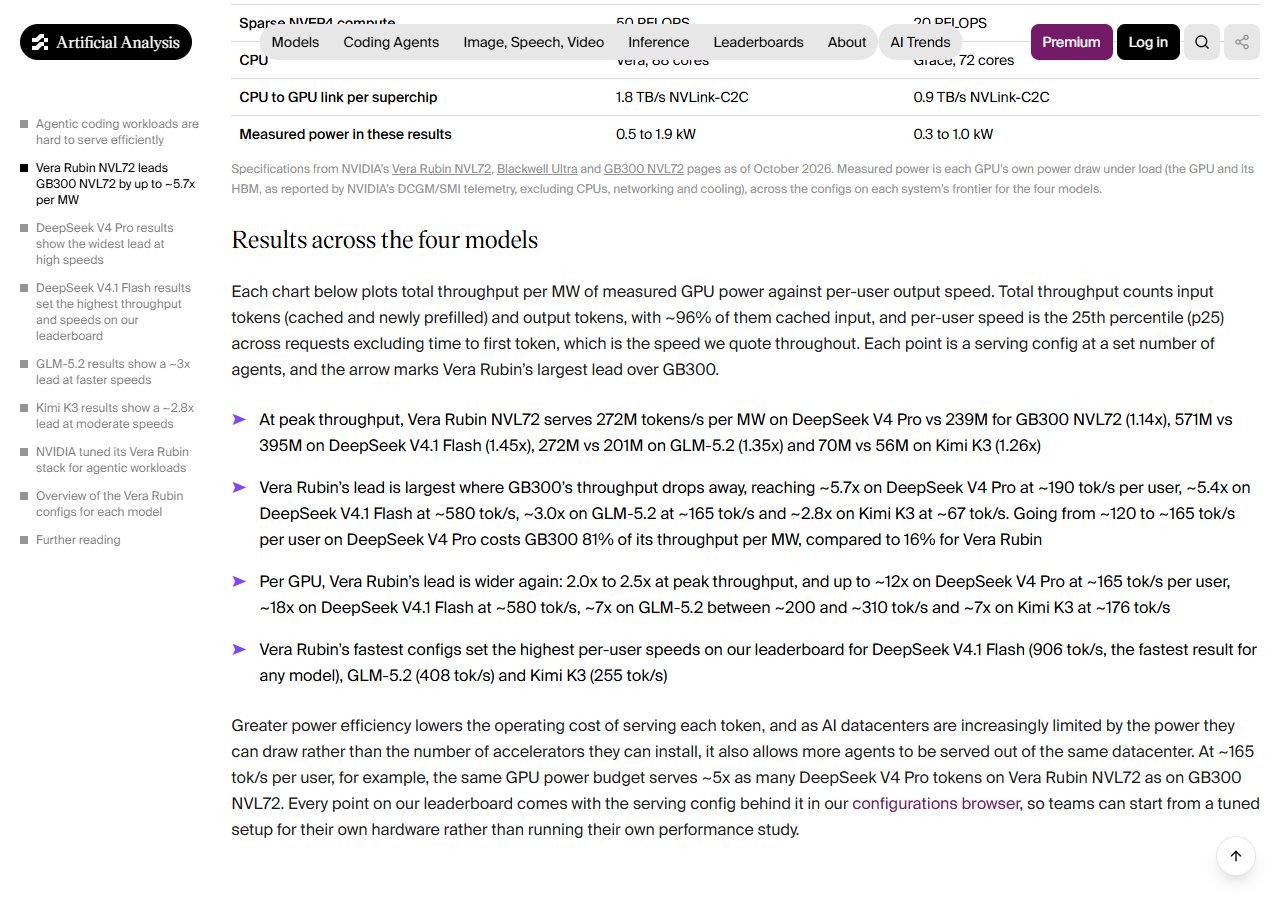
GPU당 스펙 비교
| Vera Rubin NVL72 | GB300 NVL72 | |
|---|---|---|
| Dense NVFP4 연산 | 35 PFLOPS | 15 PFLOPS |
| 메모리 대역폭 | 19.2 TB/s | 8 TB/s |
| NVLink | 3.0 TB/s | 1.8 TB/s |
| CPU ↔ GPU | 1.8 TB/s NVLink-C2C | 0.9 TB/s NVLink-C2C |
| GPU당 실측 전력 | 0.5~1.9 kW | 0.3~1.0 kW |
스펙은 NVIDIA 공식 제품 페이지 기준이고, 전력은 NVIDIA DCGM/SMI 텔레메트리로 측정한 GPU + HBM 전력이에요(CPU·네트워크·쿨링 제외).
X 게시물 보기 · https://x.com/artificialanlys/status/2110903253013762365
AA-AgentPerf 벤치마크란
AA-AgentPerf는 에이전트 코딩 워크로드를 시뮬레이션하는 하드웨어 추론 벤치마크(Agentic inference benchmark)예요. 12개 이상의 프로그래밍 언어에 걸친 실제 코딩 에이전트 궤적(trajectory)을 재생해요.
- 요청당 입력 토큰 최대 132K, 평균 97%가 이전 요청과 겹쳐요
- 한 궤적에서 최대 182회 요청, 누적 입력 토큰 최대 1,100만
- AA-AgentPerf 워크로드 통계: 500개 궤적, 18,997건 요청
처리량은 캐시된(반복) 입력 + 새 프리필 + 출력 토큰을 모두 합한 값이고, 사용자당 속도는 25번째 백분위(p25) 출력 속도예요.
가장 빠른 결과
Vera Rubin NVL72에서 DeepSeek V4.1 Flash가 사용자당 906 tok/s로 AA-AgentPerf 리더보드 전체에서 가장 빠른 속도를 기록했어요. GLM-5.2는 408 tok/s, Kimi K3은 255 tok/s였어요. 피크 메가와트당 처리량은 DeepSeek V4.1 Flash가 571M tok/s로 가장 높았어요.
Vera Rubin 결과는 모두 NVIDIA가 직접 제출했어요. DeepSeek V4 Pro는 첫 토큰까지 시간이 더 길어(1.65초, GB300은 1.08초), 이 대기까지 넣은 전체 속도 기준으로는 대부분의 속도에서 GB300이 메가와트당 처리량이 같거나 더 높았어요. V4.1 Flash는 응답 길이 상한이 2,048토큰이라 Vera Rubin에 다소 유리했어요.