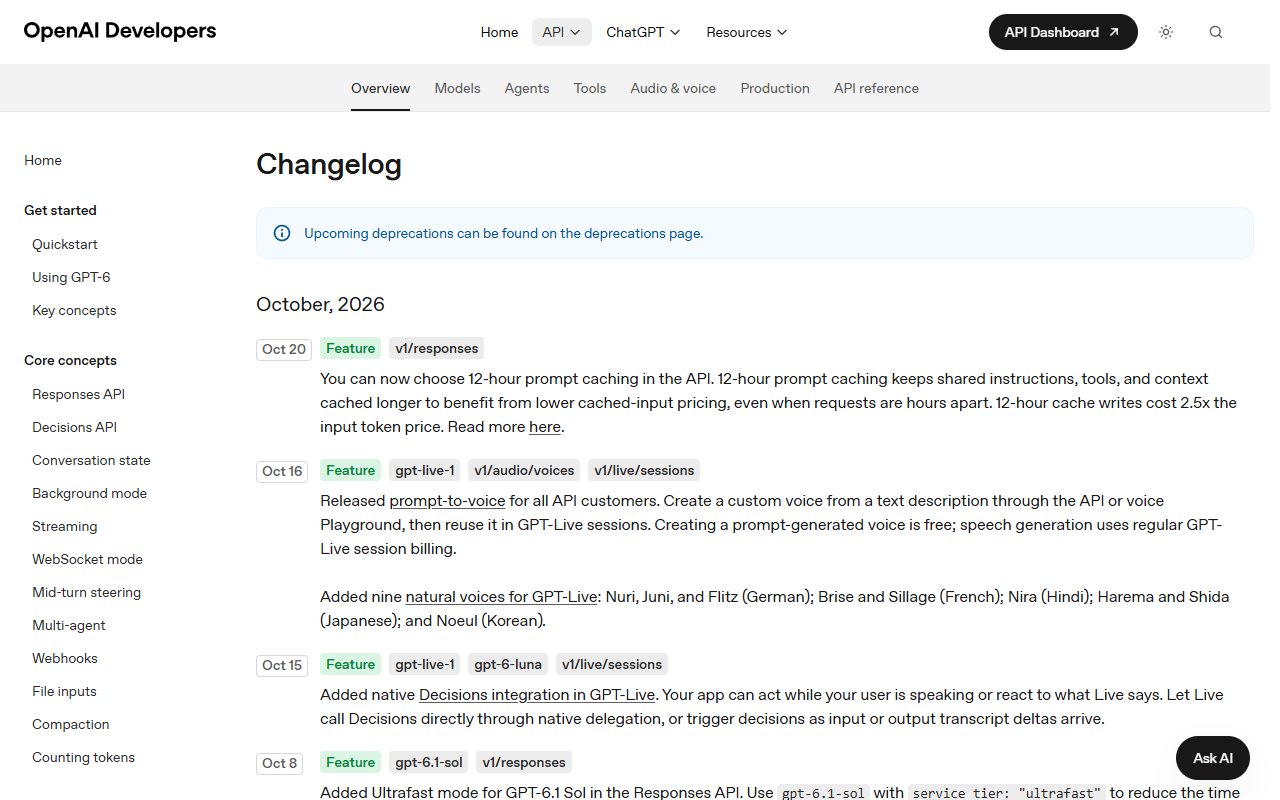
OpenAI API 프롬프트 캐시, 이제 12시간 유지 — 몇 시간 떨어진 요청도 캐시 단가로 (쓰기는 입력값의 2.5배)
OpenAI가 10월 20일 API에 12시간 프롬프트 캐싱을 추가했어요. GPT-5.6 이후 모델의 Responses API에서 ttl 을 "12h"로 고르면 돼요.
- OpenAI가 10월 20일 API에 12시간 프롬프트 캐싱을 추가했어요. 공통 지시문 · 도구 · 맥락을 더 오래 캐시에 남겨, 요청 사이가 몇 시간 떨어져도 캐시 입력 단가를 받을 수 있게 하는 기능이에요.
- GPT-5.6 이후 모델은 Responses API의 prompt_cache_options.ttl 로 "30m"(기본) 또는 "12h"를 골라요. 캐시 쓰기 값은 30분이 입력 단가의 1.25배, 12시간이 2.5배예요(추가 요금이 아니라 전체 단가).
- 캐시 읽기는 두 시간 모두 같아서, 이 모델들 대부분 입력 단가의 0.1배, GPT-6.1 Sol은 0.05배예요. 캐시가 되려면 앞부분이 1,024토큰 이상이어야 해요(GPT-5.6 이후 기준).
하루 종일 같은 긴 시스템 지시문 · 도구 정의를 쓰는 에이전트나 사내 봇에 맞아요. 지시문 끝에 12시간 브레이크포인트를 걸고, 자주 바뀌는 세션 맥락은 30분으로 두는 방식이 문서 예시예요.
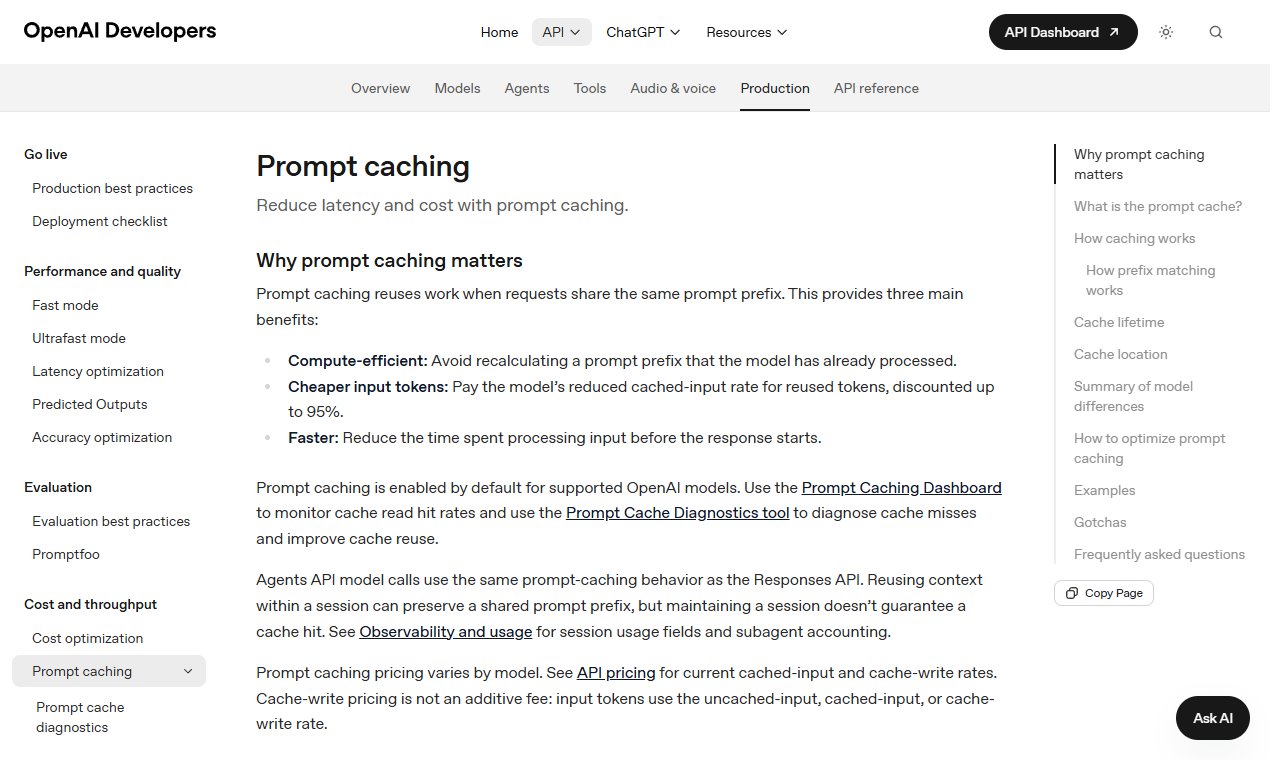
요청이 드문드문 들어오는 고객 상담 봇처럼 30분 안에 다시 안 불리는 서비스라면, 긴 안내문을 12시간 캐시에 두는 게 맞는지 OpenAI의 Prompt Caching Dashboard에서 캐시 읽기 적중률을 보고 판단해 볼 수 있어요.
OpenAI 문서 예시 그대로 (GPT-5.6 이후 모델 · Responses API)
1. 요청에 "prompt_cache_options": {"mode": "explicit", "ttl": "30m"} 를 넣어요.
2. 하루 내내 다시 쓰는 지시문 · 참고 자료 블록에 "prompt_cache_breakpoint": {"mode": "explicit", "ttl": "12h"} 를 붙여요.
3. 몇 분 안에 다시 쓰는 세션 맥락 블록에는 "prompt_cache_breakpoint": {"mode": "explicit"} 만 붙여요(요청 기본값 30m).
4. 그때그때 바뀌는 질문은 마지막 브레이크포인트 뒤에 둬요 — 캐시 쓰기 값이 붙지 않아요.
※ 캐시할 앞부분은 1,024토큰 이상이어야 해요. 예전 모델은 따로 있는 prompt_cache_retention 설정을 그대로 써요.
같은 긴 지시문을 띄엄띄엄 몇 시간에 걸쳐 부르는 자동화 봇을 돌린다면, 그 지시문 블록에만 12시간을 걸어 보면 좋을 것 같아요. 다만 쓰기 값이 2.5배라, 30분 안에 자주 다시 불리는 작업은 기본값 그대로 두는 게 나을 것 같아요.
OpenAI가 2026년 10월 20일 API 변경 기록(changelog)에 12시간 프롬프트 캐싱을 올렸어요. 프롬프트 캐싱은 요청의 앞부분(프리픽스, 매번 똑같이 시작하는 지시문 · 도구 · 맥락)이 같으면 모델이 이미 처리한 결과를 다시 쓰는 기능이에요. OpenAI는 12시간 캐싱이 공통 지시문 · 도구 · 맥락을 더 오래 캐시에 남겨, 요청 사이가 몇 시간 떨어져 있어도 낮은 캐시 입력 단가를 받게 해 준다고 설명해요.
어떻게 고르나
GPT-5.6 이후 모델은 Responses API에서 prompt_cache_options.ttl 로 최소 캐시 유지 시간을 골라요.
- "30m"(기본): 30분. 캐시 쓰기 값은 캐시 안 된 입력 단가의 1.25배. 맥락을 자주 다시 쓰는 대화 · 에이전트 단계용이에요.
- "12h": 12시간. 캐시 쓰기 값은 2.5배. 오래 떨어진 간격으로 다시 쓰는 고정 지시문 · 참고 자료용이에요.
문서는 이 값이 일반 입력에 더 붙는 추가 요금이 아니라 전체 쓰기 단가라고 적었어요. 캐시 읽기 값은 두 시간이 같고, 이 모델들 대부분 입력 단가의 0.1배, GPT-6.1 Sol은 0.05배예요. 문서 계산 예시로는 30분 쓰기 기준 한 번 쓰고 한 번 다시 쓰면 1.35배(캐시 없이 두 번 처리하면 2배), 열 번 요청하면 2.15배(캐시 없이 10배)예요.
세부 규칙
- 요청 전체의
ttl과 별개로, 브레이크포인트(캐시를 끊어 저장하는 지점)마다prompt_cache_breakpoint.ttl로 따로 정할 수 있어요. 문서 예시는 하루 내내 쓰는 지시문은 12시간, 세션 맥락은 30분으로 섞어요. - 두 설정을 다 빼면 기존처럼 30분이에요. 지원하지 않는 값은
400 invalid_request_error를 돌려줘요. - "12h"는 삭제 시점을 정하는 게 아니에요. OpenAI가 최소 시간보다 오래 둘 수 있고, 최대 데이터 보관 정책도 바뀌지 않아요.
- GPT-5.6 이후 모델에서 캐시가 되려면 앞부분이 1,024토큰 이상이어야 해요.
- 예전 모델의
prompt_cache_retention설정은 그대로예요.