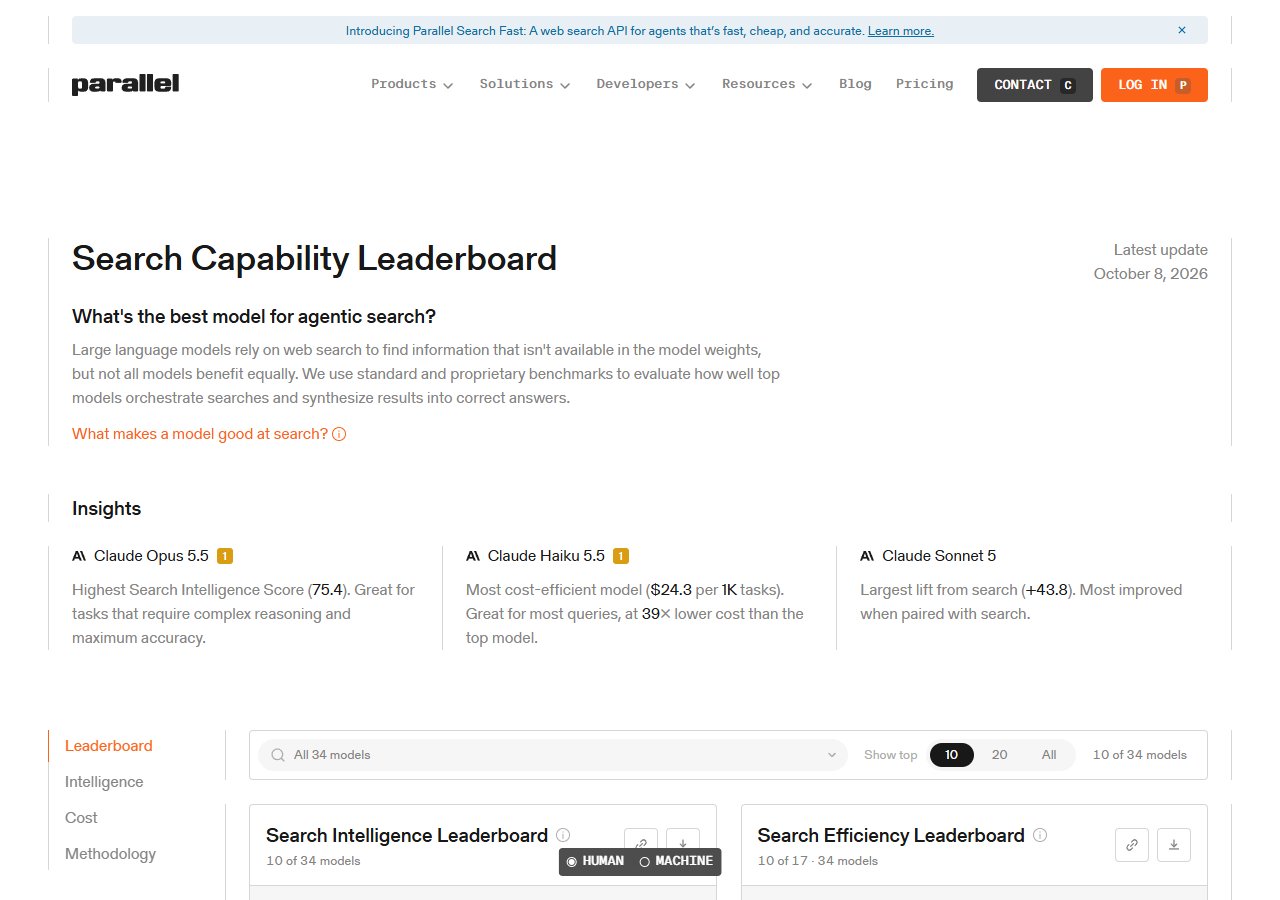
웹 검색 시키는 일 1,000건에 $24.3… Claude Haiku 5.5, 점수 1위 Opus 5.5($949)의 39분의 1 값이에요
검색 API 회사 Parallel이 10월 8일 갱신한 '검색 능력 순위표'에서 Claude Haiku 5.5가 비용 효율 1위에 올랐어요. 다만 점수 자체는 34개 모델 중 17위(62.9점)이고, Parallel의 자기 검색 도구로 잰 값이에요.
$24.3
Claude Haiku 5.5로 검색 과제 1,000건을 푸는 데 든 값 (Parallel 순위표). 점수 1위 Claude Opus 5.5는 $949였어요.
핵심 3줄
- Parallel의 검색 능력 순위표(10월 8일 갱신)에서 Claude Haiku 5.5는 과제 1,000건당 $24.3으로 비용 효율 순위 1위예요. 2위 MiMo v2.6 Pro는 $76.5예요.
- 검색을 붙였을 때 점수는 62.9점으로 34개 모델 중 17위예요. 1위는 Claude Opus 5.5(75.4점, 1,000건당 $949)이고, Parallel은 Haiku 5.5가 이보다 39배 싸다고 적었어요.
- 비용 효율 순위는 점수가 중앙값(62.8점) 이상인 17개 모델만 값이 싼 순서로 세운 거예요. Haiku 5.5는 이 선을 0.1점 차로 넘었고, 선 아래에는 더 싼 모델도 있어요(GLM 5.3 Flash $16.6·60.8점).
🧪 CONTENTSLAB 평참고만★★★★★실전 활용도 3/5
검색을 붙인 자동화를 만드는 개발자
뉴스 모으기, 가격 조사, 자료 찾기처럼 검색을 많이 돌리는 스크립트라면 Haiku 5.5를 기본으로 두고, 답이 틀리면 안 되는 질문만 큰 모델로 보내는 구성을 시험해 볼 근거가 돼요. 이 표에서 두 모델의 차이는 12.5점, 값은 39배예요.
CONTENTSLAB 생각 · 이렇게 써 볼 수 있을 것 같아요
검색으로 자료를 모아 정리하는 일을 자주 돌리는 분이라면, 같은 질문 10개를 Haiku 5.5와 큰 모델에 각각 넣어 답과 청구액을 견줘 보면 좋을 것 같아요. 한 회사가 자기 검색 도구로 잰 표라서, 직접 쓰는 검색 도구에서도 같은지는 확인이 필요해 보여요.
AI 에이전트용 웹 검색 API를 파는 Parallel이 '검색 능력 순위표(Search Capability Leaderboard)'를 10월 8일 갱신했어요. 모델에 검색 도구를 쥐여 줬을 때 얼마나 잘 찾아서 맞는 답을 내는지 재는 표예요. 여기서 Claude Haiku 5.5가 비용 효율 1위에 올랐어요.
숫자
| 모델 | 검색 붙인 점수 (순위) | 검색 없이 | 1,000건 값 | 과제당 시간 |
|---|---|---|---|---|
| Claude Opus 5.5 | 75.4 (1위) | 44.2 | $949 | 512초 |
| GPT-6.1 Sol | 70.4 (5위) | 39.8 | $130 | 353초 |
| MiMo v2.6 Pro | 64.4 (15위) | 29.7 | $76.5 | — |
| Claude Haiku 5.5 | 62.9 (17위) | 23.5 | $24.3 | 162초 |
| GPT-6 Luna | 61.9 (20위) | 28.0 | $33.1 | 391초 |
| GLM 5.3 Flash | 60.8 (21위) | 20.4 | $16.6 | 99.1초 |
Haiku 5.5는 검색 없이는 23.5점이지만 검색을 붙이면 62.9점으로 39.4점 올라요. Parallel은 Haiku 5.5를 "대부분의 질문에 알맞고, 1위 모델보다 39배 싸다"고 소개했어요.
'1위'의 조건
- 비용 효율 순위의 뜻 점수가 중앙값(62.8점) 이상인 17개 모델만 골라 싼 순서로 세운 표예요. Haiku 5.5(62.9점)는 이 선을 0.1점 차로 넘었어요.
- 더 싼 모델도 있어요 GLM 5.3 Flash($16.6·60.8점), DeepSeek V4 Flash 0731($13.6·59.2점)은 더 싸지만 점수가 중앙값 아래라 이 순위에서 빠졌어요.
- 잰 곳이 검색 회사예요 검색에는 Parallel의 Search Fast와 Extract를 썼어요. 값에는 모델 추론비와 검색·추출 추정 비용이 들어가고, Parallel은 비용 기록이 완전하지 않다고 밝혔어요.
- 문제 수 시험 세 개(DeepSearchQA, Humanity's Last Exam, WISER)에서 100문제씩이에요.