진짜 업무 파일로 에이전트 훈련장 1만 6천 개 — Tencent · 푸단대 'WorkForge' 논문
실제 파일과 전문가 업무 흐름으로 '채점할 수 있는' 훈련 환경을 자동으로 만들어요. 35B 모델의 GDPval 점수가 45.5에서 73.6으로 올랐어요. 코드 · 데이터 공개는 논문에 적혀 있지 않아요.
- Tencent LLM 부서와 푸단대 연구진이 논문 「Scaling Verifiable Environments for Long-horizon Work Agents」에서 WorkForge를 냈어요(arXiv 10월 4일 첫 공개 · 10월 21일 4판). 실제 파일로 40개 전문 분야 · 60가지 파일 형식에 걸친 훈련 환경 16.7K개를 만들었어요.
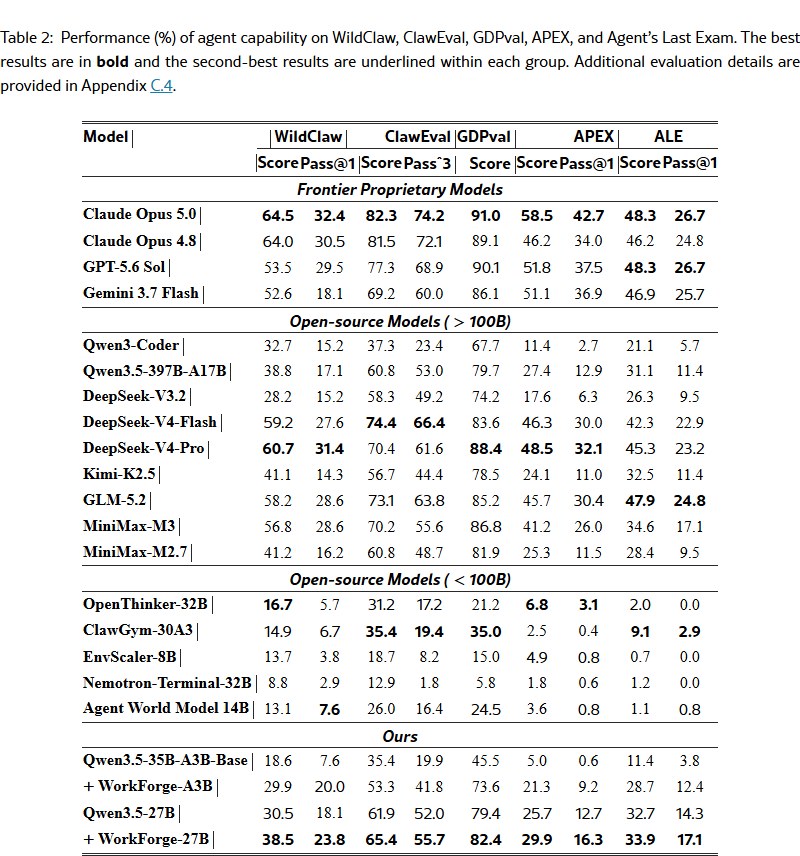
- 이 환경에서 모은 작업 기록으로 Qwen3.5-35B-A3B-Base를 미세조정(SFT)하니 GDPval 점수가 45.5에서 73.6으로, APEX 점수가 5.0에서 21.3으로 올랐어요(논문 표 2 기준).
- Qwen3.5-27B로 훈련한 WorkForge-27B는 GDPval 82.4로, 총 파라미터가 "거의 15배" 많은 Qwen3.5-397B-A17B(79.7)를 넘었다고 논문은 밝혔어요. 다만 Claude Opus 5.0(91.0) 같은 상용 모델보다는 낮아요.
업무용 에이전트를 직접 훈련하거나 평가한다면, '실제 파일에서 확인할 사실을 뽑고 → 그 사실로 과제와 채점 기준을 만든다'는 순서를 내 평가 세트 만들 때 참고할 수 있어요. 코드는 아직 공개 링크가 없어요.
엑셀 · 문서 · 보고서처럼 진짜 파일을 다루는 일을 AI에 맡길 때, 결과물을 '파일 안 사실과 맞는지'로 검사하는 방식은 그대로 빌려 쓸 만한 생각이에요.

당장 쓸 곳은 적어 보여요. 다만 AI에게 보고서 · 표 작업을 맡길 때, 원본 파일에서 꼭 맞아야 할 숫자 몇 개를 먼저 적어 두고 결과물과 대조하는 습관으로 써 보면 좋을 것 같아요.
Tencent LLM 부서와 푸단대(Fudan University) 연구진이 업무용 AI 에이전트를 훈련하는 틀 WorkForge를 논문으로 냈어요. 논문은 10월 4일 arXiv에 처음 올라왔고, 10월 21일 4판으로 고쳐졌어요.
왜 '진짜 파일'인가
업무 에이전트(파일을 열고 고치고 결과물을 내는 AI)는 긴 작업을 하고, 결과가 맞는지 확인할 수 있는 훈련 환경이 필요해요. 논문은 사람이 손으로 환경을 만들면 너무 손이 많이 들어 수를 늘리기 어렵고, AI로 합성하면 작업 공간이 단순해지고 현실감 · 검증 가능성이 떨어진다고 짚어요. 그래서 WorkForge는 실제 파일에서 출발해요.
네 단계로 만들어요
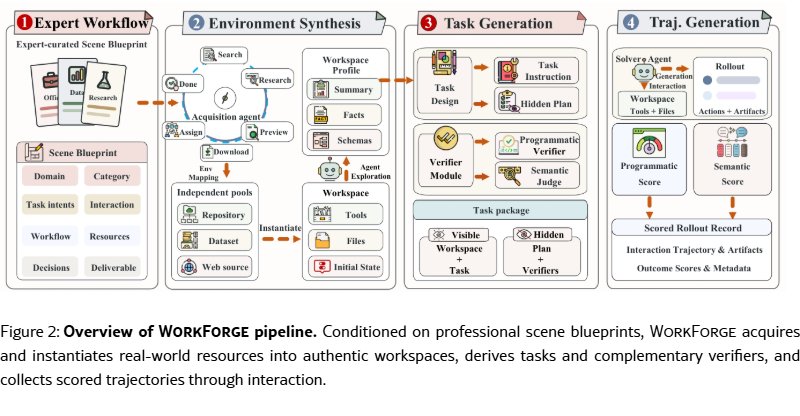
- 전문가 업무 흐름 — 분야 전문가가 자기 일을 '장면 설계도(Scene Blueprint)'로 정리해요. 업무 흐름 · 내야 할 결과물 · 필요한 자료 · 판단할 점이 들어가요.
- 작업 공간 만들기 — 수집 에이전트가 설계도에 맞는 실제 파일을 찾아 내려받고 미리 본 뒤, 원래 폴더 구성 그대로 작업 공간을 꾸려요. 그리고 파일마다 역할 · 확인할 수 있는 사실(factual anchor) · 형식을 정리한 프로필을 만들어요.
- 과제 만들기 — 설계도와 프로필로 에이전트가 볼 지시문과, 숨겨 둔 풀이 계획을 써요. 풀이 계획의 핵심 사실은 작업 공간과 대조해서, 결과 파일을 프로그램으로 검사하는 채점기와 LLM이 채점하는 기준표(rubric)로 바꿔요.
- 작업 기록 모으기 — 에이전트가 실제로 과제를 풀고, 그 과정과 결과물 점수를 함께 저장해요.
이렇게 40개 전문 분야, 60가지 파일 형식에 걸친 환경 16.7K개(표 1 기준 과제 16,665개)를 만들었어요. 훈련용 작업 기록은 GLM 5.3이 Claude Code와 OpenClaw 실행 환경(harness)에서 만들었다고 부록에 적혀 있어요.
결과 — 논문 표 2
Qwen3.5-35B-A3B-Base와 Qwen3.5-27B를 이 작업 기록으로 미세조정(SFT, 정답 예시를 보여 주며 다시 학습)했어요.
- WorkForge-A3B(Qwen3.5-35B-A3B-Base 기반) — GDPval 45.5 → 73.6, APEX 5.0 → 21.3. 100B 미만 공개 모델 중 GDPval이 가장 높았던 ClawGym-30A3(35.0)보다 38.6점 높아요.
- WorkForge-27B(Qwen3.5-27B 기반) — GDPval 79.4 → 82.4, APEX 25.7 → 29.9. 논문은 GDPval에서 총 파라미터가 거의 15배 많은 Qwen3.5-397B-A17B(79.7)를 넘었다고 밝혔어요.
논문은 GDPval과 APEX를 전문 업무 결과물과 업무 도구 다루기를 보는 벤치마크로 소개해요. 이 논문은 GDPval의 공식 220개 과제 중 이미지 등이 필요한 19개를 뺀 201개로, 승률이 아니라 공식 기준표 점수를 썼고, 과제마다 한 번씩(Claude Code 실행 환경 · 최대 14,400초 · 300턴) 돌렸어요. 같은 표에서 상용 모델은 Claude Opus 5.0이 91.0, GPT-5.6 Sol이 90.1로 WorkForge 모델들보다 높아요.
WildClawBench · Claw-Eval · Agents' Last Exam(ALE)에서도 두 모델 모두 기반 모델보다 점수가 올랐어요. 예를 들어 ALE 점수는 A3B가 11.4 → 28.7, 27B가 32.7 → 33.9예요.
한계
논문은 WorkForge가 전문가 업무 흐름과 구할 수 있는 실제 자료에 기대기 때문에, 비공개 · 민감한 분야에선 같은 방식으로 만들기 어렵다고 적었어요. 채점기의 정확도는 작업 공간 자동 분석이 얼마나 정확한지에 달려 있고, 최종 결과물 위주로 채점해 중간 과정은 직접 보지 않는다고도 밝혔어요. 논문 페이지에는 코드나 데이터 공개 링크가 없어요.