양자화 모델을 vLLM에서 더 빠르게 — Ant Group · vLLM이 커널 라이브러리 Humming을 오픈소스로 공개했어요
vLLM 블로그(10월 21일)에 Humming이 소개됐어요. 양자화(모델 숫자를 더 적은 비트로 줄이는 것)된 모델의 계산을 맡는 커널 모음이고, DeepSeek-V4.1-Flash 서빙 시험에서 출력 처리량이 약 14~43% 올랐어요.
- Humming은 Ant Group과 vLLM 커뮤니티가 공개한 양자화 추론용 커널 라이브러리예요. 여러 양자화 형식을 하나의 공통 형식으로 바꾼 뒤, 작업에 맞는 커널을 그때그때 컴파일(JIT)해서 써요. 라이선스는 Apache-2.0이에요.
- vLLM 0.29.0부터 CUDA 설치에 Humming이 함께 들어가서 따로 설치할 필요가 없고, 실행 옵션 --linear-backend humming --moe-backend humming으로 켜요. NVIDIA는 Turing(SM75) 이후 GPU를 지원해요.
- 원문 서빙 시험(DeepSeek-V4.1-Flash, H20 8장)에서 MoE 계산을 Marlin W4A16에서 Humming W4A8로 바꾸자 출력 처리량 약 14~43%↑, 첫 토큰까지 걸리는 시간(TTFT) 약 25~32%↓였어요. 원문에 나오는 '약 5배'는 모델 전체 속도가 아니라, B300 GPU에서 MoE W4A16 커널을 큰 배치로 시험한 일부 경우(Grouped 방식)의 커널 단위 결과예요.
vLLM으로 GPTQ · MXFP4 같은 양자화 모델을 서빙하고 있다면, vLLM 0.29.0 이상에서 실행 옵션 두 개만 붙여 지금 쓰는 백엔드와 처리량 · 첫 토큰 시간을 나란히 재 볼 수 있어요.
같은 GPU에서 동시 요청을 더 받아야 할 때 GPU를 늘리기 전에 커널만 바꿔 보는 선택지예요. 다만 원문 숫자는 H20 · H200 · B300 같은 데이터센터 GPU 기준이라, 우리 GPU에서는 직접 재 봐야 해요.
API로 모델을 쓰는 경우엔 직접 쓸 일이 없어요. 집 PC의 NVIDIA GPU로 양자화 모델을 vLLM에 올려 쓰고 있다면 옵션을 켜 보는 정도로 시험해 볼 수 있어요(Turing 이후 지원).
1. vLLM을 0.29.0 이상으로 올리세요(원문: 이 버전부터 CUDA 설치에 Humming이 함께 들어가요). vLLM 없이 따로 쓰려면(원문 그대로): pip install humming-kernels
2. 원문 예시 그대로 실행: vllm serve deepseek-ai/DeepSeek-V4.1-Flash-1017 --tensor-parallel-size 8 --linear-backend humming --moe-backend humming
3. GPTQ INT3 같은 형식은 원문 예시처럼: vllm serve hfl/Qwen2.5-VL-3B-Instruct-GPTQ-Int3 --quantization humming
4. 옵션을 뺀 기존 실행과 같은 요청으로 처리량 · TTFT를 비교해 보세요.

직접 GPU에 양자화한 오픈 모델을 올려 자막 정리나 글 초안 같은 일괄 작업을 돌리고 있다면, 옵션 두 개만 켜서 같은 작업이 얼마나 빨리 끝나는지 비교해 보면 좋을 것 같아요. API로만 모델을 쓴다면 당장 쓸 곳은 없어 보여요.
vLLM 공식 블로그에 10월 21일 Humming 소개 글이 올라왔어요. Ant Group과 vLLM 커뮤니티가 함께 오픈소스로 공개한 양자화 추론용 커널 라이브러리예요. 양자화는 모델의 숫자를 4비트 · 8비트처럼 더 적은 비트로 줄여 메모리와 데이터 이동을 줄이는 방법이고, 커널은 GPU에서 실제 계산(행렬 곱)을 하는 코드예요.
무엇이 다른가
원문은 양자화 형식이 많아질수록 형식마다 전용 커널을 따로 만들고 관리해야 하는 문제를 짚어요. Humming은 여러 양자화 형식을 하나의 공통 형식(Humming standard format)으로 바꾸고, 층 설정 · 계산 설정 · 튜닝 설정 세 가지로 커널을 정해 그때그때 컴파일(JIT, 실행할 때 바로 컴파일)해요.
- 지원 장치: NVIDIA Turing 이후 GPU(SM75 이상)와 T-Head의 Zhenwu 810E 같은 CUDA 호환 장치
- 일반(dense) 층과 MoE(전문가 여러 개 중 일부만 쓰는 구조) 층을 모두 지원
- 컴파일 시간: H200 · CUDA 13.4 · 캐시 끈 상태에서 W4A16 커널 하나를 컴파일하는 데 CUTLASS(NVCC) 23.35초, Humming 1.82초(NVCC) · 1.88초(NVRTC)
- 라이선스: Apache-2.0(GitHub 기준)
숫자로 보면 (원문 기준, 비교 대상 함께)
아래는 커널 단위 시험이에요. 모델 전체 속도와는 달라요.
- 일반 층 W4A16(가중치 4비트 · 활성값 16비트): cuBLAS 대비 작은 배치에서 여러 장치에서 약 3~4배. 큰 배치에서는 H200에서 vLLM Marlin의 약 2배, B300 일부 경우 3배 넘게
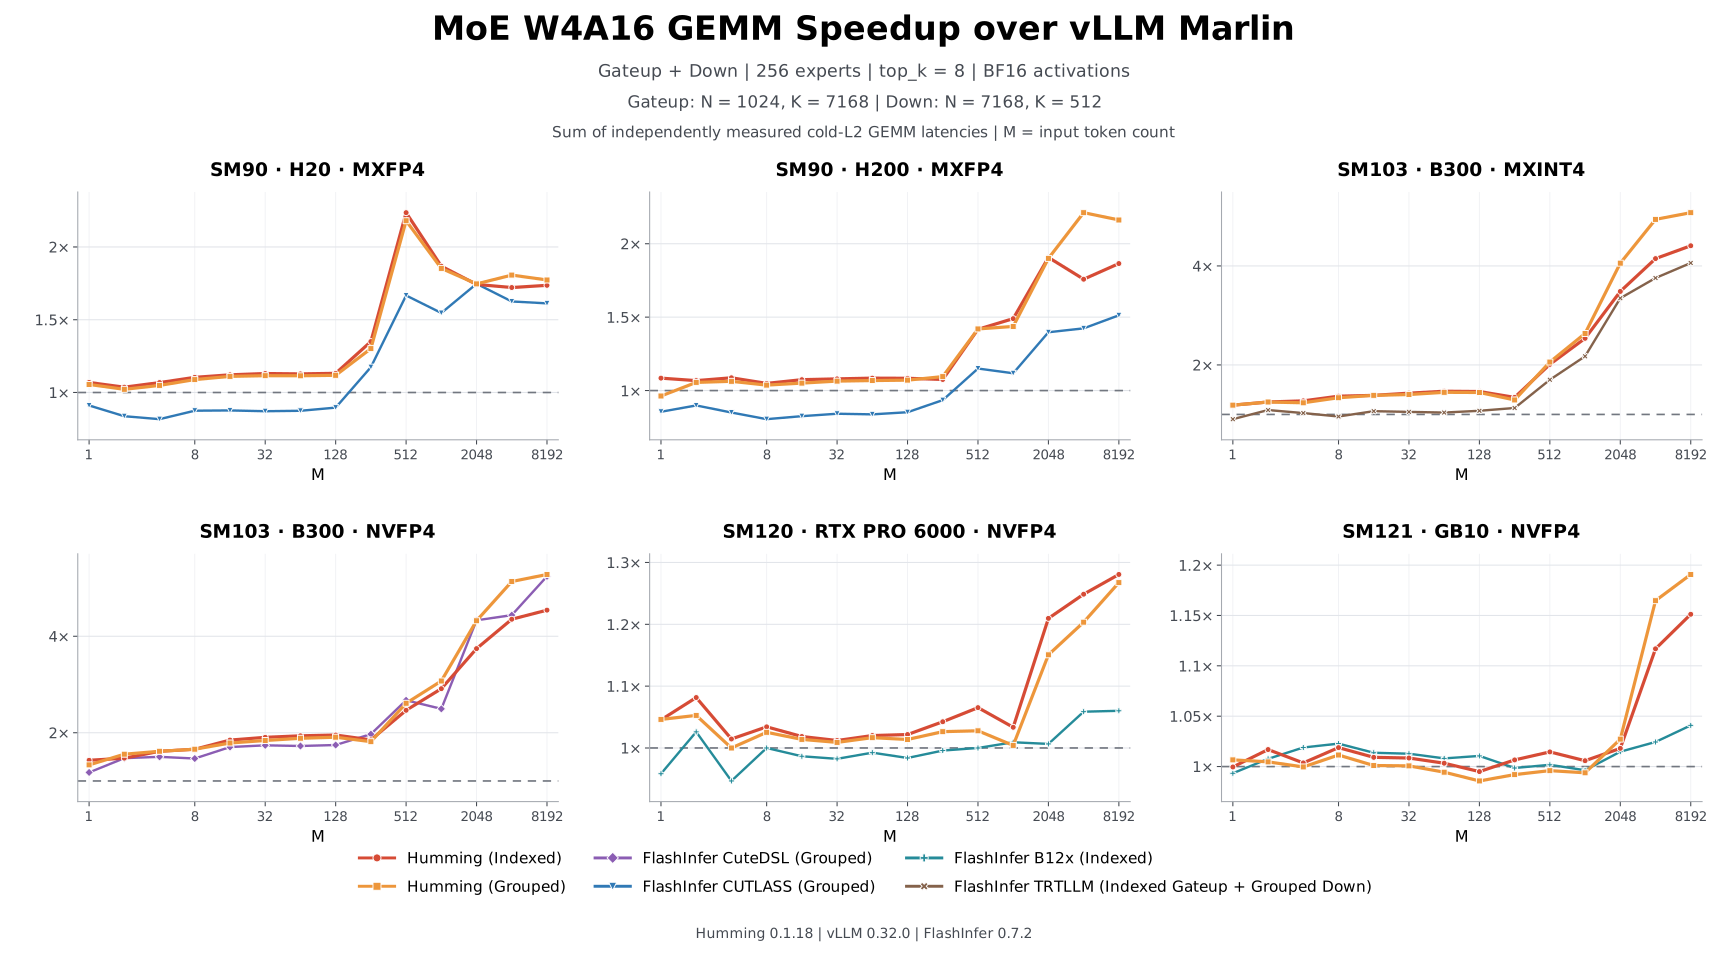
- MoE W4A16: H20 · H200의 MXFP4가 중간~큰 배치 여러 경우에서 Marlin의 약 2배. B300에서는 MXINT4 · NVFP4 경로가 큰 배치에서 더 크게 앞서고, Grouped 방식은 약 5배
- W8A8(H20 · H200): 작은~중간 배치에서 DeepGEMM Contiguous의 약 2.6배 · 2.5배
- W4A8-MXFP4(H20 · H200): 작은~중간 배치에서 DeepGEMM W8A8의 약 4.2배 · 4.5배
실제 서빙에서는
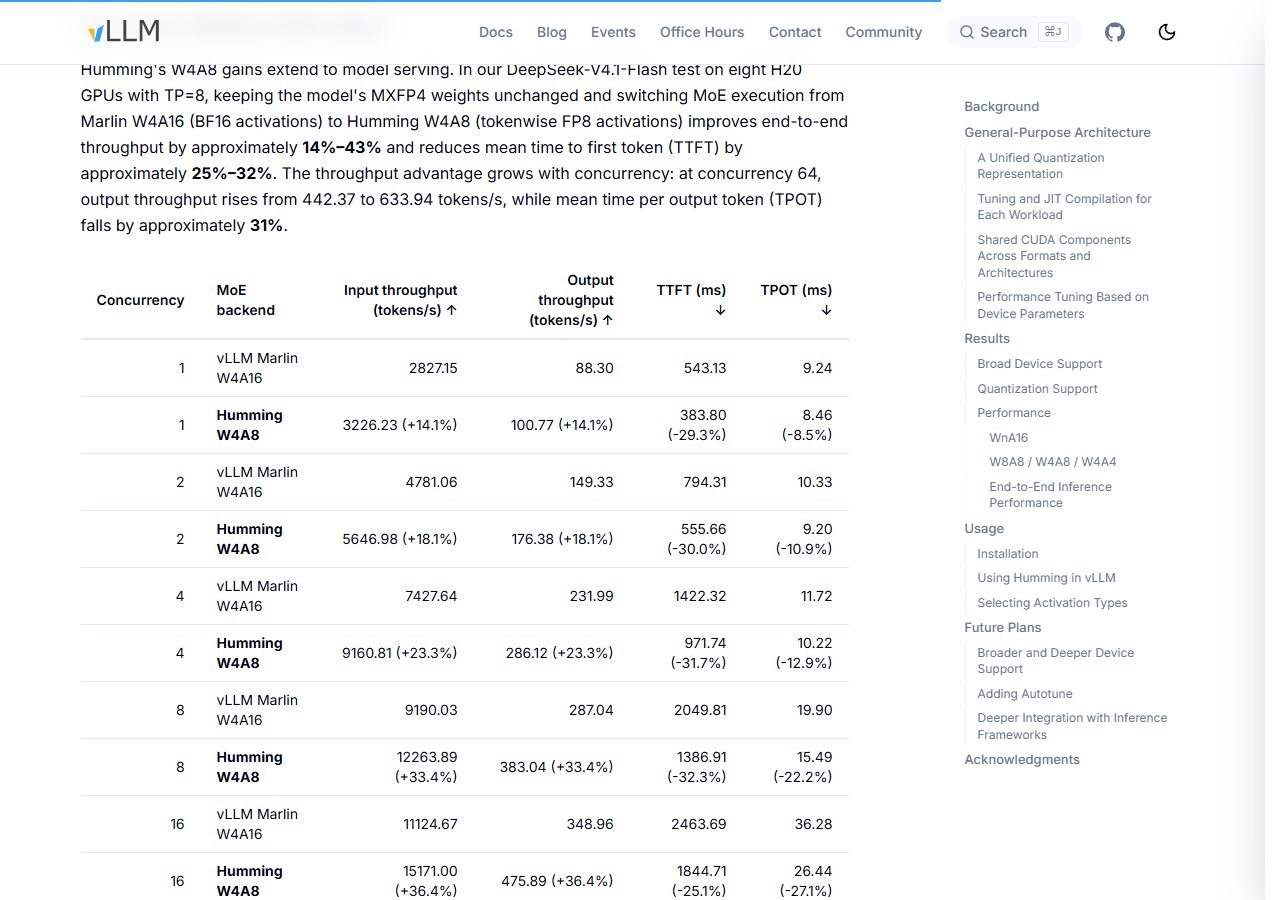
원문은 DeepSeek-V4.1-Flash를 H20 GPU 8장(TP=8)에 올리고, MXFP4 가중치는 그대로 둔 채 MoE 계산만 Marlin W4A16(BF16 활성값)에서 Humming W4A8(FP8 활성값)로 바꿔 시험했어요. 동시 요청 1~64에서 출력 처리량은 약 14~43% 올랐고, 첫 토큰까지 걸리는 평균 시간(TTFT)은 약 25~32% 줄었어요. 동시 요청 64에서는 출력 처리량이 442.37 → 633.94 토큰/초, 토큰 하나당 평균 시간(TPOT)은 약 31% 줄었어요.
쓰는 법
원문에 따르면 vLLM 0.29.0부터 CUDA 설치에 Humming이 의존성으로 들어가서 따로 설치할 필요가 없어요. 실행할 때 --linear-backend humming --moe-backend humming으로 켜고, GPTQ INT3 같은 형식은 --quantization humming으로 쓸 수 있어요. 따로 설치할 땐 pip install humming-kernels예요.
앞으로는 Rubin 아키텍처 기능, Zhenwu M890 등 T-Head 장치 확대, 자동 튜닝(autotune), 전문가 병렬용 양자화 All-to-All 통신 같은 프레임워크 연동을 계획한다고 적었어요.