AA-3D — AI가 만든 3D 장면, 사람이 직접 보고 순위를 매겨요
Artificial Analysis가 AA-3D 벤치마크를 공개했어요. 21개 AI 모델이 글 설명만 보고 three.js 3D 장면을 만들면, 패널이 블라인드 투표로 순위를 정해요. 1위 Claude Sonnet 5.5(Elo 1194), 장면 하나 비용은 $0.20~$32.08.
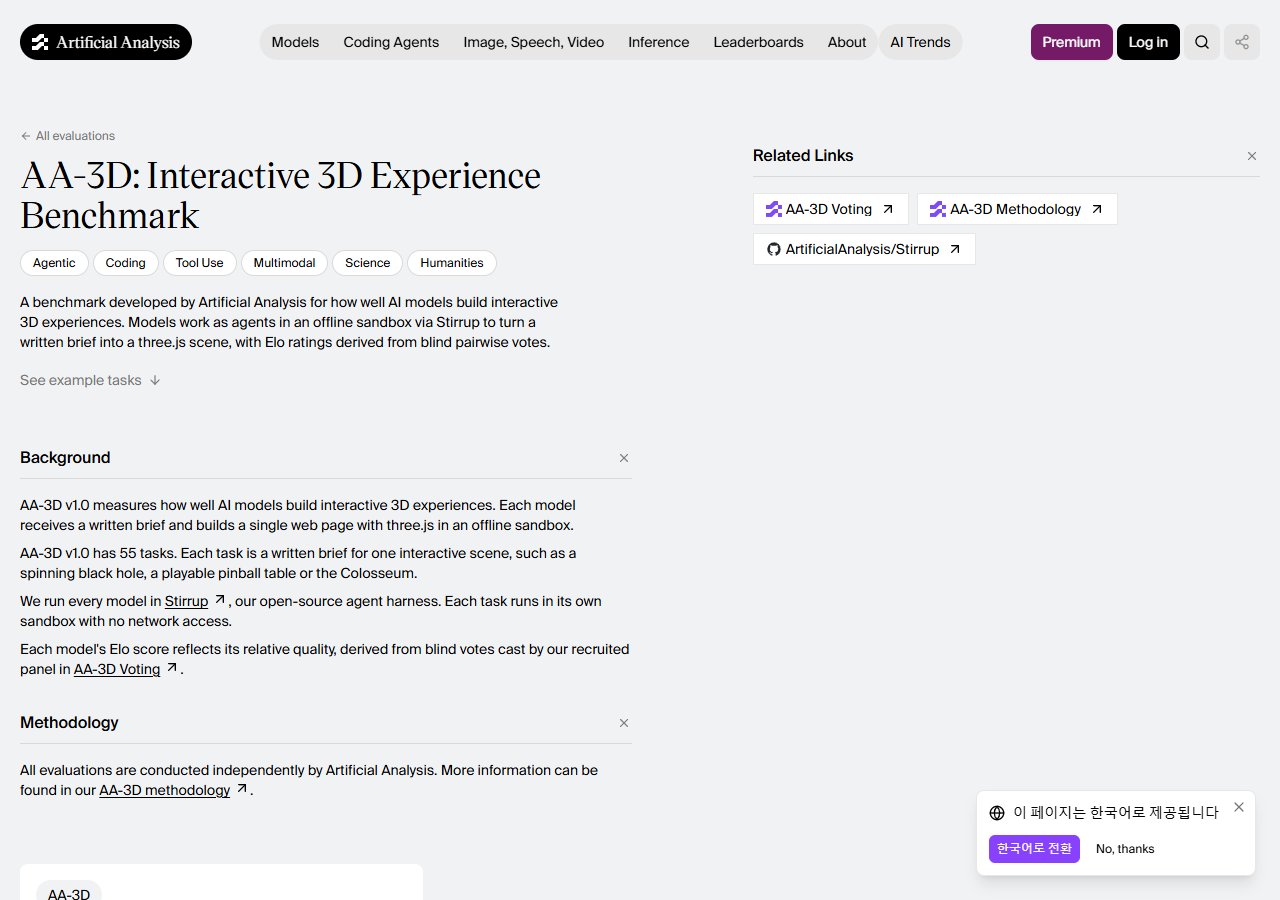
- AA-3D는 AI 모델이 글 설명(brief)만 보고 three.js로 인터랙티브 3D 장면을 만드는 벤치마크예요. 55개 태스크, 21개 모델, 1만 건 넘는 블라인드 투표로 Elo 순위를 매겨요.
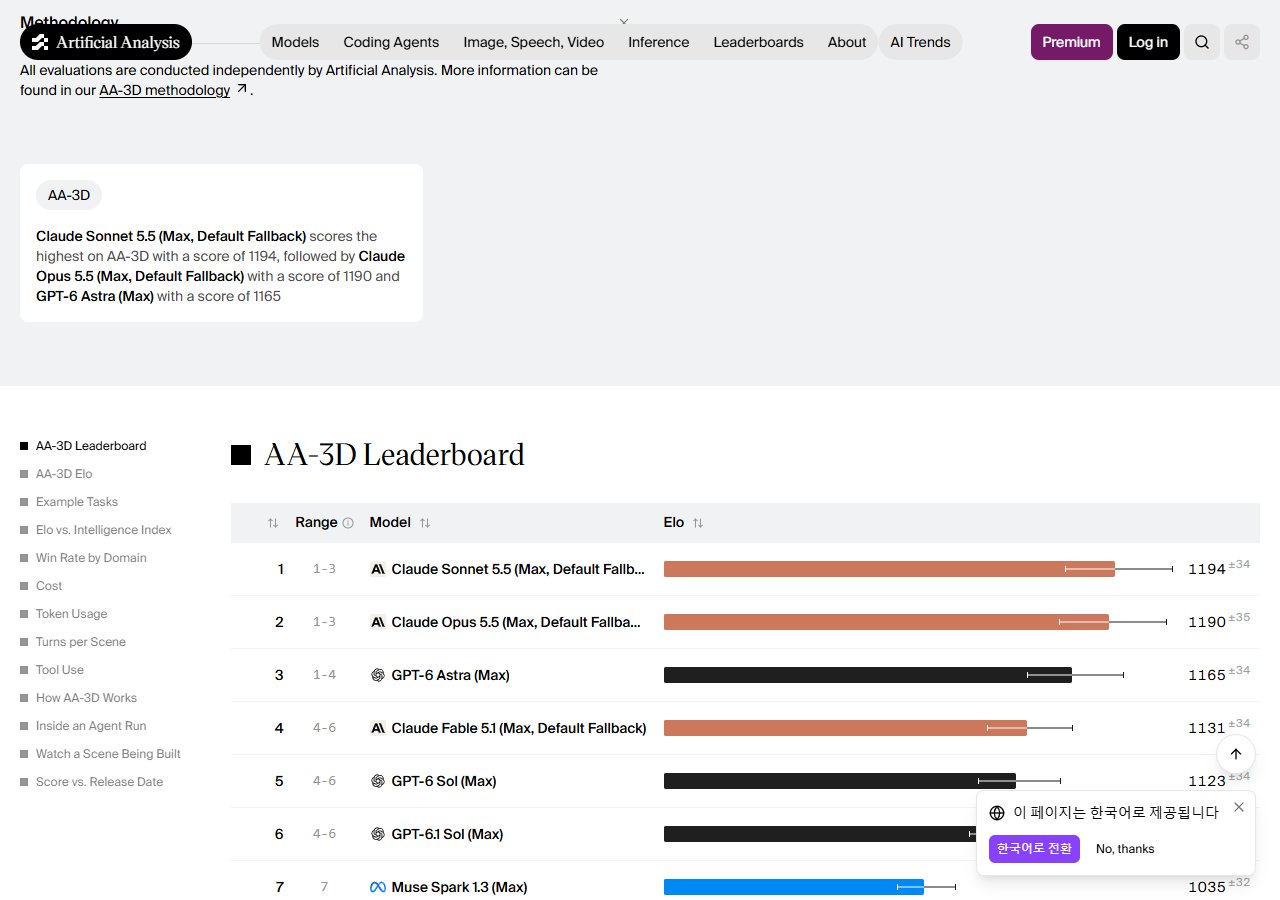
- 1위 Claude Sonnet 5.5(1194)와 2위 Opus 5.5(1190)가 통계적으로 동률이에요. 3위 GPT-6 Astra(1165), 4위 Claude Fable 5.1(1131). 상위 4개가 신뢰구간 안에서 겹쳐요.
- 장면 비용이 모델마다 $0.20~$32.08으로 160배 차이 나요. 디테일이 많은 장면이 투표의 63%를 가져가고, 적은 장면은 31%에 그쳤어요.
three.js로 인터랙티브 데모·프로토타입을 만들 때, 순위표에서 비용 대비 품질이 맞는 모델을 골라 에이전트에 붙여 볼 수 있어요.
제품 랜딩 페이지에 3D 인터랙티브 장면을 넣고 싶을 때, AA-3D 순위를 보고 모델을 고르면 시행착오를 줄일 수 있어요.
3D 웹 경험(쇼룸·전시)을 외주 없이 AI로 빠르게 프로토타입할 때, 비용표($0.20~$32)를 보고 예산에 맞는 모델을 고를 수 있어요.
1. artificialanalysis.ai/3d/vote 에서 블라인드 투표를 직접 해 보세요
2. 리더보드에서 모델별 비용·Elo를 비교하세요
3. Stirrup(오픈소스 에이전트 하네스)으로 원하는 모델을 three.js 생성에 연결해 보세요
4. 만든 장면을 브라우저에서 바로 확인하세요
캐릭터 굿즈나 쇼룸을 3D 인터랙티브 페이지로 만들어 볼 때, AA-3D 순위를 참고해서 모델을 골라 보면 좋을 것 같아요.
AI 모델에게 "회전하는 블랙홀을 만들어 줘" 같은 글 설명(brief)만 주면, 모델이 에이전트로 작동하면서 three.js 인터랙티브 3D 장면을 통째로 만들어요. 이 결과물을 사람이 블라인드로 비교 투표해서 순위를 매기는 벤치마크가 AA-3D예요.
어떻게 평가하나요?
Artificial Analysis가 자체 오픈소스 에이전트 하네스 Stirrup으로 21개 모델을 돌려요. 각 모델은 오프라인 샌드박스(Blender, Rapier 물리 엔진, Python, 헤드리스 브라우저, CC0 에셋 라이브러리 포함)에서 최대 3시간 또는 250턴 안에 장면을 완성해요.
완성된 장면 쌍을 모집된 패널이 어떤 모델이 만들었는지 모른 채 비교 투표해요. 1만 건 넘는 투표 결과를 Bradley-Terry 모델로 계산해서 Elo 점수를 내요. 95% 신뢰구간도 함께 공개해요.
리더보드 — 상위 4개가 통계적 동률
55개 태스크(회전하는 블랙홀, 플레이 가능한 핀볼 테이블, 콜로세움 등) 기준, 상위 10개 모델:
- Claude Sonnet 5.5 — 1194 (±34)
- Claude Opus 5.5 — 1190 (±35)
- GPT-6 Astra — 1165 (±34)
- Claude Fable 5.1 — 1131 (±34)
- GPT-6 Sol — 1123 (±34)
- GPT-6.1 Sol — 1114 (±33)
- Muse Spark 1.3 — 1035 (±32)
- GPT-6 Luna — 1000 (기준점)
- Claude Haiku 5.5 — 994 (±32)
- Grok 4.7 — 994 (±32)
1~4위의 신뢰구간이 겹쳐서, 통계적으로는 Claude Sonnet 5.5·Opus 5.5·GPT-6 Astra·Fable 5.1이 동률권이에요. 하위권에는 Mistral Large 4(868), Inkling(579), Nemotron 3 Ultra(569) 등이 있어요.
비용 차이가 160배
장면 하나를 만드는 데 드는 비용이 모델마다 $0.20~$32.08이에요. 비싼 모델이 반드시 높은 순위는 아니라서, 비용 대비 품질을 따져 볼 필요가 있어요.
디테일이 승부를 가른다
AA-3D가 발견한 패턴 중 흥미로운 것: 디테일이 많은 장면이 투표의 63%를 가져가고, 디테일이 적은 장면은 31%에 그쳤어요. 또 상위 모델일수록 자기 결과물을 일찍 확인하는 경향이 있어요(중앙값 10~13턴에 첫 확인).
범용 지능(Intelligence Index)과 3D 성능의 상관관계도 높아요. Intelligence Index 1점당 Elo가 약 18점 올라가지만, OpenAI GPT-6 계열은 예측보다 높은 성능을 보였어요.
다만
Elo 점수는 투표 패널의 선호에 따라 달라질 수 있어요. 현재 v1.0이라 태스크 수(55개)가 코딩 벤치마크보다 적고, 패널 규모도 공개되지 않았어요. "인터랙티브 3D"라는 특정 분야의 벤치마크라서, 다른 3D 작업(CAD, 게임 엔진 등)에는 바로 적용하기 어려워요.