AI 모델 종합 점수판 Artificial Analysis 인덱스 v5 — 60%를 비공개 시험으로, 1위 Claude Opus 5.5 58점
Artificial Analysis가 10월 27일 Intelligence Index v5를 공개했어요. 처음으로 점수의 60%가 비공개 시험 · 정답 비공개 평가에서 나와요. 1위는 Claude Opus 5.5(max) 58점이고, 오픈 웨이트 모델과의 차이는 3점에서 12점으로 벌어졌어요.
- v5는 시험 9개로 짜였어요. 새로 FrontierCode 2.0 · Terminal-Bench-Science가 들어오고, HLE-Diamond · AA-Omniscience v1.1 · CritPt v2가 새 판으로 바뀌었어요. 점수의 60%가 비공개 시험 세트나 정답을 숨긴 평가에서 나와요.
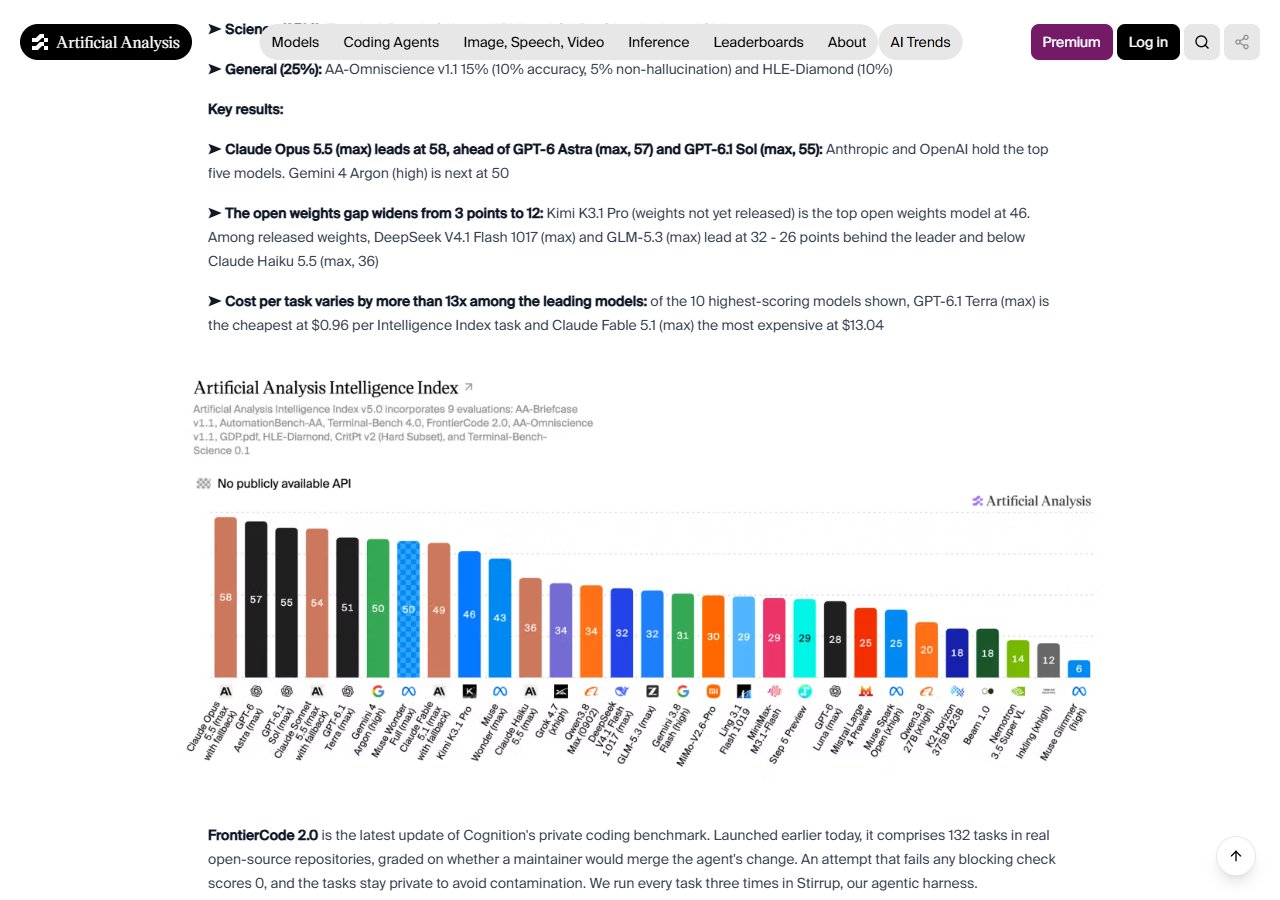
- 10월 27일 출시 글 기준 1위 Claude Opus 5.5(max) 58점, 2위 GPT-6 Astra(max) 57점, 3위 GPT-6.1 Sol(max) 55점이에요. 9개 시험을 모두 1위 한 모델은 없어요(Opus 5.5가 3개 1위).
- 오픈 웨이트 1위 Kimi K3.1 Pro(아직 가중치 미공개)는 46점으로 1위와 12점 차이(v4.3 땐 3점)예요. 과제당 비용은 Opus 5.5 $10.04 · GPT-6.1 Sol $1.27로, Sol은 4점 낮은 대신 약 8분의 1 비용이에요.
API 모델을 고를 때 점수만 보지 말고 과제당 비용을 함께 보세요. GPT-6.1 Sol(max)은 1위보다 4점 낮고 비용은 약 8분의 1이에요.
「어떤 AI가 제일 똑똑하냐」는 콘텐츠를 만들 때 시험별 1위가 다 다르다는 점(9개 중 Opus 5.5가 3개)을 함께 짚으면 정확해요.
같은 모델도 노력 설정(low · max)에 따라 점수와 비용이 크게 달라요. 일상 작업은 낮은 설정부터 써 보고 필요할 때만 올리는 기준으로 삼을 만해요.
구독 · API 모델을 바꿀지 고민될 때, 내 작업과 가까운 시험(코딩이면 FrontierCode · Terminal-Bench, 문서 업무면 AA-Briefcase) 1위와 과제당 비용을 나란히 보는 표로 써 보면 좋을 것 같아요.
Artificial Analysis가 10월 27일 AI 언어 모델 종합 점수판 Intelligence Index v5를 공개했어요. 여러 벤치마크(성능 시험)를 묶어 한 점수로 보여 주는 지표로, 1월에 나온 v4 이후 가장 큰 개편이라고 해요. 처음으로 점수의 60%가 비공개 시험 세트나 정답을 공개하지 않은(held-out) 평가에서 나와요. 예를 들어 새로 들어온 FrontierCode 2.0은 오염(시험 문제가 학습 데이터에 섞이는 것)을 막으려고 과제를 비공개로 둔다고 적었어요.
무엇이 바뀌었나요
- 새로 들어온 시험: FrontierCode 2.0(Cognition의 비공개 코딩 시험 · 저장소 관리자가 그 수정을 합칠 만한지로 채점) · Terminal-Bench-Science(터미널에서 하는 과학 연구 과제 70개)
- 새 판으로 바뀐 시험: HLE-Diamond(Humanity's Last Exam을 다듬은 1,000문항 판 · 추론과 지식 반반) · AA-Omniscience v1.1(너무 쉬워진 문제 · 공개 문제를 빼고 새 문제 추가) · CritPt v2(비공개 40문항 어려운 묶음 · 코드 실행 도구와 함께)
- 그대로: AA-Briefcase · AutomationBench-AA · GDP.pdf · Terminal-Bench 4.0
- 빠진 시험: GDPval-AA v2.1 · SciCode · AA-LCR v1.1
네 분야가 25%씩이에요 — 지식 업무(AA-Briefcase 15% · AutomationBench-AA 5% · GDP.pdf 5%) · 코딩(FrontierCode 2.0 15% · Terminal-Bench 4.0 10%) · 과학(Terminal-Bench-Science 15% · CritPt v2 10%) · 일반(AA-Omniscience v1.1 15% · HLE-Diamond 10%).
순위 (10월 27일 출시 글 기준)
- 1위 Claude Opus 5.5 (max) 58점 · 2위 GPT-6 Astra (max) 57점 · 3위 GPT-6.1 Sol (max) 55점. 상위 5개를 Anthropic과 OpenAI가 차지했고, 그다음은 Gemini 4 Argon (high) 50점이에요.
- 시험별 1위는 나뉘어요: Claude Opus 5.5가 FrontierCode 2.0(46%) · HLE-Diamond(68%) · AA-Omniscience v1.1(48) 3개, GPT-6 Astra가 Terminal-Bench-Science(63%) · CritPt v2(72%) 2개, Claude Sonnet 5.5가 AA-Briefcase(1812 Elo), Kimi K3.1 Pro가 Terminal-Bench 4.0(67%), Gemini 4 Argon이 AutomationBench-AA(78%), Muse Wonder Full이 GDP.pdf(33%)에서 1위예요.
오픈 웨이트 모델은 더 뒤처졌어요
오픈 웨이트(내려받아 돌릴 수 있는 모델) 1위는 Kimi K3.1 Pro(가중치는 아직 공개 전) 46점으로, 1위와 12점 차이예요. v4.3에선 3점 차이였어요. 이미 가중치가 공개된 모델 중에선 DeepSeek V4.1 Flash 1017 (max)과 GLM-5.3 (max)가 32점으로 가장 높은데, Claude Haiku 5.5 (max)의 36점보다 낮아요.
비용 · 노력 설정 차이가 커요
- 과제당 비용(인덱스 과제 하나당): Claude Opus 5.5 (max) $10.04 · GPT-6 Astra (max) $6.24 · GPT-6.1 Sol (max) $1.27. Sol은 Opus 5.5보다 4점 낮지만 비용은 약 8분의 1이에요. 상위 10개 모델 중 가장 싼 건 GPT-6.1 Terra (max) $0.96, 가장 비싼 건 Claude Fable 5.1 (max) $13.04예요.
- 노력(effort) 설정: Claude Opus 5.5는 low에서 35점, max에서 58점이고, 과제당 비용은 $0.98 대 $10.04로 약 10배예요. v5에선 노력 설정에 따른 점수 차이가 v4.3보다 커졌어요.
- 출력 토큰: 측정한 모든 모델이 v4.3보다 과제당 출력 토큰을 더 많이 썼어요. 중앙값이 3만 5천에서 5만 9천으로 늘었어요.
Artificial Analysis는 v5와 함께, 2022년 11월 이후 나온 모델을 한 눈금에 놓고 시간에 따른 실력 변화를 보는 Progress Index v1도 내놨어요. 지금 쓸 모델을 고를 땐 Intelligence Index를 보라고 안내해요.