AI에게 홍보 영상을 '코드로' 짜게 했더니 — Code2Video-AA 1위 Claude Opus 5.5, 4위는 10분의 1 가격
Artificial Analysis가 10월 26일 새 벤치마크 Code2Video-AA를 공개했어요. 모델 27개가 제품 · 브랜드 영상 기획서 114개를 HTML 영상 코드로 만들었고, Claude Opus 5.5(max with fallback)가 1536 Elo로 1위예요. 과제당 비용은 $0.01부터 $3.89까지 300배 넘게 차이 나요.
- Code2Video-AA는 HeyGen의 Code2Video Bench를 Artificial Analysis가 따로 구현한 시험이에요. 모델이 기획서 하나를 받아 도구 없이 한 번에 HyperFrames HTML 영상(index.html · 배치는 HTML, 움직임은 GSAP)을 짜고, Gemini 4 Argon 심사 모델이 이름을 가린 채 두 영상을 비교해요.
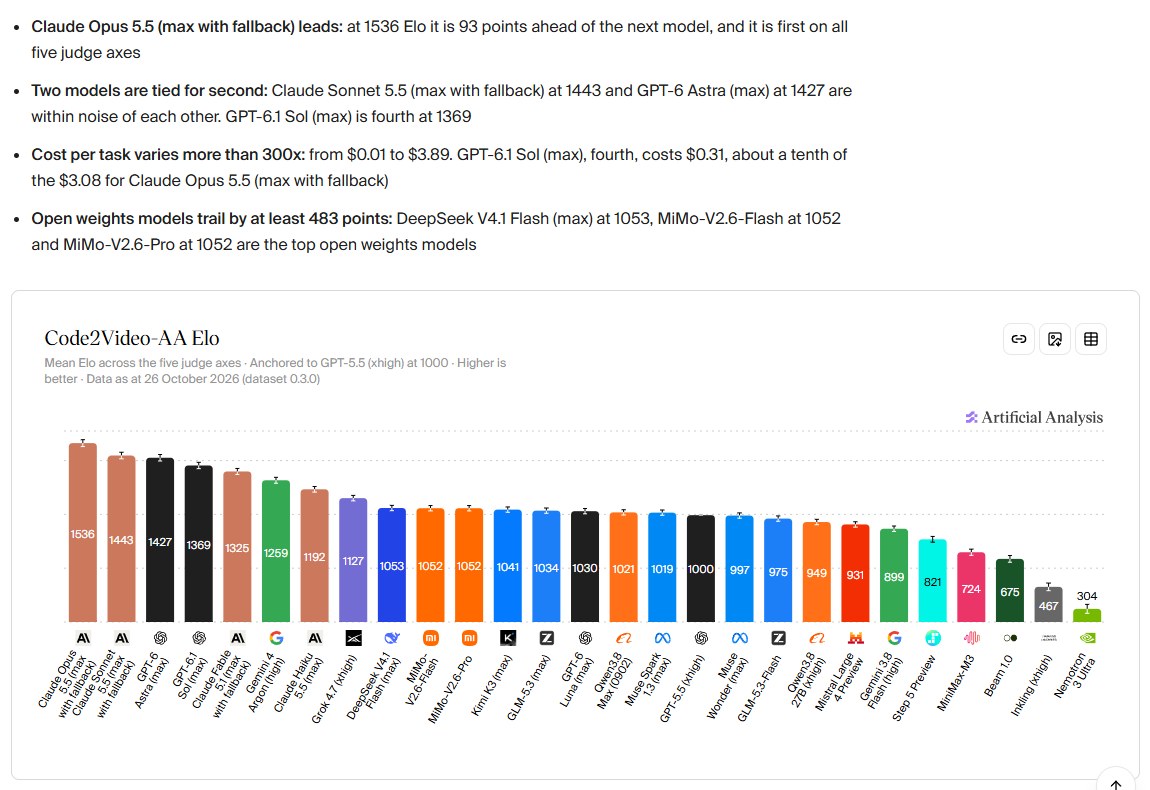
- 10월 26일 기준 1위는 Claude Opus 5.5(max with fallback) 1536 Elo로 2위보다 93점 높고, 심사 항목 5개 모두 1위예요. 2위 Claude Sonnet 5.5(1443)와 3위 GPT-6 Astra(1427)는 오차 안이고, 4위는 GPT-6.1 Sol(max) 1369예요.
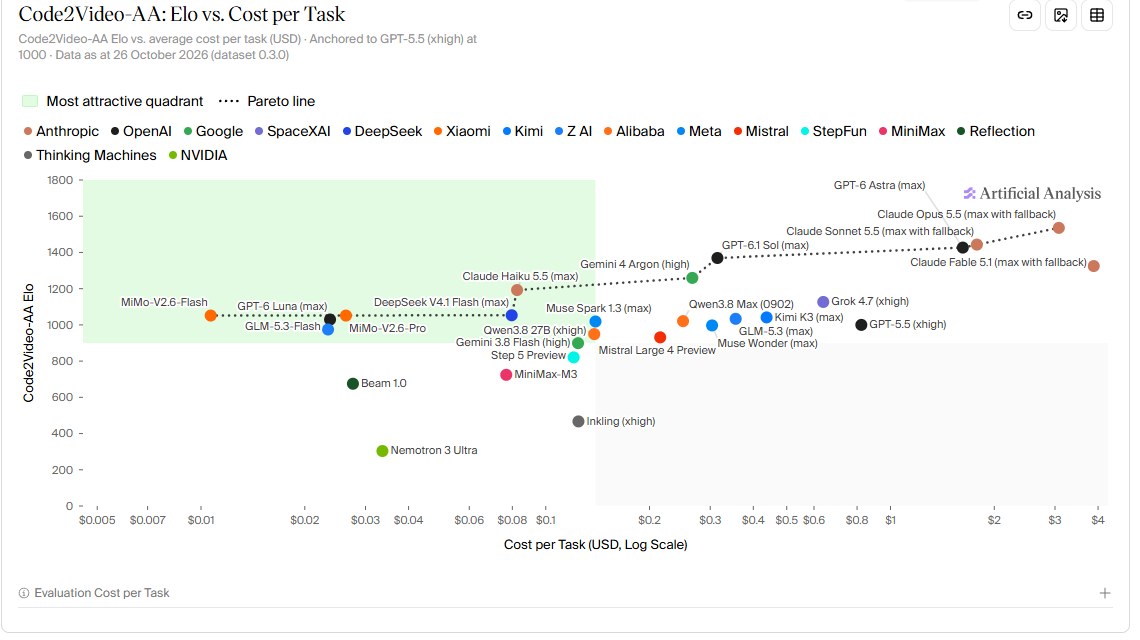
- 다만 가격 차이가 커요. 과제당 Opus 5.5는 $3.08, GPT-6.1 Sol(max)은 $0.31로 약 10분의 1이에요. 오픈 웨이트 모델은 1위보다 483점 넘게 낮아요(최고 DeepSeek V4.1 Flash(max) 1053).
제품 소개 · 앱 데모처럼 글자와 화면이 움직이는 짧은 모션 영상을 AI에게 코드로 짜게 할 때, 어떤 모델을 쓸지 고르는 기준표로 볼 수 있어요.
HyperFrames로 영상 자동화를 만든다면, 비싼 1위 대신 GPT-6.1 Sol(과제당 $0.31)이나 Claude Haiku 5.5($0.08)로 먼저 시험해 보고 품질 차이를 재 볼 만해요.
기획서 예시처럼 장면별 시간 · 색 · 카메라 규칙을 자세히 적을수록 좋다는 걸 영상 의뢰서 쓰는 틀로 참고할 수 있어요.
1) 리더보드에서 내 예산에 맞는 모델 2~3개 고르기
2) 출시 글의 기획서 예시처럼 장면 · 시간 · 색을 적은 브리프 만들기
3) HyperFrames는 공식 문서의 설치 안내를 따르세요
4) 같은 브리프로 모델별 결과와 비용을 나란히 비교
짧은 제품 소개 · 카드형 모션 영상을 코드로 뽑아 볼 때, 비싼 모델 하나로 가기 전에 4위 · 7위 모델로 먼저 비교해 보면 좋을 것 같아요.
Artificial Analysis가 10월 26일 Code2Video-AA 결과를 공개했어요. AI 모델이 짧은 제품 · 브랜드 영상을 코드로 설계하는 실력을 재는 벤치마크(성능 시험)예요. HeyGen이 만든 Code2Video Bench의 기획서 114개를 Artificial Analysis가 독립적으로 다시 돌린 판이에요.
어떻게 시험하나요
- 쓰기: 모델에게 영상 기획서 하나와 HeyGen의 시스템 프롬프트를 한 번에 보내요. 도구는 주지 않아요. 모델은 HyperFrames 형식의 HTML 파일(index.html) 하나를 돌려줘요 — 화면 배치는 HTML, 움직임은 GSAP(웹 애니메이션 라이브러리)로 짜요.
- 렌더: 그 코드를 실제 영상으로 뽑아요. 영상이 안 나오면 그 비교는 모두 져요.
- 심사: Gemini 4 Argon 심사 모델이 같은 기획서로 만든 두 모델의 영상을 모델 이름을 모른 채 비교해요. 항목은 5개 — 몰입도(engagement) · 기획 의도(prompt intent) · 구도(composition) · 시간 흐름의 일관성(temporal consistency) · 완성도(craft)예요.
- 순위: 항목마다 Elo(맞대결 점수)를 따로 매기고, 5개 평균이 종합 점수예요. GPT-5.5(xhigh)를 1000점 기준으로 잡았어요.
기획서 예시를 보면 「모바일 앱 와이어프레임 편집기 데모, 16:9, 약 7.3초」처럼 장면별 시간 · 색상 코드 · 카메라 규칙까지 자세히 적혀 있어요.
결과 (10월 26일 · dataset 0.3.0 기준)
- 1위 Claude Opus 5.5 (max with fallback) — 1536. 2위보다 93점 높고 5개 항목 모두 1위예요. Claude Sonnet 5.5보다 완성도(craft)에서 128점, 기획 의도에서 48점 앞서요.
- 공동 2위 — Claude Sonnet 5.5 (max with fallback) 1443 · GPT-6 Astra (max) 1427. 두 점수는 오차 안이라고 적었어요.
- 4위 GPT-6.1 Sol (max) — 1369. 그다음은 Claude Fable 5.1 1325 · Gemini 4 Argon (high) 1259 · Claude Haiku 5.5 (max) 1192 순이에요.
- 오픈 웨이트 모델(내려받아 돌릴 수 있는 모델) — 가장 높은 DeepSeek V4.1 Flash (max) 1053, MiMo-V2.6-Flash 1052, MiMo-V2.6-Pro 1052예요. 1위보다 적어도 483점 낮아요.
가격은 300배 넘게 차이 나요
과제 하나당 비용은 MiMo-V2.6-Flash의 $0.01부터 Claude Fable 5.1의 $3.89까지예요. 1위 Opus 5.5는 과제당 $3.08, 4위 GPT-6.1 Sol (max)은 $0.31로 약 10분의 1이에요. Claude Haiku 5.5 (max)는 1192점에 $0.08이에요. GPT-6 Astra (max)는 $1.62로 GPT-6.1 Sol보다 5배 비싸지만 점수는 58점 높아요.
과제당 출력 토큰도 약 1만 1천(Nemotron 3 Ultra)부터 약 17만 6천(Claude Sonnet 5.5)까지 16배 차이 나요. Claude 5.5 세 모델은 과제당 약 15만 2천~17만 6천 토큰을 써서, 나머지 24개 모델(평균 약 4만 2천 · 중앙 약 3만 4천)보다 훨씬 많아요. 차이의 대부분은 생각(추론) 토큰이고, 실제 영상 코드가 든 최종 답은 모델마다 약 4천~1만 2천 토큰이에요.
영상이 안 나오는 경우는 드물어요
전체 3,078개 과제 중 3,042개(98.8%)가 영상으로 렌더됐어요. 27개 모델 중 8개는 114개를 모두 렌더했고, 가장 낮은 GLM-5.3 (max)도 114개 중 110개였어요. 가장 낮은 세 모델도 111~113개를 렌더했기 때문에, 이들의 낮은 점수는 대부분 렌더된 영상에 대한 심사 결과에서 나왔다고 해요.