RTX 30 그래픽카드의 BF16 AI 연산이 최대 84% 빨라졌다는 보고 — 오픈소스 'gpu-unlock', 다만 리눅스 전용 · 게임 숫자는 없어요
GitHub 사용자 Zagitta가 10월 18일 공개한 리눅스 커널 모듈 gpu-unlock이 화제예요. RTX 30 시리즈(GA102 · GA103 · GA104 · GA106 칩)에서 FP16/BF16 연산 명령을 내는 속도를 전문가용 카드 수준으로 푼다는 도구예요. 사용자 보고표에선 BF16 행렬 곱셈이 카드에 따라 +25~84% 빨라졌어요. 엔비디아가 낸 도구는 아니고, 원문에 게임 FPS 숫자는 없어요.
- gpu-unlock은 엔비디아 드라이버가 카드를 잡기 전에 먼저 돌아가는 리눅스 커널 모듈이에요. RTX 30 시리즈의 FP/BF16 연산(FP32로 더하는 방식) 명령 속도를 두 배로 올린다고 README에 적혀 있어요. 2026년 10월 18일 GitHub에 공개됐어요.
- README 표 기준 RTX 3090 Ti(450W)는 BF16 87.50 → 157.41 TFLOPS예요. 사용자 보고표의 BF16 행렬 곱셈 향상 폭은 3060 12GB 약 +80% · 3070 +73~81% · 3090 +25~67%이고, 40 시리즈로 넓힌 별도 저장소도 나왔어요.
- 다만 빨라지는 건 행렬 계산이 많은 일(LLM 프롬프트 읽기 · 이미지 생성 같은 디퓨전)이에요. LLM이 글자를 내는 속도와 INT8 연산은 거의 그대로이고, 원 저장소는 리눅스 전용 · 결과는 카드마다 사용자 보고예요.
리눅스에서 RTX 30 카드로 로컬 LLM · 이미지 생성을 돌린다면 README의 'Tested cards' 표에서 내 카드(PCI ID)의 보고 결과부터 보세요. 프롬프트가 긴 작업(prefill)일수록 차이가 크고, 글자를 내는 속도는 거의 안 바뀐다고 적혀 있어요.
윈도우 PC에서 ComfyUI로 이미지 · 영상을 뽑고 있다면 지금 바로 쓸 길은 거의 없어요. 원 저장소는 리눅스 전용이고, 윈도우 쪽은 특정 메인보드 · 카드 조합에서만 성공이 보고된 실험 단계 별도 프로젝트예요.
새 그래픽카드를 살지 고민 중이라면, 지금 쓰는 RTX 30 · 40 카드에서 이 방식이 얼마나 검증되는지 몇 주 지켜본 뒤 정해도 늦지 않아요. 게임 성능 숫자는 원문에 없어요.
1) README의 'Tested cards' 표에서 내 카드 이름 · PCI ID · 보고된 결과를 확인한다(40 시리즈는 JustAResearcher/gpu-unlock-ada의 'Supported targets' 표)
2) 'Boot flow and opt-in' 단락을 읽는다 — 부팅 옵션(gpu_unlock.targets=)을 켜야만 동작하고, 화면 카드는 리셋 순간 잠깐 꺼진다고 적혀 있다
3) 내 작업이 행렬 계산 위주(디퓨전 · 긴 프롬프트)인지, 글자 생성 · INT8 위주인지 먼저 따져 본다
· 라이선스: 커널 모듈 GPL-2.0-only(엔비디아 펌웨어는 엔비디아 약관) · 비용: 무료
당장 쓸 곳은 적어 보여요. 다만 리눅스 PC에 RTX 30 카드로 이미지 생성을 돌리고 있다면, 같은 카드 보고가 더 쌓이는지 표를 지켜보다가 판단해 보면 좋을 것 같아요.
GitHub 사용자 Zagitta가 2026년 10월 18일 공개한 오픈소스 gpu-unlock이 화제예요. 지포스 RTX 30 시리즈 그래픽카드의 FP/BF16 연산 명령 속도를 '전문가용 카드와 같은 수준'으로 푼다는 도구예요(README 첫 줄 · 'to their professional equivalents'). 저장소 별은 10월 27일 0시 기준 8,755개예요. 국내에서도 10월 25일 이 저장소를 소개한 한 X 사용자의 글이 같은 시각 기준 147만 회 넘게 조회됐어요.
무엇을 하는 도구인가
gpu-unlock은 리눅스 커널 모듈(운영체제 깊은 곳에서 돌아가는 작은 프로그램)이에요. README 설명은 이래요.
- 엔비디아 드라이버가 카드를 잡기 전에 먼저 돌아서, 카드 안의 '속도 선택 값'(speed selectors)을 쓰고 카드를 한 번 리셋(FLR)한 뒤, 고치지 않은 엔비디아 드라이버에 넘겨요.
- UEFI(부팅 단계) 앱도 아니고 드라이버를 고친 판도 아니라서, 엔비디아가 새 드라이버를 낼 때마다 다시 손볼 필요가 없다고 해요.
- 효과는 GA102 · GA103 · GA104 · GA106 칩 카드에서 'FP/BF16 곱셈-덧셈을 FP32로 쌓는 연산'의 명령 속도를 두 배로 올리는 것이라고 적혀 있어요.
- 방식은 예전 CMP(채굴 전용 카드) 잠금 해제 기법과 UEFI 방식의 '드라이버보다 먼저' 타이밍을 합친 것이라고 README가 밝혔어요.
숫자로 보면
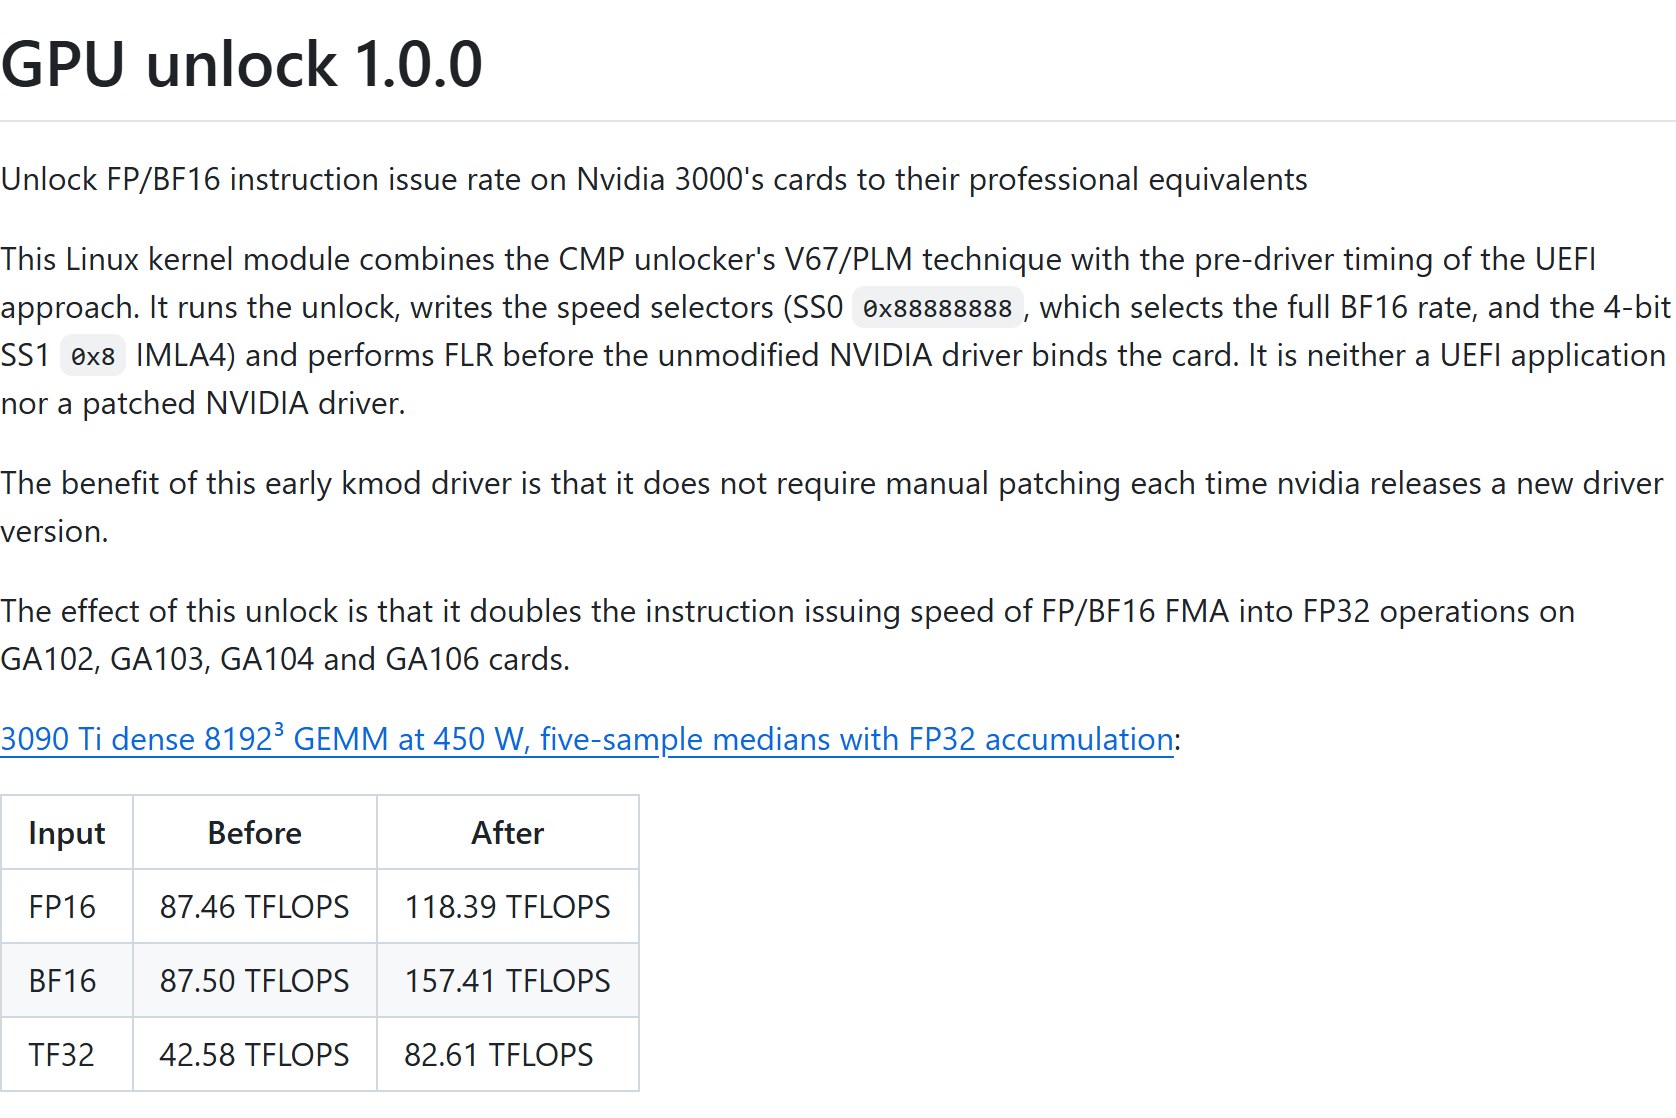
README 맨 위 표는 RTX 3090 Ti 한 장을 450W에서 8192³ 크기 행렬 곱셈(GEMM)으로 다섯 번 재서 가운데 값을 낸 결과예요(FP32로 쌓는 방식).
- BF16: 87.50 → 157.41 TFLOPS
- FP16: 87.46 → 118.39 TFLOPS
- TF32: 42.58 → 82.61 TFLOPS
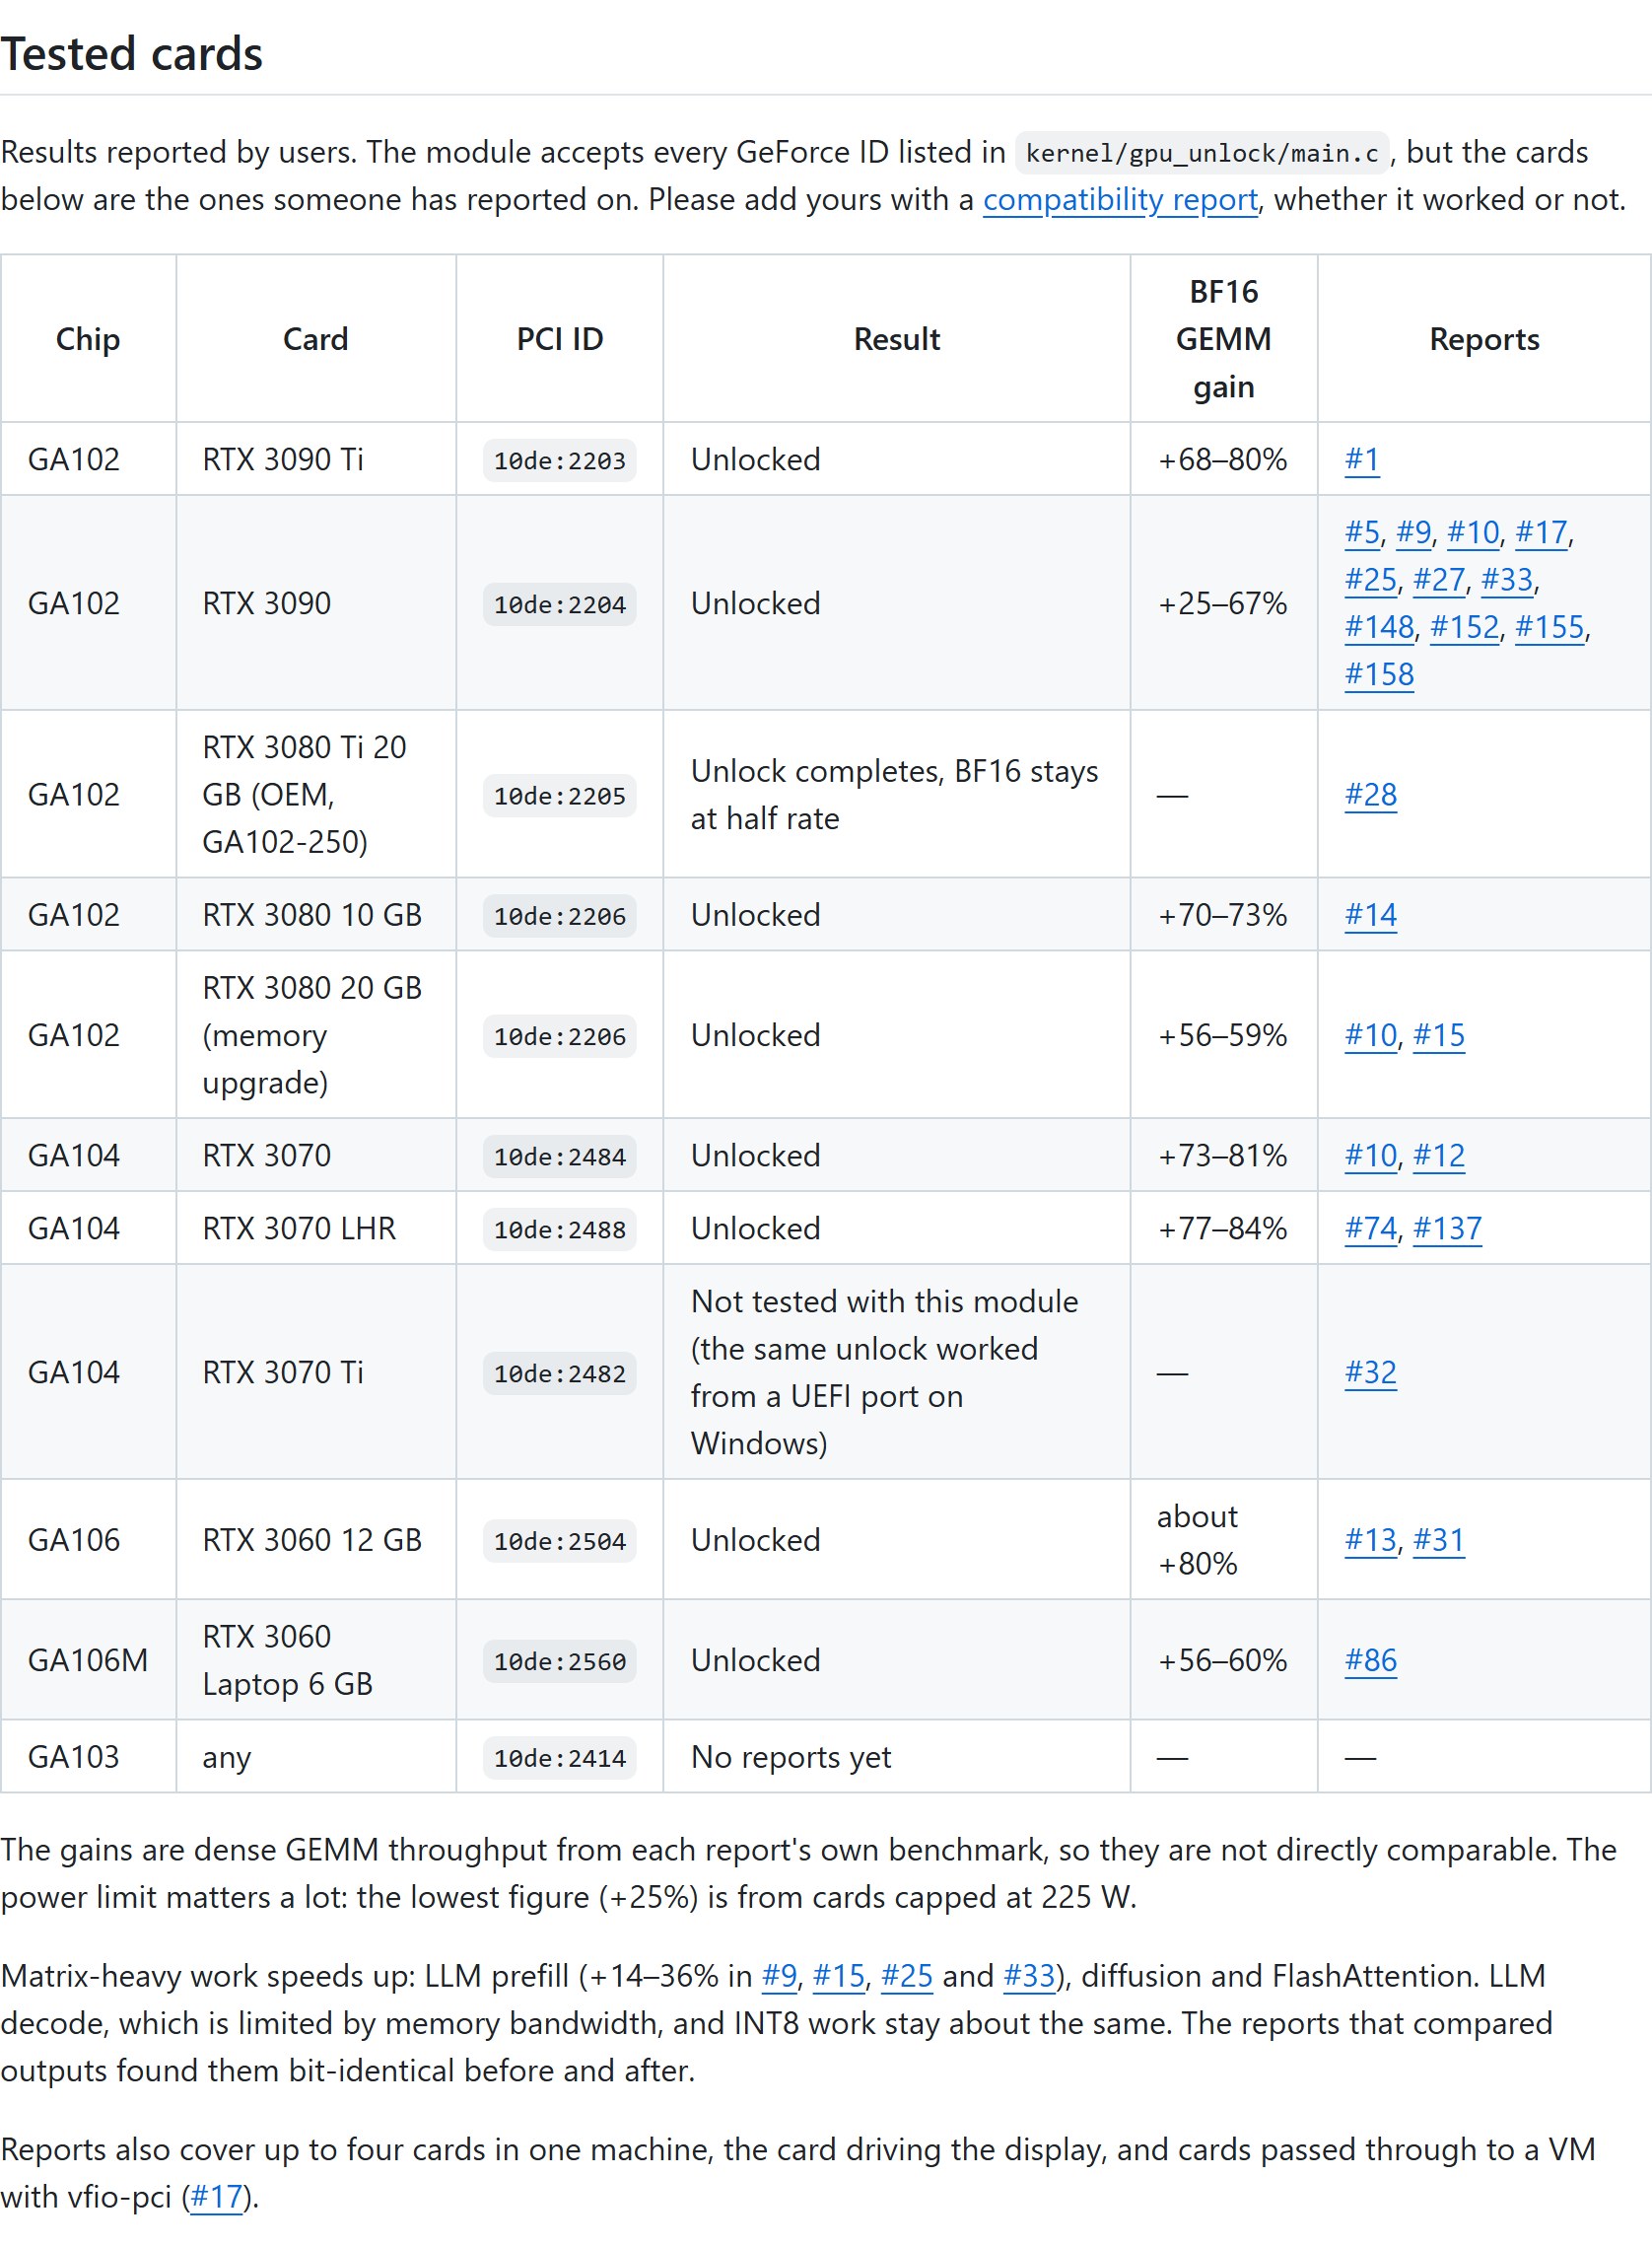
아래 'Tested cards' 표는 사용자들이 보내온 보고를 모은 것이고, BF16 행렬 곱셈 향상 폭은 이래요.
- RTX 3090 Ti +68~80% · RTX 3090 +25~67% · RTX 3080 10GB +70~73% · RTX 3080 20GB(메모리 개조) +56~59%
- RTX 3070 +73~81% · RTX 3070 LHR +77~84% · RTX 3060 12GB 약 +80% · RTX 3060 노트북 6GB +56~60%
- RTX 3080 Ti 20GB(OEM)는 잠금 해제 과정은 끝나지만 BF16이 절반 속도 그대로였고, GA103 칩은 아직 보고가 없어요. RTX 3070 Ti는 이 모듈로는 시험 전이고, 윈도우용 UEFI 이식판에서 같은 해제가 됐다는 보고만 있어요.
README는 이 숫자들이 보고마다 각자 잰 벤치마크라 서로 바로 비교할 수 없고, 전력 제한이 결과를 크게 바꾼다고 적었어요. 가장 낮은 +25%는 225W로 제한한 카드에서 나왔어요. 3090 사용자 보고(GitHub 이슈 #85)에선 전력 제한 420W를 그대로 둔 채 BF16이 76.994 → 127.923 TFLOPS(+66.1%)였고, 측정된 최대 소비전력은 420.33W → 419.92W였어요.
어떤 일이 빨라지나
README에 따르면 행렬 계산이 많은 일이 빨라져요. LLM 프롬프트 읽기(prefill)는 사용자 보고 4건에서 +14~36%였고, 디퓨전(이미지 생성 방식) · FlashAttention도 빨라졌다고 적혀 있어요. 반대로 메모리 속도에 묶이는 LLM 글자 생성(decode)과 INT8 연산은 거의 그대로예요. 해제 전후 출력을 비교한 보고들은 결과가 비트 단위까지 같았다(bit-identical)고 해요.
게임은 따로 다루지 않아요. README의 숫자는 모두 AI용 행렬 연산 기준이고, 게임 FPS 숫자는 원문에 없어요.
40 시리즈 · 윈도우는
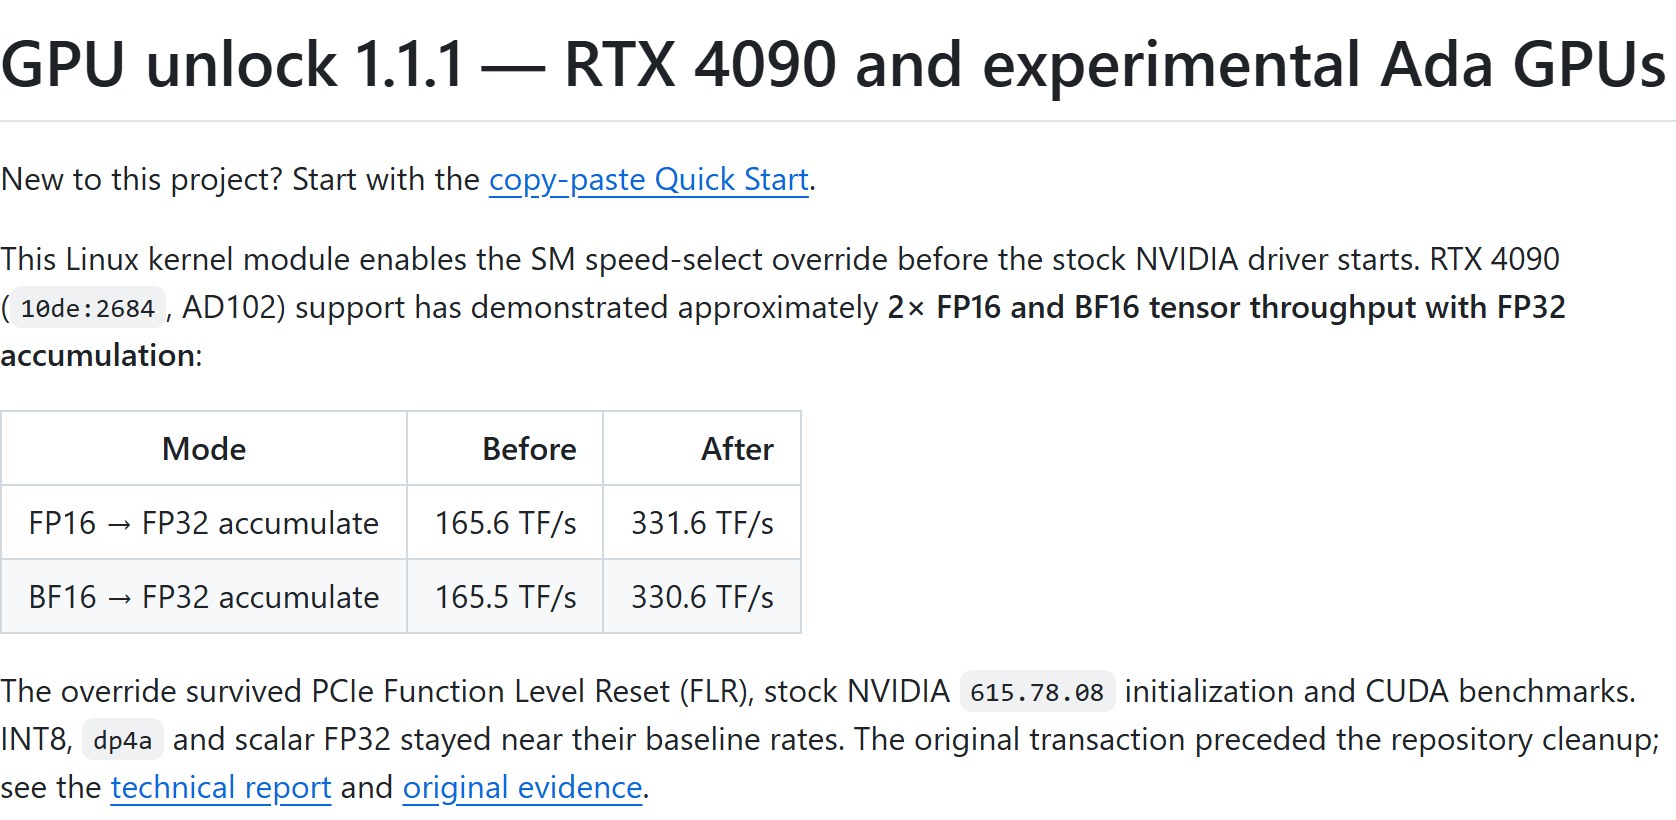
- 40 시리즈: 별도 저장소 JustAResearcher/gpu-unlock-ada가 10월 23일(UTC) 만들어졌어요. README 기준 RTX 4090은 FP16 · BF16(FP32로 쌓기) 명령 처리량이 약 2배(BF16 165.5 → 330.6 TF/s)였어요. 다만 다른 4090 사용자의 실제 cuBLAS 행렬 곱셈에선 FP16 +12~34%, BF16은 두 크기에서 +16~20%이고 4096³ 크기에선 거의 그대로였다고 함께 적었어요. 4070 · 4060 등 다른 40 시리즈 카드는 '실험' 표시이고, README는 카드 종류마다 한 장~몇 장의 결과라고 적었어요.
- 윈도우: 원 저장소는 리눅스 전용이에요. 윈도우는 별도 프로젝트(impacifist/Windows-GPU-UNLOCK)가 UEFI 부팅 단계 방식으로 시도 중인데, 스스로 '실험'이라고 밝혔고 성공 보고도 특정 메인보드 · 카드 조합에 한정된다고 적었어요.
알아 둘 것
- 엔비디아가 낸 도구가 아니라 개인 개발자가 공개한 오픈소스예요. 커널 모듈은 GPL-2.0-only이고, 엔비디아 펌웨어는 엔비디아 약관을 따른다고 README에 적혀 있어요.
- 부팅 옵션
gpu_unlock.targets=를 넣어야만 동작하고, 부팅이 끝난 뒤 손으로 불러오면 이미 드라이버가 잡은 카드엔 아무 일도 하지 않아요. - 화면을 내보내는 카드는 리셋 순간부터 엔비디아 화면 드라이버가 넘겨받을 때까지 화면이 꺼져 있어요. 카드의 펌웨어가 멈추지 않으면 전원을 완전히 껐다 켠 뒤 다시 하라고 적혀 있어요. 최대 절전(hibernation)은 다루지 않아요.
- 40 시리즈 저장소는 노트북마다 VBIOS · 전원 · 리셋 처리가 달라 한 모델의 결과가 다른 모델로 이어지지 않는다고 적었어요.
숫자는 10/27 0시 기준 README(커밋 ece2629) · 이후 README가 바뀜