Databricks 에이전트 기억 장치 MemCurrent — 사내 시험에서 통과율 22.3%→68.4%, 토큰은 31% 적게
Databricks가 10월 20일 연구 블로그에 에이전트용 장기 기억 구조 MemCurrent를 공개했어요. 새 Agent Bricks Memory와 Genie에 들어가 있어요.
- MemCurrent는 에이전트가 일하면서 기억을 읽고 쓰고, 오프라인 '드리밍(dreaming)' 작업이 그 기억을 정리해 일관되고 새롭게 유지하는 구조예요. 새 Agent Bricks Memory와 Genie에 쓰여요.
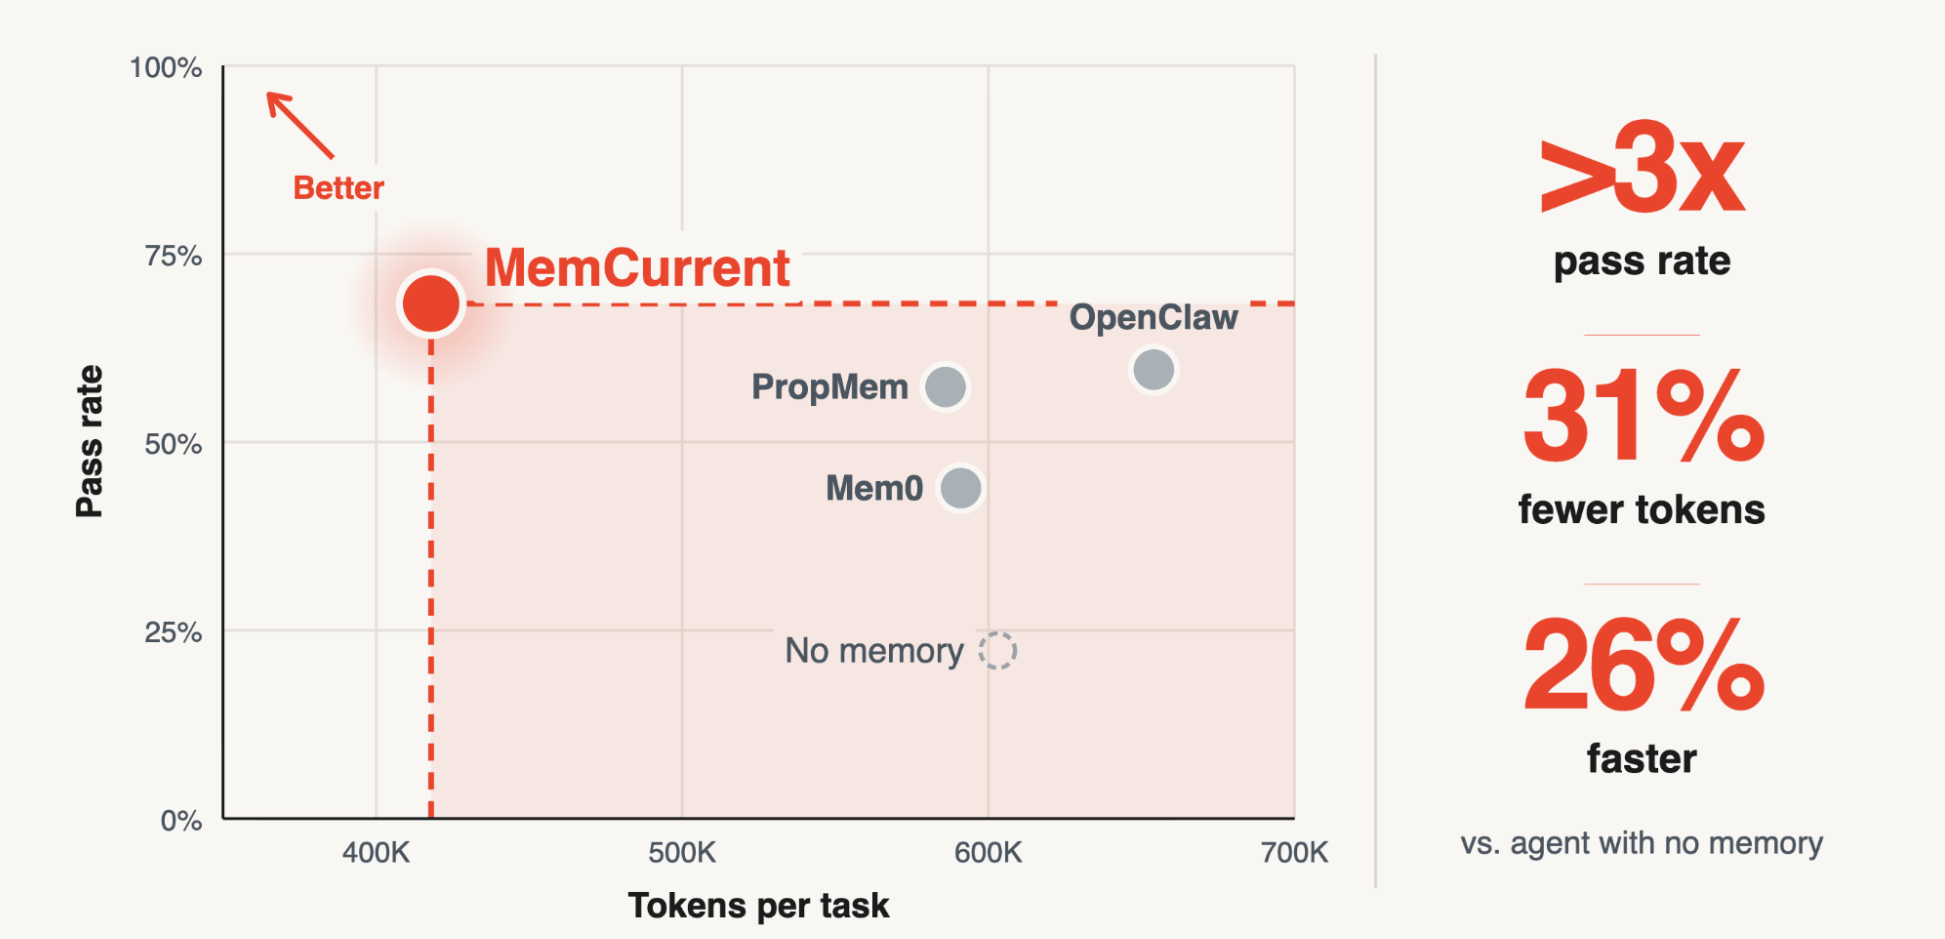
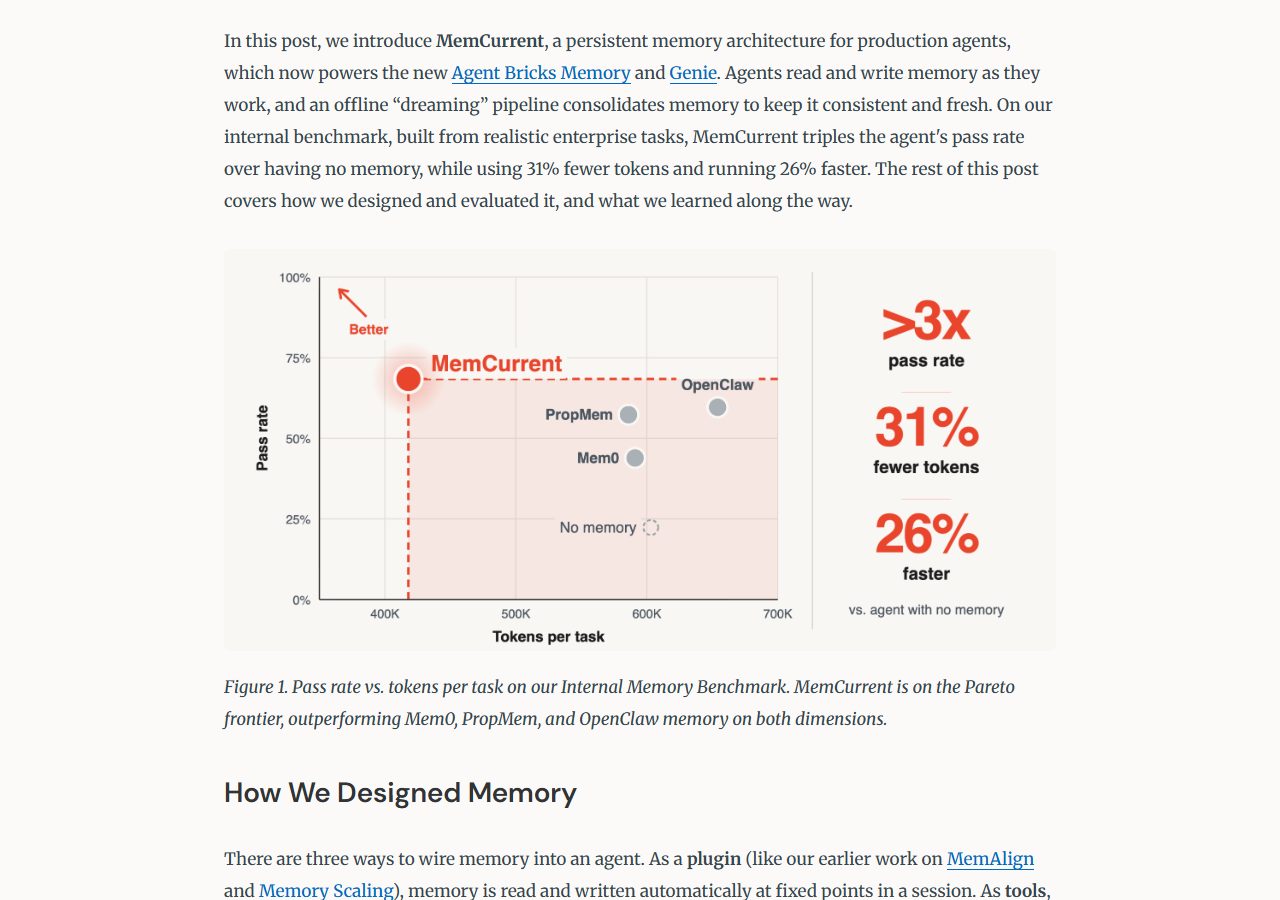
- 실제 Genie 대화로 만든 사내 시험(114문항)에서 기억 없을 때보다 통과율이 22.3%→68.4%로 약 3배, 토큰 31% 적게, 26% 빠르게 나왔어요(에이전트 Claude Opus 4.6 기준).
- 공개 벤치마크 3개(LoCoMo · LongMemEval · ConvoMem) 평균에선 대화 전체를 넣는 방식(87.8%)과 비슷한 88.1%를, 질문당 입력 토큰 약 12배 적게(8.4K vs 103K) 냈어요(GPT 5.6 luna 기준).
Databricks 위에서 에이전트를 만든다면 Agent Bricks Memory의 세션 저장소(대화 원본) · 기억 저장소(정리된 사실)를 붙여 볼 수 있어요. 둘 다 Lakebase에 저장되고, 세션을 지워도 기억 저장소의 기억은 남는다고 문서에 적혀 있어요.
Databricks를 안 써도 설계는 참고할 만해요. 대화 원본(에피소드 기억)과 정리한 교훈 파일(파생 기억)을 나누고, 맨 위에 파일 구조를 설명하는 memory.md 색인을 두는 방식이에요.
Genie를 쓰고 있다면 이미 뒤에서 MemCurrent가 돌고 있다고 원문에 적혀 있어요. 처음 6분 가까이 걸린 질문이 비슷한 다음 질문에선 41초로 줄어든 사례가 실렸어요.
1. Databricks 사용자라면 문서 'Stateful agents' 페이지에서 Agent Bricks 빠른 시작(quickstart)을 따르세요. 원문에 따르면 함께 오는 CLI로 세션 · 기억 · 드리밍까지 갖춘 예제 에이전트를 10분 안에 띄울 수 있어요.
2. 이미 만든 에이전트가 있으면 같은 페이지에 링크된 '기존 에이전트에 세션과 기억 붙이기' 튜토리얼을 따르세요.
3. Databricks를 안 쓰면 원문의 구조만 빌려 보세요: 세션 원본은 그대로 쌓고, 배운 점은 따로 파일로 정리하고, 맨 위에 memory.md 색인을 둬요.

직접 만든 자동화 에이전트가 매번 같은 표 · 같은 경로를 처음부터 다시 찾는다면, 원문 사례처럼 성공한 작업 순서를 파일로 남겨 다음 실행 때 읽게 하는 것부터 따라 해 보면 좋을 것 같아요. 다만 숫자는 Databricks 사내 시험 기준이라, 내 작업에서 얼마나 줄어드는지는 직접 재 봐야 할 것 같아요.
Databricks AI 연구팀이 2026년 10월 20일 연구 블로그에 MemCurrent를 공개했어요. 실제 서비스에서 돌아가는 에이전트(스스로 도구를 써 가며 일하는 AI)를 위한 장기 기억(persistent memory) 구조예요. 원문은 MemCurrent가 이제 새 Agent Bricks Memory와 Genie(데이터에 대해 묻고 답하는 Databricks 기능)를 움직인다고 밝혔어요.
원문이 짚은 문제는 이거예요. 기억은 사용자 취향 · 지난 정정 · 지표 정의 · 성공한 작업 흐름을 다음 일로 넘겨 줄 수 있지만, 지난 대화를 전부 넣으면 비용이 크고 낡거나 서로 어긋나는 맥락이 섞여요. 그래서 무엇을 남기고, 어떻게 유지하고, 쓸모를 어떻게 잴지가 핵심이라고 했어요.
어떻게 만들었나
- 두 가지 기억: 세션 원본을 그대로 쌓는 에피소드 기억과, 거기서 배운 점을 정리해 구조화된 지식 파일로 두는 파생 기억. 파생 기억 맨 위에는 파일 구조와 각 파일 내용을 설명하는
memory.md색인이 자동으로 만들어져요. - 세 가지 연결 방식: 정해진 시점에 자동으로 읽고 쓰는 플러그인, 에이전트가 필요할 때 부르는 도구, 그리고 오프라인 파이프라인.
- 드리밍(dreaming): 오프라인에서 기억을 모아 정리해 일관되고 새롭게 유지하는 작업이에요.
숫자는 어디서 나왔나
사내 시험(Internal Memory Benchmark): 실제 Genie 대화 1만 2천 개 이상에서 기억할 만한 신호가 있는 3천 개 후보를 뽑아 만들었고, 최종 114문항 · 사용자 29명 · 지난 세션 2,233개예요. 에이전트는 Claude Opus 4.6, 기억 모델은 GPT 5.6 sol, 3회 평균이에요.
- 통과율: 기억 없음 22.3% → MemCurrent 68.4%(약 3배). 정답 기억만 넣은 상한선은 78.6%로, 그 차이의 80% 넘게 메웠다고 해요.
- 같은 시험의 Mem0는 43.9%였어요.
- 기억 없음 대비 1.35배 빠르고 1.44배 싸게(도입부 표현으로 토큰 31% 적게 · 26% 빠르게). MemCurrent는 문항당 평균 252초 · 418K 토큰이었어요.
공개 벤치마크(LoCoMo · LongMemEval · ConvoMem): 에이전트와 기억 모델 모두 GPT 5.6 luna, LangGraph · OpenAI Agents SDK 두 실행 환경과 3회 평균이에요. MemCurrent 평균 88.1%로, 지난 대화를 통째로 넣는 방식(87.8%)과 비슷한 점수를 질문당 입력 토큰 약 12배 적게(8.4K vs 103K) 냈어요. 대화 기록이 가장 긴 두 벤치마크에선 통째로 넣는 방식보다 오히려 높았다고 해요.
원문에 실린 두 사례(익명 처리된 Genie 세션)
- 반복 환각 막기: 저장된 쿼리 결과를 읽지 않고 표를 지어낸 에이전트가, 사용자 지적 뒤 그 교훈을 기억에 남겨 같은 실수가 습관이 되는 걸 막았어요.
- 비슷한 일 빨리 하기: 'SDP 상위 고객 5곳' 질문에 도구 호출 11번 · 하위 에이전트 8개 · 거의 6분이 걸렸는데, 그 과정을 작업 흐름 파일로 남긴 뒤 다른 질문(지난달 파이프라인 실행 5천 회 넘은 SDP 고객 수)은 도구 호출 2번 · 하위 에이전트 1개로 41초에 답했어요.
어디서 쓰나
Agent Bricks Memory(Lakebase 기반)에는 에피소드 기억용 세션 저장소, 파생 기억용 기억 저장소, 자동 드리밍 파이프라인, 기억 효과까지 보는 추적 · 평가, 그리고 예제 에이전트를 10분 안에 띄우는 CLI가 들어 있어요. Genie 사용자에겐 이미 뒤에서 동작하고 있다고 원문에 적혀 있어요. 원문과 문서에는 미리보기 · 정식 출시 같은 상태 표시는 따로 없었어요.