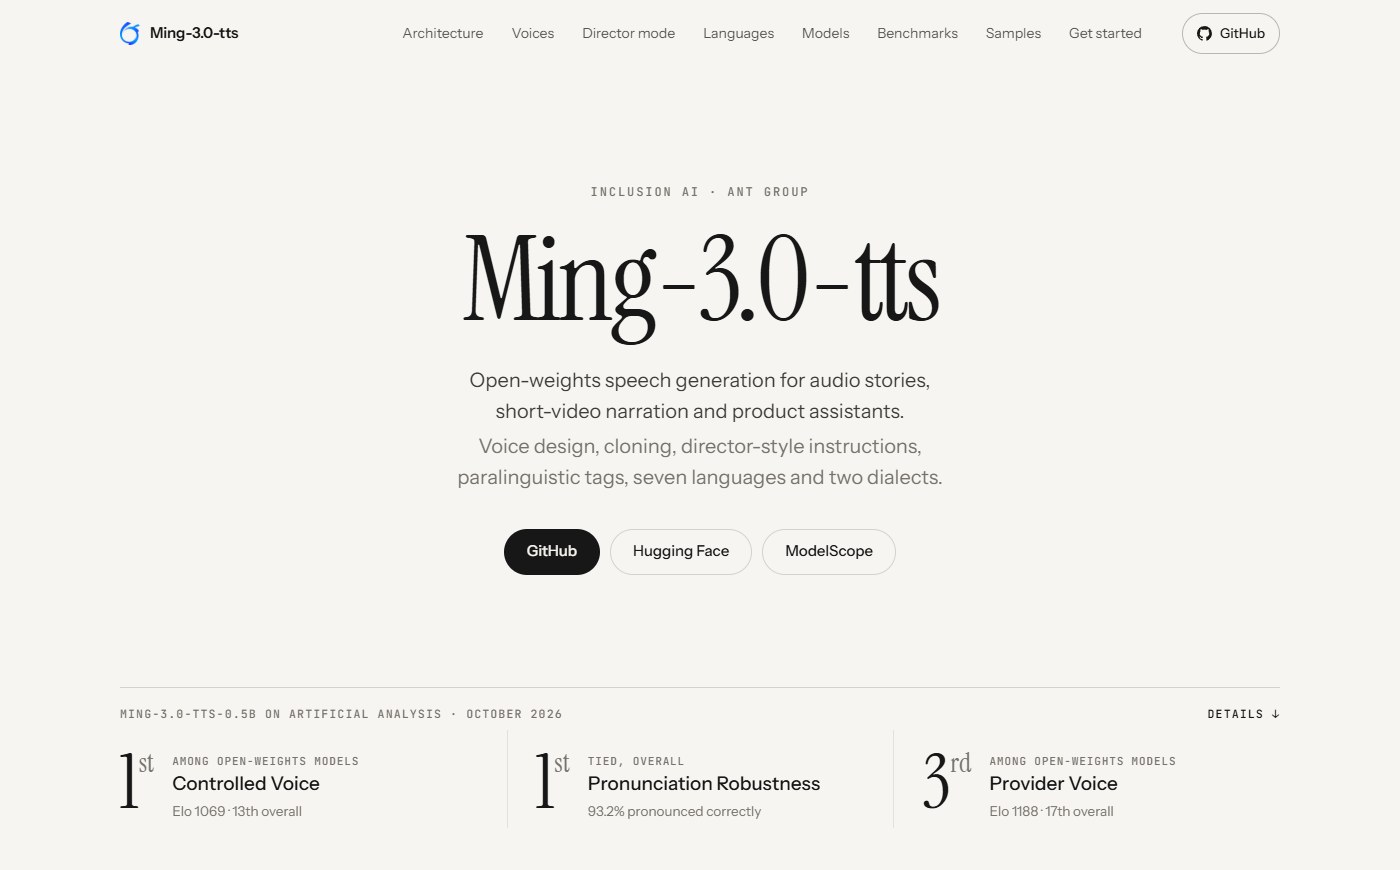
한국어도 되는 0.5B 오픈 음성 모델 Ming-3.0-tts — MIT 라이선스, 목소리 복제 · 감정 · 웃음 태그까지
앤트그룹(Ant Group)의 inclusionAI가 10월 Ming-3.0-tts를 공개했어요. 공식 페이지는 Artificial Analysis 발음 정확도 평가에서 93.2%로 '공동 1위'였다고 소개해요.
- inclusionAI(앤트그룹)가 10월 음성 합성 모델 Ming-3.0-tts를 MIT 라이선스로 공개했어요. 0.5b(밀집형 0.5B)와 tiny(MoE, 전체 7.9B · 활성 1.3B) 두 가지예요.
- 0.5b는 중국어 · 영어 · 독일어 · 스페인어 · 프랑스어 · 한국어 · 일본어 7개 언어와 사투리 2개를 지원하고, 짧은 참고 음성으로 목소리를 복제하거나 글로 목소리를 설계할 수 있어요.
- 공식 페이지 기준(Artificial Analysis, 2026년 10월) 0.5b는 발음 정확도 93.2%로 전체 공동 1위, Controlled Voice는 오픈 웨이트 모델 중 1위(Elo 1069 · 전체 13위)예요.
숏폼 내레이션을 한국어 · 영어 · 일본어로 나눠 만들 때, 내 목소리 참고 음성 하나로 같은 목소리의 언어별 버전을 시험해 볼 수 있어요. 공식 페이지도 '숏폼 영상 내레이션'을 쓰임새로 적었어요.
MIT 라이선스라 내 앱의 음성 안내 기능에 붙여 볼 수 있어요. 파이썬 API(MingTTS)와 명령줄(infer.py)이 둘 다 있어요. 다만 시험 환경이 NVIDIA H800 · H20 이라 내 GPU에서 도는지는 직접 확인해야 해요.
오디오북 · 상품 안내 음성처럼 감정 · 속도 · 높낮이를 맞춰야 하는 녹음을 사람 녹음 전에 시안으로 먼저 들어 볼 수 있어요.
설치 3단계(0.5b, README 그대로)
1. git clone https://github.com/inclusionAI/Ming-3.0-tts.git → cd Ming-3.0-tts → pip install -r requirements.txt
2. pip install "huggingface_hub[cli]" → hf download inclusionAI/Ming-3.0-tts-0.5b --local-dir Ming-3.0-tts-0.5b
3. README 의 빠른 시작(Quick start: 0.5b)에 있는 infer.py 예시에서 --text 와 --prompt_wav_path(내 참고 음성)만 바꿔 실행해요.
라이선스: MIT · 비용: 모델은 무료(내 GPU 필요, 시험 환경은 H800 · H20)
주의: 실제 사람 목소리를 동의 없이 흉내 내는 데 쓰지 말라고 모델 카드에 적혀 있어요.

한 사람 목소리로 숏폼 내레이션을 한국어 · 영어 · 일본어 버전으로 나눠 만드는 시험에 써 보면 좋을 것 같아요. 다만 화자 유사도는 아직 약하다고 모델 카드가 직접 밝혀서, 목소리가 얼마나 닮는지는 직접 들어 보고 정하는 게 좋을 것 같아요.
앤트그룹(Ant Group)의 inclusionAI가 2026년 10월 오픈 웨이트(가중치를 내려받아 직접 돌릴 수 있는) 음성 합성 모델 Ming-3.0-tts를 공개했어요. 공식 페이지는 쓰임새로 "오디오 스토리, 숏폼 영상 내레이션, 상품 안내 도우미"를 들었어요. 라이선스는 MIT예요.
두 가지 크기
- Ming-3.0-tts-0.5b: 밀집형(dense) 0.5B, Qwen2.5-0.5B 기반. 팟캐스트 생성을 뺀 모든 작업을 지원해요.
- Ming-3.0-tts-tiny: MoE(전문가 혼합) 구조로 전체 7.9B · 활성 1.3B, Ling V3 기반. 팟캐스트 생성까지 지원해요.
할 수 있는 것 (0.5b 모델 카드 기준)
- 짧은 참고 음성으로 목소리 복제(제로샷 보이스 클로닝)
- "어떤 목소리"를 글로 적어 목소리 설계(보이스 디자인)
- 말투 · 연기 방식을 자유롭게 지시하는 기능과 감정 · 속도 · 높낮이 · 크기 조절
- 숨소리 · 기침 · 한숨 · 웃음 등 문장 안에 넣는 소리 태그 14개(중국어 · 영어)
- 언어: 중국어 · 영어 · 독일어 · 스페인어 · 프랑스어 · 한국어 · 일본어, 사투리: 쓰촨어 · 광둥어. 출력은 44.1kHz예요.
- 기본 목소리: 중국어 100개 이상, 영어 5개
숫자로 보면
공식 페이지는 Artificial Analysis(2026년 10월) 결과를 이렇게 소개해요(모두 0.5b 기준).
- Pronunciation Robustness(발음 정확도): 93.2%를 맞게 발음해 전체 공동 1위. 줄임말 풀어 읽기(Expanding Shorthand) 96.5%, 숫자 · 기호 순서 그대로 읽기(Preserving Exact Sequences) 90.6%로 두 항목 1위.
- Controlled Voice: 오픈 웨이트 모델 중 1위, Elo 1069 · 전체 13위.
- Provider Voice: 오픈 웨이트 모델 중 3위, Elo 1188 · 전체 17위.
참고로 Artificial Analysis의 Controlled Voice 리더보드를 오늘 열어 보면 Ming-3.0-tts는 Elo 1068(±16), 순위 10~18위 구간으로 나와요. 아레나 점수는 투표가 쌓이며 조금씩 움직여요.
모델 카드의 자체 평가(0.5b)는 이래요.
- Seed-TTS 제로샷: 중국어 WER(단어 오류율) 0.800% · 영어 1.584%, 화자 유사도 0.758 · 0.691
- MiniMax 다국어 시험: 한국어 CER(글자 오류율) 1.728% · 화자 유사도 0.793, 독일어 WER 0.365%, 스페인어 1.099%, 프랑스어 4.264%, 일본어 CER 3.765%
- 감정 조절(CV3) 평균 72.33% — 같은 표의 CosyVoice3-0.5B는 66.33%
- 기본 속성(속도 · 크기 · 높낮이) 평균 93.30%, 그중 높낮이 86.00%
한계 (모델 카드가 직접 적은 것)
- 화자 유사도가 내용 정확도보다 뒤처지고, 다국어 중 프랑스어 유사도가 가장 약해요.
- 한 문장에 소리 태그가 여러 개면 하나일 때보다 덜 안정적이에요.
- 글 자체에 감정이 없으면 감정 조절이 더 어려워요.
- 높낮이는 속도 · 크기보다 덜 정확해요.
돌려 보려면
추론 코드는 GitHub 저장소에 있어요. 0.5b는 NVIDIA H800-80GB와 H20-96G(CUDA 12.4)에서 시험했다고 적혀 있고, flash-attn은 없어도 돼요. tiny는 따로 환경(Python 3.10.15, PyTorch 2.7.1)을 만들어야 하고 H800을 권해요. vLLM-Omni 가속 추론과 기술 보고서는 아직 '예정'이에요.