에이전트를 팀으로 돌리면 값은 1.8~5.1배… 점수가 뚜렷이 오른 것은 네 번 중 한 번뿐이었어요
Vals AI가 GPT 6 Sol과 Claude Opus 5.5에게 웹 앱 50개를 혼자서, 그리고 팀으로 만들게 해 봤어요. 팀은 값이 1.8~5.1배 들었고, 통계적으로 뚜렷한 점수 차이는 Sol의 중간 추론 강도에서 나온 7.3점 하나였어요.
- AI 모델 평가 회사 Vals AI가 10월 9일(현지 시간) 시험 결과를 공개했어요. GPT 6 Sol과 Claude Opus 5.5가 Vibe Code Bench의 웹 앱 50개를 '에이전트 하나'와 '팀'으로 각각 만들었고, 추론 강도는 중간(medium)과 최대(max) 두 가지였어요.
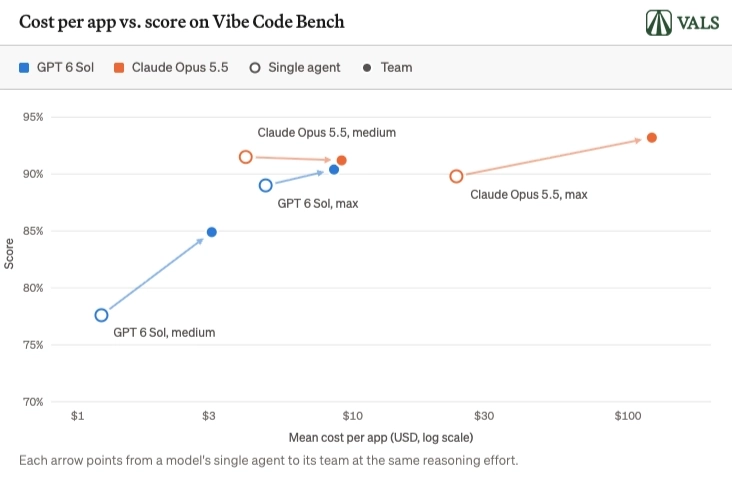
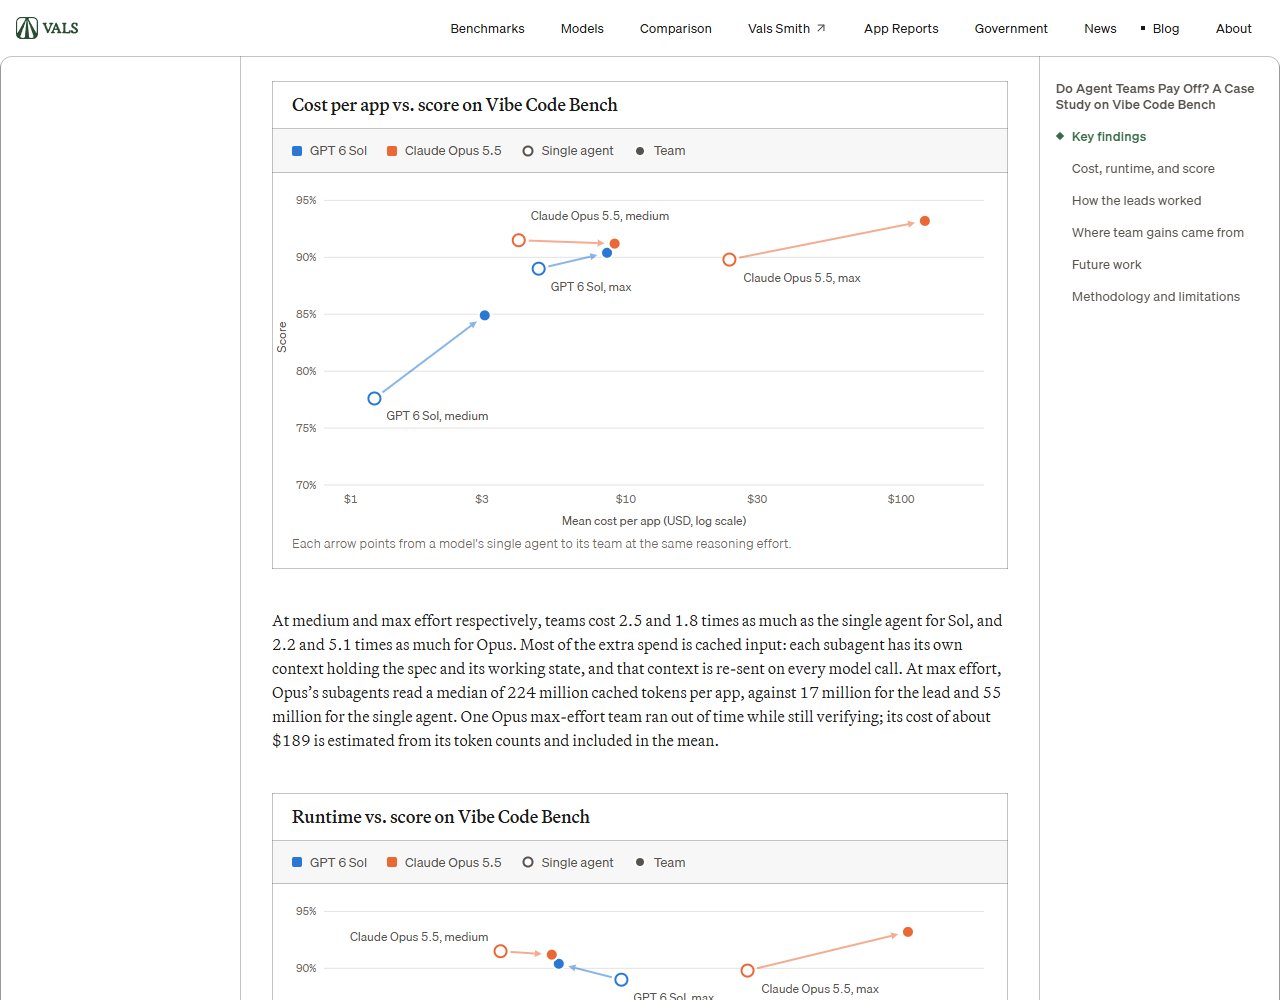
- 팀은 에이전트 하나보다 값이 1.8~5.1배 들었어요. Sol은 중간 2.5배·최대 1.8배, Opus는 중간 2.2배·최대 5.1배예요.
- 네 번의 비교 가운데 통계적으로 뚜렷한 차이는 하나였어요. Sol 중간 강도 팀이 77.6% → 84.9%로 7.3점 올랐고(p = 0.005), 나머지 셋은 −0.3 ~ +3.4점으로 뚜렷하지 않았어요.
코딩 에이전트의 서브에이전트·팀 기능을 켜기 전에, 같은 작업을 '혼자'와 '팀'으로 한 번씩 돌려 값과 결과를 나란히 적어 보세요. 이 시험에서 추가 비용의 대부분은 서브에이전트마다 명세와 작업 상태를 다시 읽는 캐시 입력 토큰이었어요.
'에이전트 여러 개가 동시에 일한다'는 설명이 곧 더 좋은 결과라는 뜻은 아니에요. 외주나 도구를 고를 때 팀 방식이면 비용이 몇 배가 될 수 있다는 점을 견적 단계에서 물어볼 만해요.
직접 쓸 일은 적어요. 다만 에이전트 기능이 든 서비스를 쓸 때 사용량이 빨리 닳는다면, 여러 에이전트를 한꺼번에 돌리는 설정이 켜져 있는지 확인해 볼 만해요.
내 작업으로 해 보는 비교
1) 평소 맡기는 작업 하나를 고르기 (예: 작은 웹 앱 하나 만들기)
2) 에이전트 하나로 한 번, 팀(서브에이전트) 설정으로 한 번 돌리기
3) 든 값·걸린 시간·결과물이 통과한 테스트 수를 표로 적기
4) 팀이 값만 오르고 결과가 비슷하면, 팀 대신 추론 강도를 올리는 쪽도 같이 비교하기
직접 만든 자동화 도구를 에이전트로 고치는 분이라면, 팀 기능을 기본으로 켜 두기보다 큰 작업 하나로 값과 결과를 먼저 재 보면 좋을 것 같아요. 웹 앱 한 종류의 시험이라 다른 작업에서는 결과가 다를 수 있다는 점도 같이 봐야 해요.
AI 모델 평가 회사 Vals AI가 10월 9일(현지 시간), '에이전트를 팀으로 묶으면 값을 하는가'를 직접 재 본 결과를 공개했어요. OpenAI와 Anthropic이 둘 다 이끄는 에이전트가 서브에이전트(일을 나눠 받는 보조 에이전트)를 만들어 일을 맡기는 기능을 내놓았는데, 그게 무엇을 얻고 얼마가 드는지 본 것이에요.
X 게시물 보기 · https://x.com/ValsAI/status/2108608719420600709
어떻게 시험했나요
시험대는 Vals AI의 Vibe Code Bench예요. 제품 명세만 보고 웹 앱을 통째로 만드는 과제이고, 브라우저 에이전트가 화면을 눌러 보며 채점해요. GPT 6 Sol과 Claude Opus 5.5가 앱 50개를 각각 에이전트 하나로, 그리고 팀으로 만들었어요. 추론 강도는 중간(medium)과 최대(max) 두 가지예요. 팀에서는 이끄는 에이전트가 서브에이전트를 한 번에 최대 5개까지 쓸 수 있었어요. 여덟 가지 설정을 각각 한 번씩 돌렸어요.
결과 표
- GPT 6 Sol · 중간: 혼자 77.6% · $1.22 · 12.4분 → 팀 84.9% · $3.07 · 11.9분
- GPT 6 Sol · 최대: 혼자 89% · $4.82 · 38.4분 → 팀 90.4% · $8.54 · 27.6분
- Claude Opus 5.5 · 중간: 혼자 91.5% · $4.08 · 20.3분 → 팀 91.2% · $9.10 · 26.6분
- Claude Opus 5.5 · 최대: 혼자 89.8% · $23.77 · 74.7분 → 팀 93.2% · $122 · 174.1분
점수는 앱의 화면 테스트 통과 비율, 값은 앱 하나 평균, 시간은 중앙값이에요.
무엇이 보였나요
팀은 값이 1.8~5.1배 들었어요. 그런데 통계적으로 뚜렷한 점수 차이는 Sol 중간 강도의 7.3점(p = 0.005) 하나였고, 나머지 셋(−0.3 ~ +3.4점)은 뚜렷하지 않았어요. 추가 비용의 대부분은 캐시 입력 토큰이에요. 서브에이전트마다 명세와 작업 상태를 담은 자기 맥락이 있고, 모델을 부를 때마다 그것을 다시 보내기 때문이라고 해요.
Sol은 팀보다 추론 강도를 올리는 쪽이 점수를 더 올렸어요(혼자 중간 → 최대 11.4점). 대신 최대 강도 혼자는 중간 강도 팀보다 값이 1.6배($4.82 대 $3.07), 시간은 3배였어요. Opus는 강도를 올려도, 팀으로 돌려도 뚜렷한 차이가 없었어요.
시간은 갈렸어요. Sol 팀은 더 빨리 끝났고, Opus 팀은 최대 강도에서 혼자보다 최대 2.3배 오래 걸렸어요.
Vals AI는 이 결과가 웹 앱을 만드는 벤치마크 하나에서 나온 것이라 다른 종류의 일에는 그대로 들어맞지 않을 수 있다고 밝혔어요.