PostgreSQL 안에서 '뜻으로 찾기'까지… 벡터 DB도 GPU도 없이 도는 오픈소스 확장 Evoke 공개
Intelligent Internet이 10월 8일 PostgreSQL 확장 Evoke를 Apache-2.0으로 공개했어요. 키워드 검색과 뜻 검색을 색인 하나에 담고, 약 3,030만 파라미터짜리 작은 모델이 데이터베이스 안 CPU에서 돌아요. 지금은 Beta 1이고 영어 글에 맞아요.
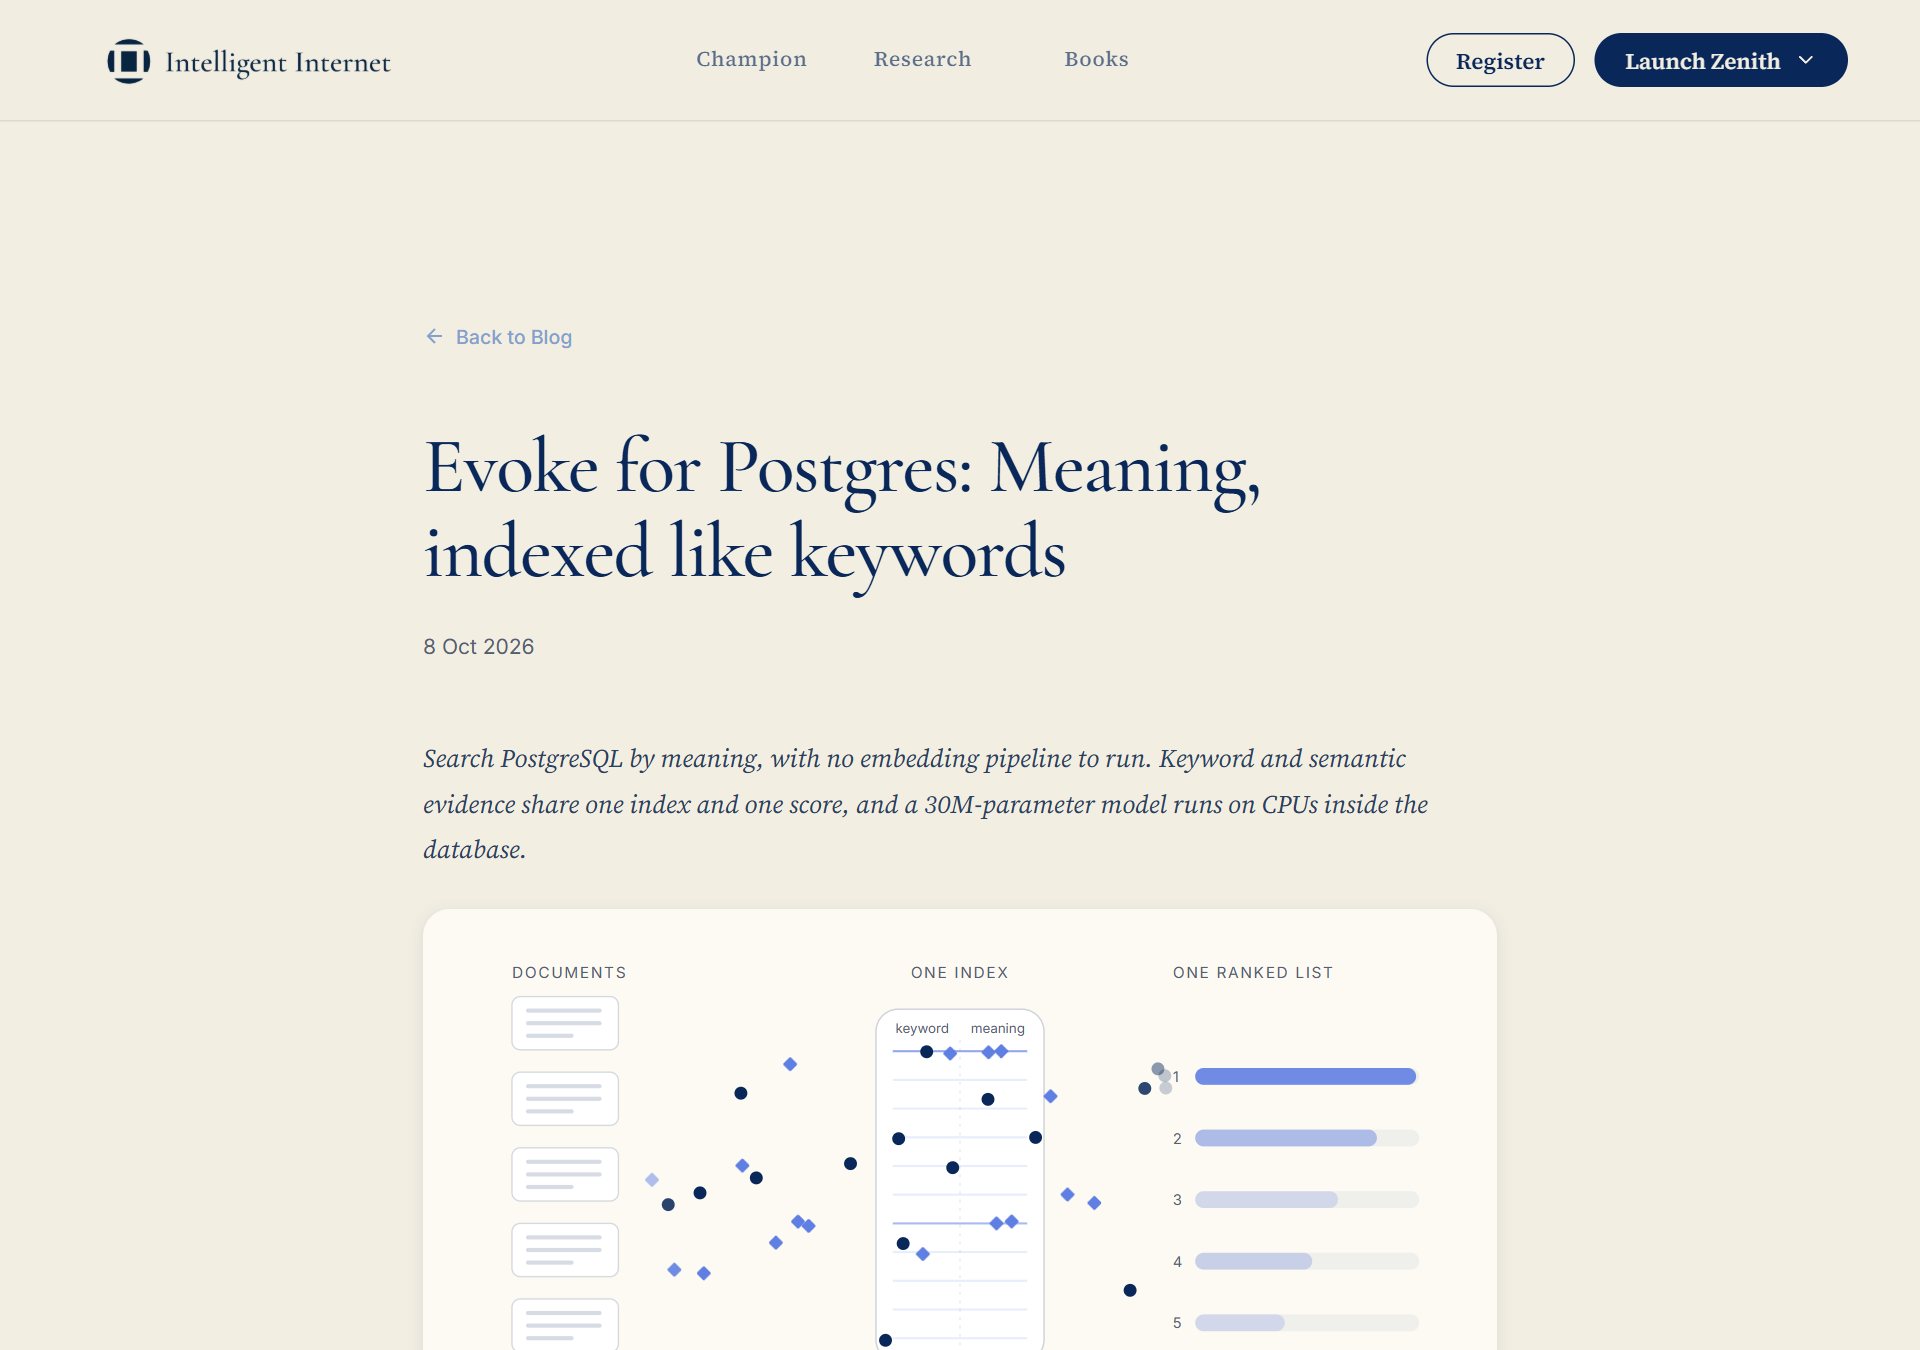
- Evoke는 PostgreSQL에 뜻으로 찾는 검색을 더하는 확장이에요. 보통은 임베딩 모델 호출, 벡터 색인, 두 결과 합치기가 따로 필요한데, 이것을 색인 하나와 데이터베이스 안에서 도는 작은 모델로 바꿨어요.
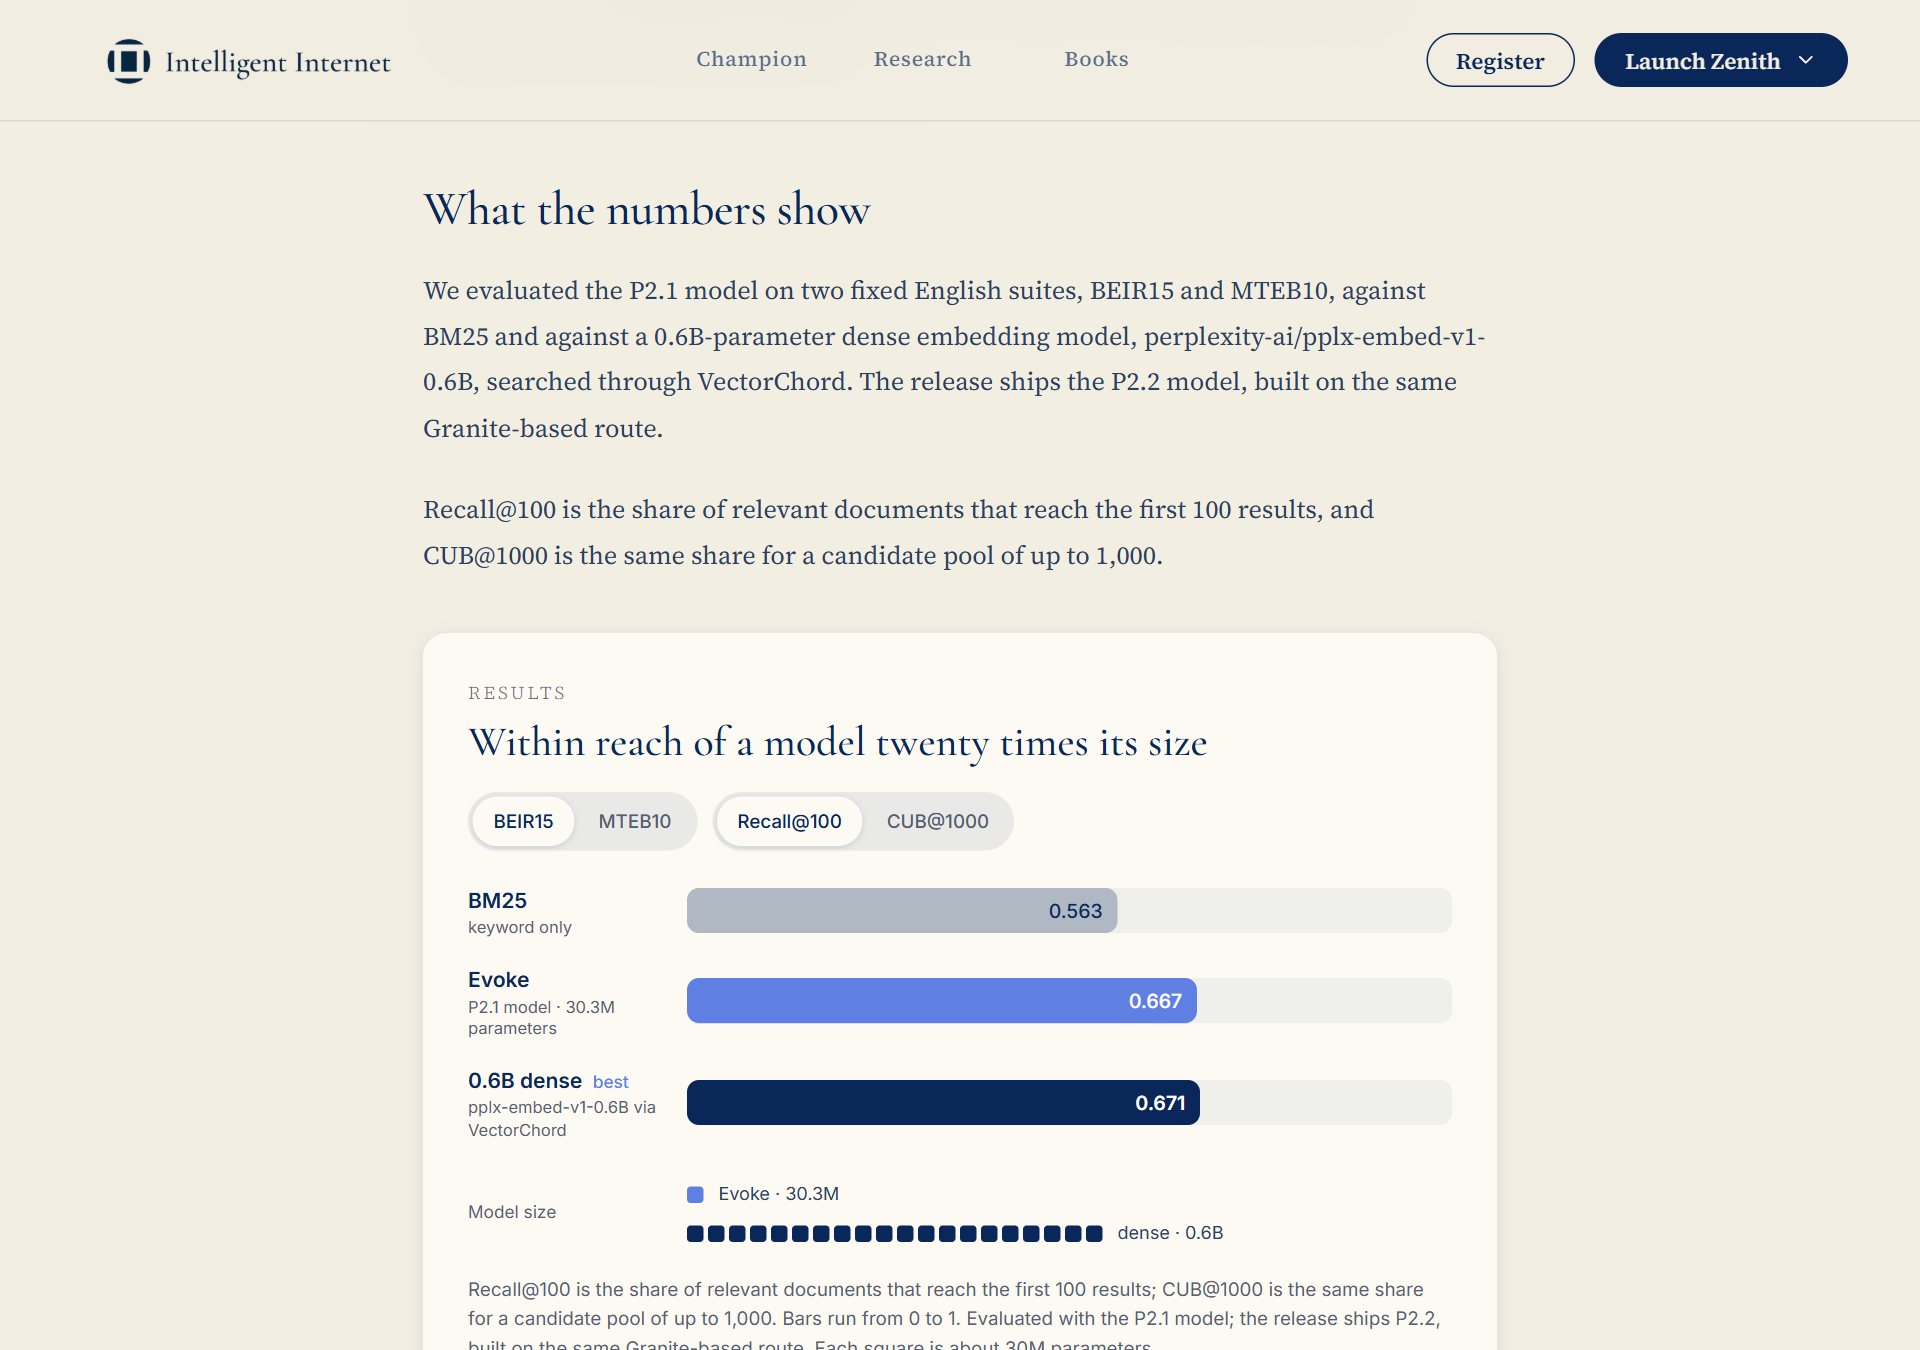
- 회사 발표로는 키워드 검색(BM25)만 쓸 때보다 상위 100개 안에 정답 문서가 들어오는 비율(Recall@100)이 BEIR15에서 0.563 → 0.667, MTEB10에서 0.595 → 0.703으로 올랐어요. 약 20배 큰 6억 파라미터 모델과는 0.004 이내 차이라고 해요.
- 코드와 모델 모두 Apache-2.0이고 GPU가 필요 없어요. 다만 Beta 1이고, 영어 글에 맞으며, 공식 패키지는 리눅스 x86-64의 PostgreSQL 17·18용이에요.
이미 PostgreSQL에 문서를 넣어 두고 키워드 검색만 쓰는 사내 문서 검색·RAG(문서를 찾아서 답하는 방식)라면, 벡터 DB를 새로 붙이기 전에 시험용 컨테이너에서 같은 질문 20개로 결과를 비교해 볼 만해요. 글이 데이터베이스 밖으로 나가지 않아서 외부 임베딩 API를 쓰기 어려운 자료에도 맞아요. 한국어 자료는 원문이 영어 글에 맞다고 적었으니 기대를 낮추고 시험해야 해요.
직접 설치할 일은 없어요. 다만 '문서 검색 챗봇'을 맡길 때 벡터 DB를 꼭 따로 둬야 하는지 물어볼 근거가 하나 생겼어요.
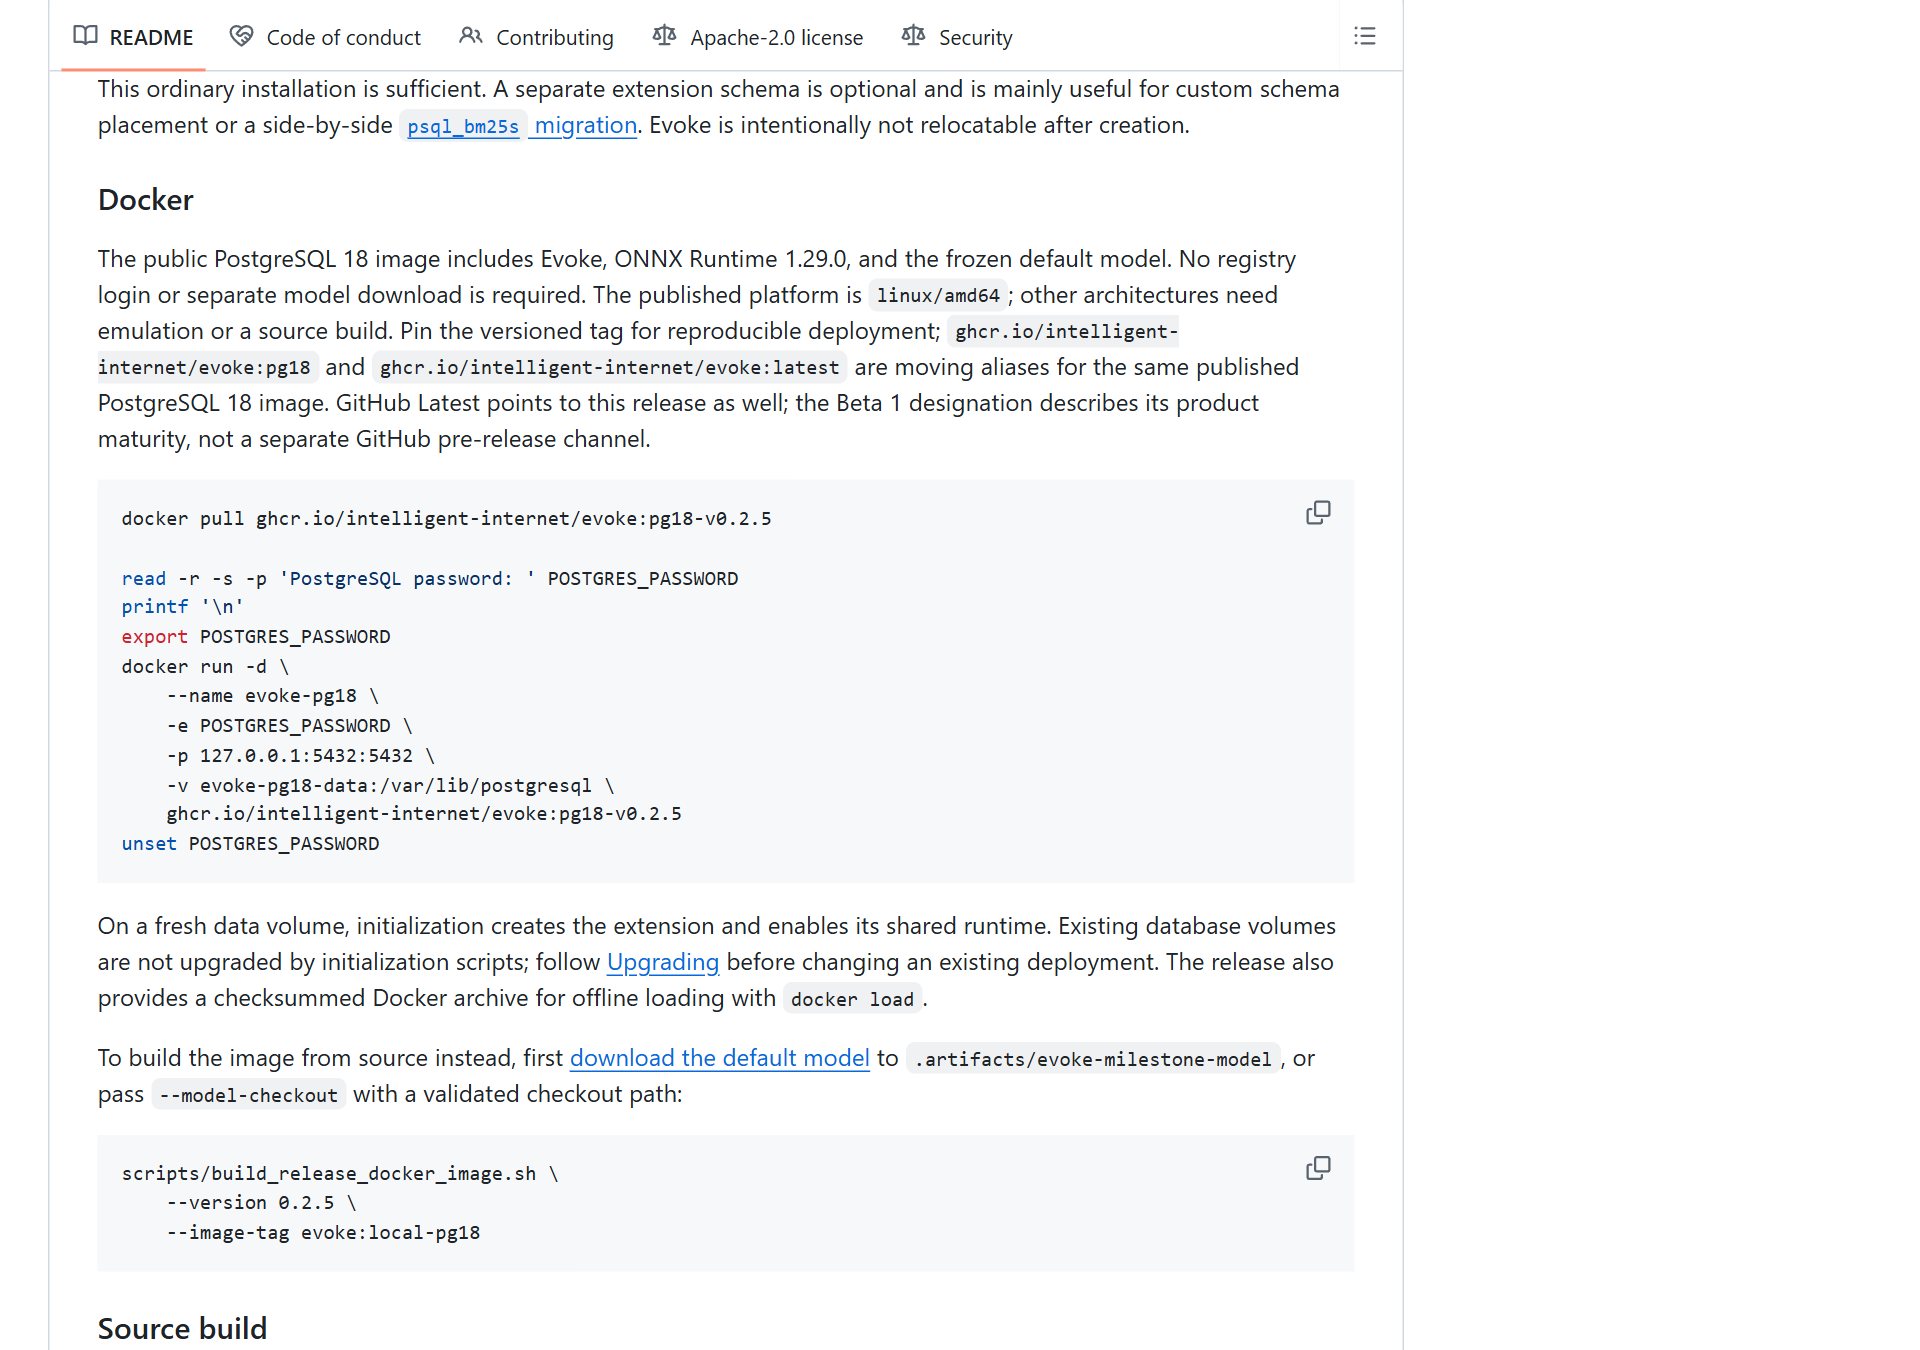
설치 3단계 (GitHub 설명서 기준, 리눅스 x86-64 · Docker)
1) docker pull ghcr.io/intelligent-internet/evoke:pg18-v0.2.5
2) 설명서의 docker run 명령으로 컨테이너 띄우기 (새 데이터 볼륨이면 확장이 자동으로 만들어져요)
3) 설명서대로 USING evoke 로 색인을 만들고(뜻 검색은 sae = true 옵션으로 켜요 — 정확한 문장은 GitHub 설명서를 따라 주세요) evoke_query('docs_body_idx'::regclass, '찾을 말', 10) 으로 찾기

라이선스: Apache-2.0 (코드·모델 모두)
비용: 무료. GPU 불필요, CPU에서 돌아요
주의: 블로그 글의 예시는 ii42 이름(USING ii42, ii42_query)을 쓰고 GitHub 설명서는 evoke 이름을 써요. v0.2.5 릴리스 노트는 이름을 Evoke로 바꿨다고 적었으니 설명서 쪽을 먼저 보세요
PostgreSQL에 쌓아 둔 영어 문서를 키워드로만 찾고 있는 분이라면, 시험용 컨테이너에서 뜻 검색을 켜고 평소 못 찾던 질문 몇 개를 넣어 보면 좋을 것 같아요. 아직 Beta 1이라 실제 서비스에 넣는 것은 조금 더 지켜보는 편이 나아 보여요.
Intelligent Internet이 10월 8일 PostgreSQL 확장 Evoke를 공개했어요. PostgreSQL(많이 쓰는 오픈소스 데이터베이스) 안에서 낱말이 달라도 뜻이 같은 글을 찾아 주는 검색을, 따로 붙이는 장치 없이 하게 해 주는 도구예요. 코드와 모델 모두 Apache-2.0 라이선스예요.
X 게시물 보기 · https://x.com/ii_posts/status/2108187526557012370
무엇을 줄였나
키워드 검색(BM25, 낱말이 얼마나 맞는지로 점수를 매기는 방식)은 제품 코드·사건 번호·오류 문구처럼 글자 그대로 찾는 일에 강해요. 대신 같은 말을 다른 낱말로 쓴 문서는 놓쳐요. 그래서 보통은 뜻 검색을 따로 붙여요. 임베딩 모델(글을 숫자 묶음으로 바꾸는 모델)을 부르고, 벡터 색인을 하나 더 두고, 두 결과 목록을 합치는 식이에요.
Evoke는 글을 '무게가 붙은 낱말들'로 바꾸는 방식을 써요. 이때 글에 없던 관련 낱말도 함께 들어가요. 이 낱말들이 키워드 색인과 같은 색인에 들어가서, 검색할 때 문서마다 점수가 하나만 나와요. 원문은 흔한 구성이 다섯 단계·색인 둘·합치기 한 번인 데 비해 Evoke는 세 단계·색인 하나·합치기 없음이라고 비교했어요.
모델은 IBM의 Granite-Embedding-30M-Sparse를 바탕으로 한 약 3,030만 파라미터 크기예요. 공식 패키지와 Docker 이미지에 함께 들어 있고, 데이터베이스 안의 CPU에서 돌아요. 원문은 GPU가 필요 없고 글이 데이터베이스 밖으로 나가지 않는다고 적었어요. 행을 넣거나 고치면 키워드 쪽은 바로 저장되고, 뜻 쪽은 뒤에서 따로 처리돼서 쓰기가 모델을 기다리지 않아요.
회사가 밝힌 숫자
Intelligent Internet은 영어 시험 묶음 두 개(BEIR15, MTEB10)로 키워드 검색(BM25), 그리고 6억 파라미터 임베딩 모델(pplx-embed-v1-0.6B)과 비교했어요. Recall@100은 정답 문서 가운데 상위 100개 안에 들어온 비율이에요.
- BEIR15 Recall@100 — 키워드만 0.563 → Evoke 0.667
- MTEB10 Recall@100 — 키워드만 0.595 → Evoke 0.703
- 큰 모델과 비교 — 파라미터가 약 20배인 모델과 상위 100개 기준 0.004 이내로 같았고, 상위 1,000개 안에는 정답 문서를 더 많이 넣었다고 해요.
알아 둘 점이 있어요. 이 숫자는 P2.1 모델로 잰 것이고, 배포판에는 같은 계열의 P2.2 모델이 들어 있어요. 모두 회사가 직접 잰 결과예요.
맞는 곳과 조건
원문은 Evoke가 PostgreSQL에 있는 영어 글에 맞다고 적었어요. 이미 PostgreSQL에서 키워드로 찾고 있고 벡터 구성을 새로 만들고 싶지 않은 팀, 글이 서버 밖으로 나가면 안 되는 환경(인터넷과 끊긴 곳 포함)을 예로 들어요. 좋은 첫 과제로는 사내 문서·규정 검색, 진료 지침·판례·규정집 같은 공개 자료 검색을 꼽았어요.
지금 버전은 v0.2.5(Beta 1)예요. 공식 패키지는 리눅스 x86-64의 PostgreSQL 17·18용이고, Docker 이미지는 PostgreSQL 18용이에요.
이름에 주의할 점이 하나 있어요. 블로그 글의 예시 코드는 ii42라는 이름(USING ii42, ii42_query)을 쓰는데, GitHub 설명서는 evoke라는 이름(USING evoke, evoke_query)을 써요. v0.2.5 릴리스 노트에는 패키지·확장·SQL 예시가 이제 Evoke 이름을 쓴다고 적혀 있어요.