AI 모델의 '말투'를 재는 평가가 나왔어요 — Artificial Analysis, 성격 특성 30개 · 지표 8개로 37개 모델 비교
벤치마크 사이트 Artificial Analysis가 10월 19일 AA-PersonalityBench를 공개했어요. 답이 맞는지가 아니라, 모델이 시스템 프롬프트 없이 기본으로 어떻게 쓰는지(따뜻함 · 단호함 · 정리 방식 · 길이)를 재요.
- Artificial Analysis가 10월 19일 AI 모델의 성격과 말투를 재는 AA-PersonalityBench를 공개했어요. 성격 특성 30개를 지표(index) 8개로 묶고, 길이 · 구조 · 문장부호 · 강조 같은 소통 특징 21개를 따로 세요.
- 질문은 특성마다 30개씩 모두 900개이고, 시스템 프롬프트 없이 답하게 해요. 두 답을 나란히 놓고 LLM 심사 모델이 모델 이름을 모른 채 어느 쪽이 그 특성을 더 강하게 보이는지 골라요.
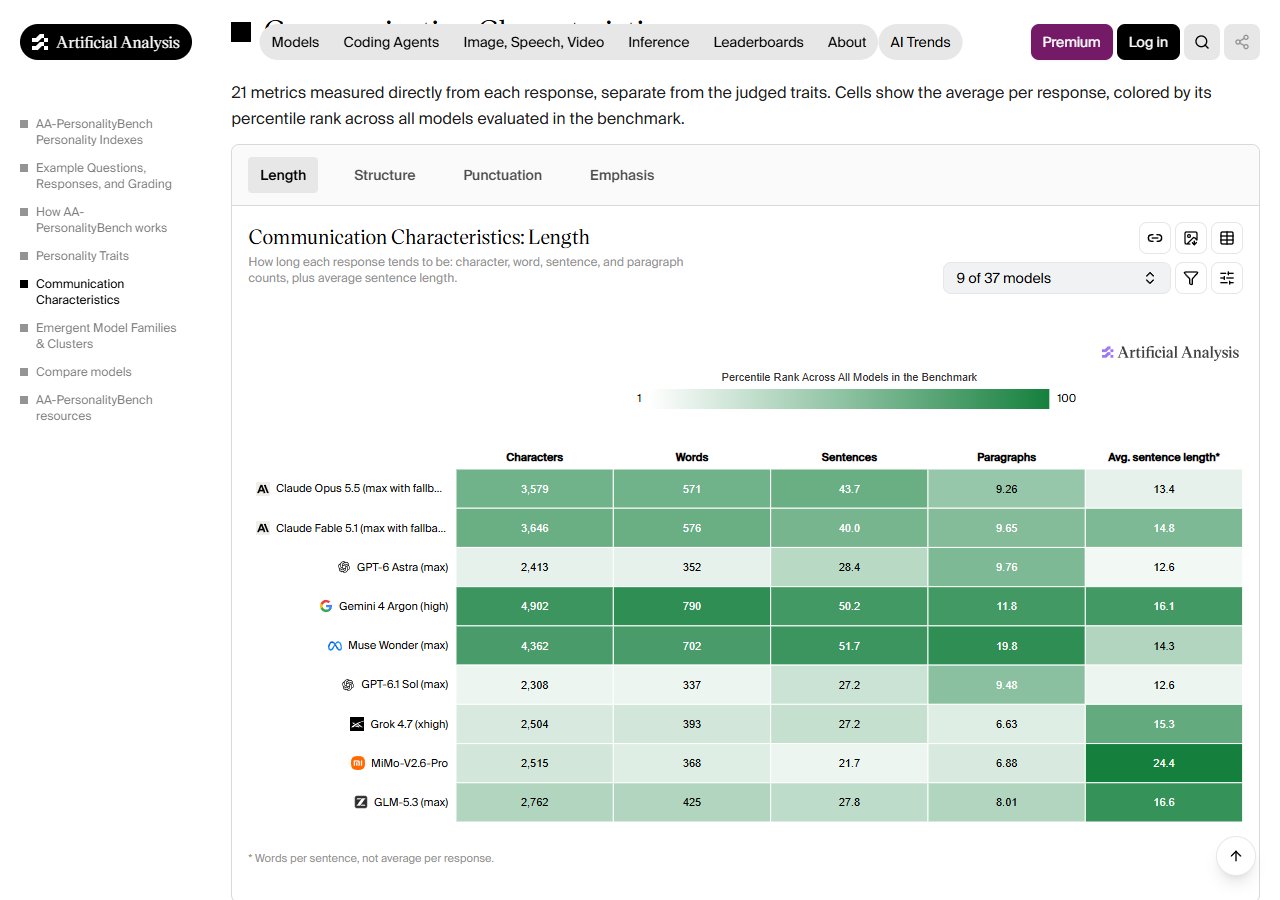
- 점수는 '좋다 · 나쁘다'가 아니라 '얼마나 강하게 드러나나'예요. 원문 차트 기준 답 하나당 평균 단어 수는 Gemini 4 Argon(high) 790, Claude Opus 5.5 571, GPT-6.1 Sol(max) 337로 차이가 컸어요.
블로그 초안이나 캡션을 AI로 쓰는데 글이 늘 길고 굵은 글씨 · 목록투성이라면, 원문의 소통 특징 표(길이 · 구조 · 강조 탭)에서 쓰는 모델의 평균 단어 수 · 목록 수 · 굵은 글씨 수를 보고 다른 모델과 비교해 볼 수 있어요.
챗봇이나 고객 응대 기능에 넣을 모델을 고를 때, 정답률 표 옆에 이 평가의 Warmth(따뜻함) · Conviction(단호함) · Transparency(투명성) 지표를 같이 놓고 서비스 말투에 맞는 후보를 좁혀 볼 수 있어요.
원문 결과 페이지의 'Compare models'에서 두 모델을 골라 같은 특성을 나란히 볼 수 있어요. 공개된 예시 질문 5개와 각 모델의 실제 답도 함께 볼 수 있어요.
1. 원문 결과 페이지(artificialanalysis.ai/evaluations/aa-personalitybench)를 열어요.
2. 차트의 모델 선택(예: 9 of 37 models)에서 내가 쓰는 모델과 바꿔 볼 후보를 골라요.
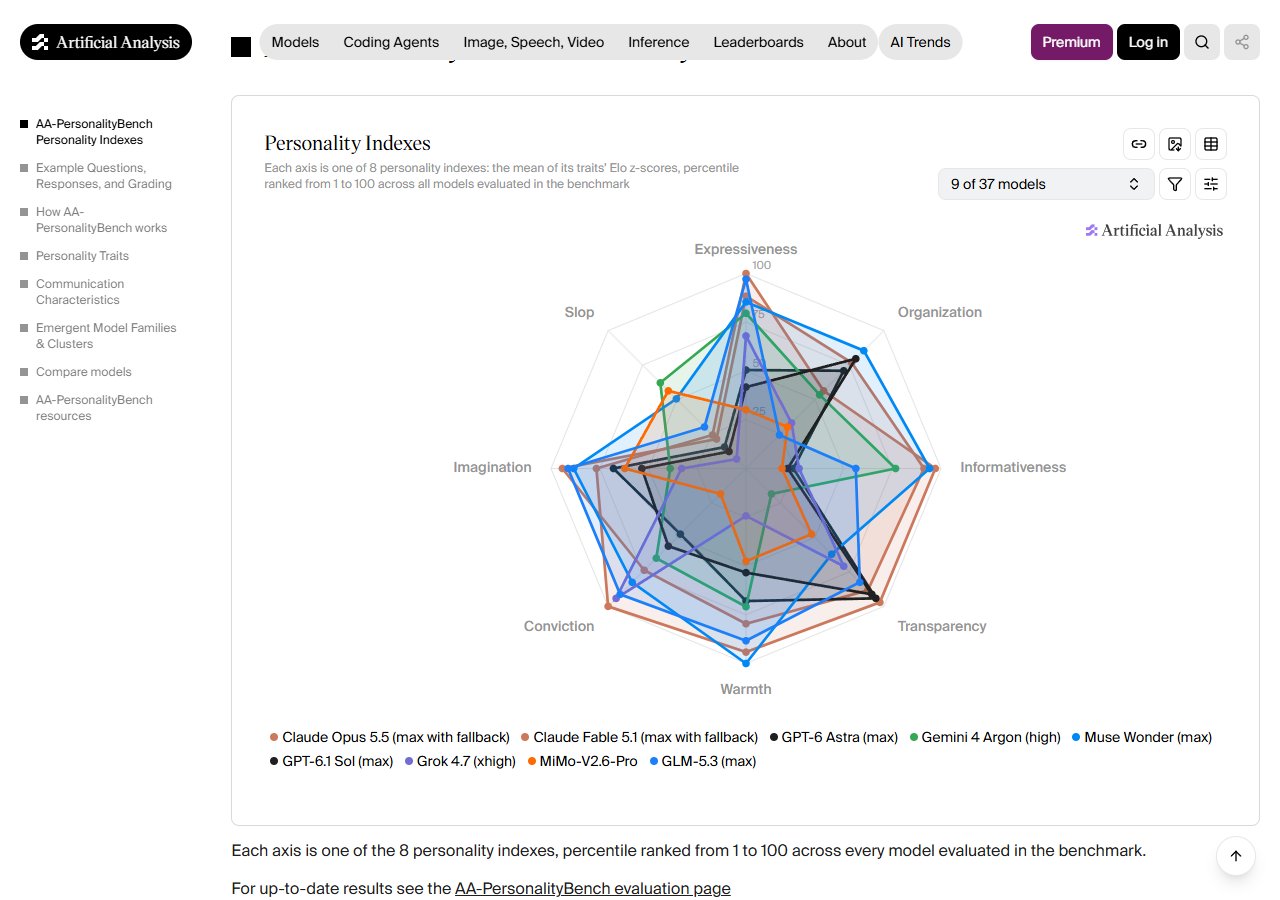
3. Personality Indexes 차트로 8개 지표 모양을 비교하고, Communication Characteristics 표에서 길이 · 구조 · 강조 숫자를 봐요.
4. 후보 두 모델에 내 실제 작업 질문 몇 개를 시스템 프롬프트 없이 넣어 보고, 표의 숫자와 느낌이 맞는지 직접 확인해요.

AI로 글 초안을 쓰는데 매번 "짧게, 목록 빼고"를 붙이고 있다면, 이 표에서 기본 말투가 원래 짧은 모델을 먼저 찾아보면 좋을 것 같아요. 다만 시스템 프롬프트 없는 기본값을 잰 것이라, 지시를 주면 달라질 수 있다는 점은 같이 봐야 할 것 같아요.
벤치마크 사이트 Artificial Analysis가 10월 19일 AA-PersonalityBench를 공개했어요. 원문은 "두 모델이 똑같이 맞는 답을 해도 쓰는 느낌은 아주 다를 수 있다"며, 이 차이를 재려고 만들었다고 설명했어요. 시스템 프롬프트(모델에게 미리 주는 기본 지시) 없이 모델이 기본으로 어떻게 쓰는지를 재요.
무엇을 재나요
- 성격 특성 30개를 지표 8개로 묶어요: Expressiveness(표현력) · Organization(정리) · Informativeness(정보량) · Transparency(투명성) · Warmth(따뜻함) · Conviction(단호함) · Imagination(상상력) · Slop(뻔하고 부풀린 글).
- 예를 들어 Warmth에는 Friendly · Humorous · Sincere · Emotionally Intelligent가, Conviction에는 Direct · Confident · Opinionated · Constructive Pushback이 들어가요. Transparency에선 Sycophantic(비위 맞추기)을 거꾸로 셈해요.
- 이와 따로 소통 특징 21개를 프로그램으로 세요. 길이(글자 · 단어 · 문장 · 문단 수 등), 구조(목록 · 제목 · 표), 문장부호(엠 대시 · 느낌표 · 콜론 등), 강조(굵은 글씨 · 기울임 · 이모지 등)예요.
어떻게 재나요
- 질문은 특성마다 30개씩 모두 900개예요. 오염을 막으려고 전체 질문은 비공개이고, 특성마다 예시 질문 2개만 공개했어요.
- 같은 질문에 대한 두 모델의 답을 LLM 심사 모델 하나가 비교해 A · B · 무승부를 골라요. 심사 모델은 모델 이름과 추론 과정을 보지 못하고, 답 순서는 무작위로 섞어요. 방법론 페이지에 적힌 심사 모델은 Gemini 3.8 Flash(high) · Claude Sonnet 5.5(medium) · GLM 5.3 Flash(max)예요.
- 결과는 기준 모델 GPT-6.1 Sol(max)을 1000으로 둔 Elo 점수이고, 1~100 백분위로 보여 줘요. 95% 신뢰구간도 함께 내요.
- 원문은 점수가 '좋다 · 나쁘다'가 아니라 그 특성이 얼마나 강하게 드러나는지를 뜻한다고 적었어요.
원문에 실린 결과 몇 가지
- 답 길이(답 하나당 평균 단어 수, 원문 차트에 보인 9개 모델 기준): Gemini 4 Argon(high) 790, Muse Wonder(max) 702, Claude Fable 5.1 576, Claude Opus 5.5 571, GPT-6 Astra(max) 352, GPT-6.1 Sol(max) 337.
- 콜론 수(답 하나당 평균, 원문 예시 5개 모델 기준): Gemini 4 Argon 14.5, Claude Opus 5.5 7.4, Claude Fable 5.1 7.1, Claude Sonnet 5.5 5.4, GPT-6 Astra 5.2.
- Claude Opus 5.5 vs Claude Sonnet 5.5(표현력 특성에서 Opus가 더 강하다고 판정될 확률): Lexically Varied(어휘 다양성) 83%, Eloquent 77%, Natural Sounding 73%, Metaphorical 69%, Literate 61%.
- 30개 특성 점수의 상관관계로 모델을 묶은 '성격 가족' 나무 그림도 실었어요. 상관관계가 높을수록 가까이 묶여요.
참고: 평가한 모델 수는 원문 차트에 '37개 모델'로 적혀 있고, 성격 가족 그림만 '36개 중 24개'로 적혀 있어요. 최신 결과는 Artificial Analysis 결과 페이지에서 볼 수 있어요.