AI 성우에게 "눈물 참으면서 웃어 줘"라고 적으면 그대로 읽어요 — Fish Audio Drama 3
Fish Audio가 글로 연기를 지시하는 음성 합성 모델 Drama 3(미리보기)를 내놨어요. 대사 사이에 [한숨], 단어에 <속삭임>을 적어 넣고, 한 글에 16명까지 목소리를 나눠요. 350억 파라미터 가중치도 허깅페이스에 올라와 있어요.
- Drama 3는 대사 앞에 [따뜻하고 편하게, 오랜 친구에게 말하듯]처럼 연기 지시를 글로 적으면 그 느낌으로 읽는 TTS(글을 목소리로 바꾸는 모델)예요. 지금은 미리보기(Preview) 단계예요.
- [한숨] · [웃음] 같은 소리를 원하는 자리에 넣고, 고른 단어에만 속삭임 · 강조 · 빠르게 · 느리게를 걸 수 있어요. 지시문은 영어가 아닌 자기 말로 써도 되고, 모델 카드의 지원 언어 83개에 한국어가 들어 있어요.
- 가중치(모델 파일)가 허깅페이스에 공개돼 있어요. 350억 파라미터 가운데 토큰마다 30억만 켜지는 구조이고, 라이선스는 Fish Audio Community License라 연 매출 50만 달러 미만일 때만 상업 이용이 돼요.
숏폼 내레이션에서 한 문장만 톤이 어색할 때, 그 줄 앞에 [담담하게] 같은 지시를 적어 다시 뽑아 볼 수 있어요. 두 사람이 주고받는 장면은 화자별 목소리를 정해 한 번에 뽑아요.
API 요청 머리말에 model: drama-3 을 넣어 불러요. 직접 돌리려면 SGLang-Omni로 띄우는 방법이 모델 카드에 있어요(sgl-omni serve --model-path fishaudio/drama-3).
제품 소개 영상이나 오디오북 낭독을 외주 없이 만들 때, 대본에 Auto Tag를 돌려 연기 지시 초안을 받고 마음에 안 드는 줄만 고쳐요.
바로 해 보기 (웹)
1) fish.audio/drama-3 에서 'Try Drama 3 for free'로 들어가기
2) 대사 한 줄을 지시 없이 먼저 듣기 → 같은 줄 앞에 [지친 목소리로, 혼잣말하듯]을 붙여 다시 듣기
3) 한 단어만 골라 <whisper>…</whisper>로 감싸 보고, 문장 사이에 [sigh]나 [pause] 넣어 보기
4) 대본이 길면 Auto Tag로 지시 초안을 받고 어색한 줄만 고치기
직접 돌리기: git clone https://github.com/sgl-project/sglang-omni.git → uv pip install --prerelease=allow -v -e ".[fishaudio]" → sgl-omni serve --model-path fishaudio/drama-3 --port 8000
라이선스: Fish Audio Community License 1.0 (연구 · 비상업 무료, 상업은 연 매출 50만 달러 미만일 때만, 남에게 음성 합성 서비스를 여는 것은 따로 계약)
비용: 웹은 무료 등급 월 8,000크레딧(최대 7분) · 직접 돌리면 모델 값은 없고 GPU 값만
캐릭터 영상 대사나 숏폼 내레이션에서 감정이 안 맞는 한 줄만 다시 뽑을 때 써 보면 좋을 것 같아요. 한국어 연기가 얼마나 자연스러운지는 같은 대사를 지시만 바꿔 서너 번 들어 본 뒤에 판단하는 편이 좋아 보여요.
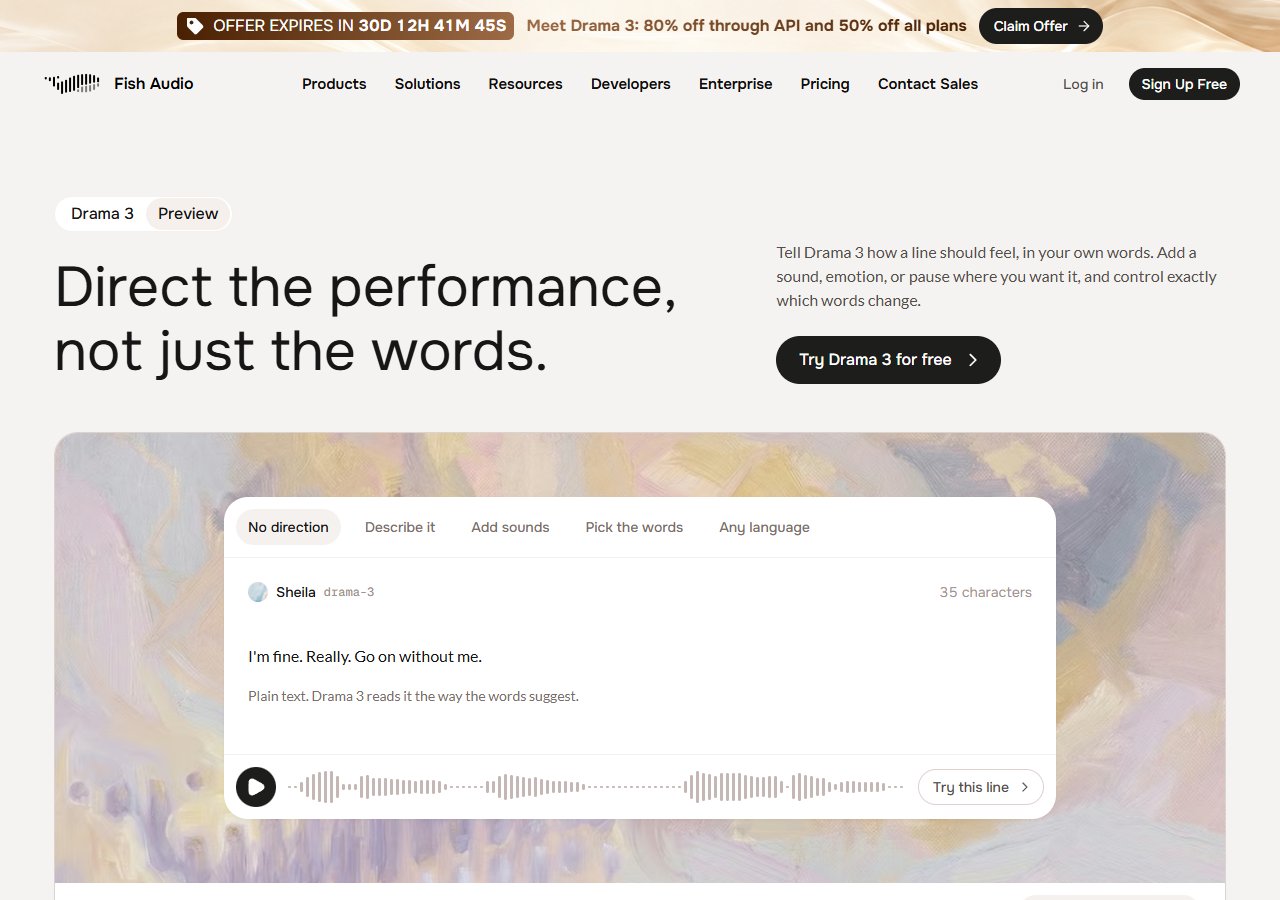
AI 목소리로 영상을 만들어 본 사람은 알아요. 글은 맞게 읽는데 느낌이 안 맞는 한 줄 때문에 몇 번씩 다시 뽑게 돼요. Fish Audio가 내놓은 Drama 3는 그 느낌을 글로 적어서 지시하게 한 음성 합성 모델이에요. 공식 페이지의 첫 문장이 이래요. "Direct the performance, not just the words." — 낱말만이 아니라 연기를 지시하라는 뜻이에요. 지금은 미리보기(Preview)이고, 회사는 계속 고쳐 가는 중이라고 적었어요.
지시하는 방법 다섯 가지
- 말로 풀어 적기 — 대사 앞에
[warm and relaxed, like talking to an old friend]처럼 감정 · 의도 · 속도 · 누구에게 말하는지를 적어요. 정해진 꼬리표 목록에 없는 말도 돼요. - 소리 · 감정 · 쉼 넣기 —
Alright, [sigh] let's try again.처럼 한숨 · 웃음 · 숨 · 짧은 쉼을 원하는 자리에만 넣어요. - 고른 단어만 바꾸기 —
<whisper>Go on without me.</whisper>처럼 감싼 단어에만 걸려요. 페이지에 보이는 종류는 속삭임 · 강조 · 부드럽게 · 빠르게 · 느리게 · 힘줌 · 세게, 일곱 가지예요. - 자기 말로 지시하기 — 지시문을 영어가 아닌 말로 써도 돼요. 페이지에는 같은 대사에 중국어 · 스페인어 · 일본어로 "눈물을 참으면서 억지로 웃으며"라고 적은 예가 나와요.
- Auto Tag — 대본을 넣으면 지시를 알아서 붙여 줘요.
I was home. Asleep.이[defensive, slightly uneasy tone] I was home. [pause] Asleep.이 되는 식이에요. 마음에 드는 것만 남기고 고치면 돼요.
여러 사람이 나오는 장면도 한 번에 만들어요. 화자마다 목소리를 정하고 대사를 적으면 장면 전체를 한 번에 연기해요. 모델 카드에 따르면 글 하나에 화자 표시를 0번부터 15번까지, 16명까지 넣을 수 있고, 긴 글은 알아서 나눠서 조각마다 흘려보내요(스트리밍).
이미 뽑은 음성에서 단어만 고치기
모델 카드에는 "이어 쓰기로 고치기" 예가 있어요. 앞서 뽑은 문장(previous_takes)을 같이 보내면서 글에서 Wednesday를 Thursday로 바꾸면 그 부분이 바뀐 음성이 나오고, 그 결과에 다시 by noon → by five를 이어서 고치는 예까지 실려 있어요. 대본이 조금 바뀔 때마다 처음부터 다시 뽑던 일을 줄여 주는 쓰임이에요.
모델 파일도 공개
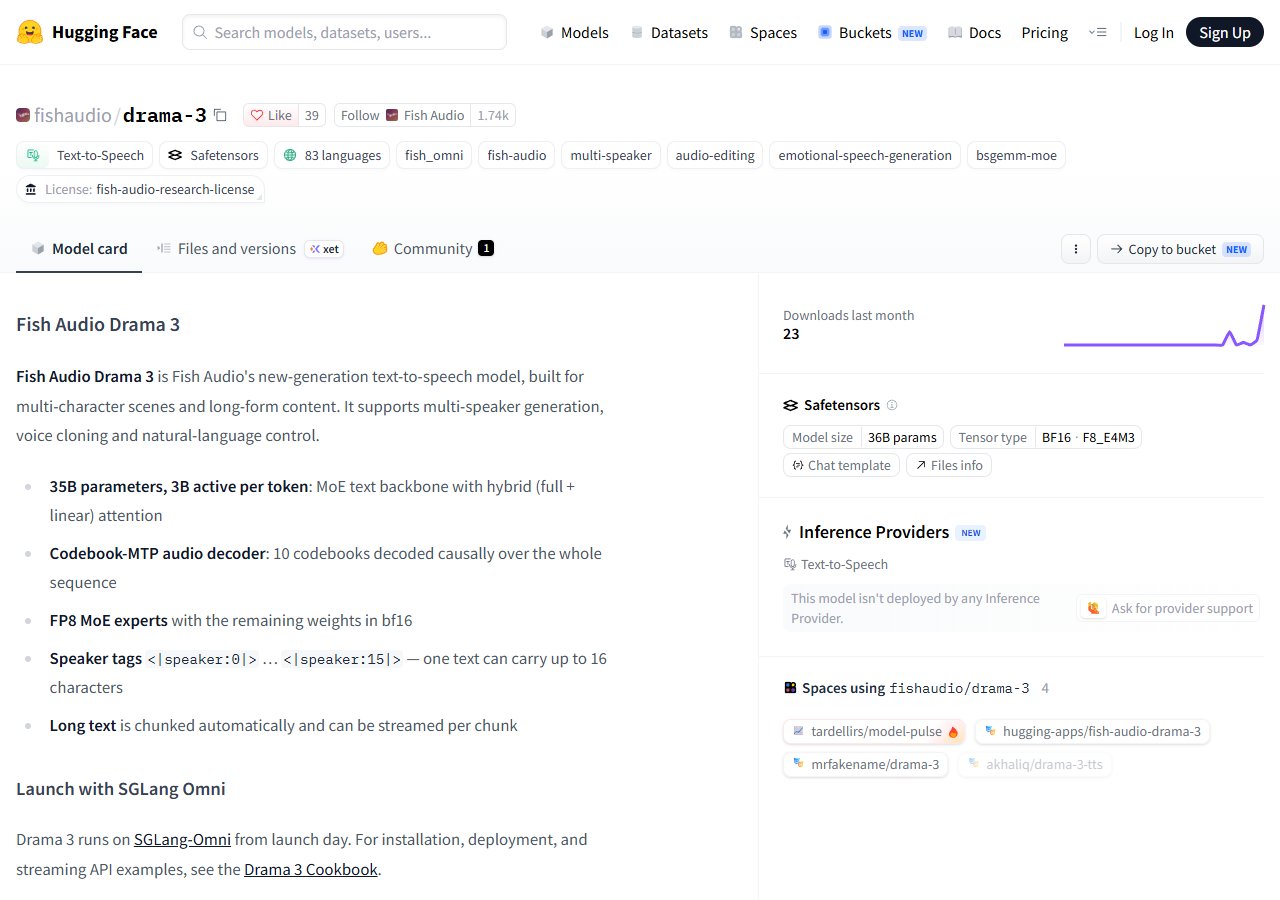
허깅페이스 fishaudio/drama-3에 가중치(모델 파일)가 올라와 있어요. 모델 카드에 적힌 내용은 이래요.
- 350억 파라미터, 토큰마다 30억만 켜짐 — 여러 전문가 묶음 가운데 필요한 것만 쓰는 구조(MoE)예요.
- 지원 언어 83개 — 목록에 한국어(ko)가 들어 있어요.
- 빠르기 — 엔비디아 H200 GPU 한 장에서 한 사람이 쓸 때 첫 소리까지 88.9ms(중앙값)예요. 16명이 한꺼번에 써도 소리가 재생 속도보다 약 2.7배 빨리 만들어진다고 해요(영어 시험 문장, 회사가 잰 값).
- 돌리는 방법 — SGLang-Omni라는 서빙 도구로 띄우는 명령이 카드에 있어요.
다만
- 완전히 풀린 오픈소스는 아니에요. 라이선스는 Fish Audio Community License 1.0(2026년 10월 13일 자)이에요. 연구 · 비상업은 무료이고, 상업 이용은 최근 12개월 매출이 50만 달러 미만일 때만 돼요. 넘으면 30일 안에 알려야 하고, 90일 뒤부터는 따로 계약이 필요해요.
- 남에게 음성 합성 서비스를 여는 것(API나 목소리 만들기가 주된 기능인 앱)은 매출과 상관없이 따로 계약이 필요해요. 내가 만든 콘텐츠의 내레이션 · 더빙, 의뢰받아 완성본만 넘기는 작업은 여기에 들지 않는다고 적혀 있어요.
- 실제 사람 목소리를 동의 없이 흉내 내는 것, 모델이 넣는 워터마크를 일부러 지우는 것은 금지예요. 모델이나 그걸 쓴 제품을 배포하면 "Built with Fish Audio"를 보이게 적어야 해요.
- 빠르기 숫자는 서버용 GPU(H200)에서 잰 값이에요. 집 컴퓨터에서 얼마나 도는지는 카드에 없어요.
- 한국어 연기가 얼마나 자연스러운지는 직접 들어 보지 않았어요. 페이지의 예는 영어가 대부분이에요.
값
공식 페이지 맨 위에는 "Drama 3 출시 기념 — API 80% 할인, 모든 요금제 50% 할인"이라는 띠가 걸려 있고, 10월 14일 새벽에 봤을 때 남은 기간이 30일쯤으로 떠 있었어요. 요금 페이지의 무료 등급은 한 달 8,000크레딧(최대 7분, 한 번에 500자까지)이에요. 1분을 만드는 데 대략 600~625크레딧이 든다고 적혀 있어요.
여기 적은 기능과 숫자는 Fish Audio의 공식 페이지 · 모델 카드 · 라이선스 글에서 읽은 것이고, 직접 소리를 만들어 견줘 보지는 않았어요.