Mistral Voxtral 3 — 받아쓰기 분당 $0.004, 음성 합성 100만 자 $13, 1초 안에 대답하는 음성 에이전트 SDK까지
Mistral이 10월 20일 받아쓰기(STT) · 음성 합성(TTS) 모델 새 세대와 LiveKit 기반 음성 에이전트 SDK를 묶은 Voxtral 3를 내놨어요. 오늘부터 API로 쓸 수 있어요.
- Mistral이 받아쓰기 모델 3종(Small · Mini · Mini Realtime), 음성 합성 모델 Voxtral Speech 3(Mini TTS 3), 음성 에이전트 SDK를 묶은 Voxtral 3를 공개했어요. Mistral API(유럽 · 미국 · 글로벌)로 바로 쓸 수 있어요.
- 값은 받아쓰기 Small 분당 $0.004 · Mini(4B) $0.0035 · 실시간 $0.008, 음성 합성 100만 자당 $13이에요. 받아쓰기는 50개 이상 언어, 음성 합성은 35개 이상 언어 · 50개 이상 방언을 지원해요.
- SDK는 LiveKit 기반으로 듣기 · 추론 · 도구 호출 · 말하기를 한 스트리밍 흐름으로 돌려, 한 차례 대답을 1초 안에 끝낸다고 해요. 숫자는 모두 Mistral 자체 측정이에요.
전화 · 웹 상담용 음성 봇을 만들 때 SDK 하나로 듣기(Realtime 3) · 생각(Mistral Small 같은 LLM) · 말하기(Speech 3)를 이을 수 있어요. 단계마다 모델이 따로라 LLM · 목소리 · 언어만 바꿔 끼울 수 있고, 전화는 SIP, 브라우저 · 앱은 WebRTC로 붙어요.
인터뷰 · 대담 녹음을 '누가 말했는지'까지 나눠 받아 적어 자막 초안을 만들 수 있어요. 출연자 이름 · 전문용어는 context biasing(키워드 미리 넣기)으로 맞출 수 있어요. Small 기준 1시간 녹음이면 약 $0.24(분당 $0.004 × 60)예요.
예약 · 문의 전화 자동 응대를 사람 상담 전에 시안으로 들어 볼 수 있어요. Studio 플레이그라운드에서 음성 에이전트 · 받아쓰기 · 음성 생성 · 목소리 복제를 바로 시험할 수 있다고 원문에 적혀 있어요.
1. Mistral Studio 플레이그라운드에서 받아쓰기 · 음성 생성 · 음성 에이전트를 먼저 시험해요(원문 안내).
2. 받아쓰기는 이름 · 전문용어 목록을 context biasing에 넣은 결과와 안 넣은 결과를 나란히 비교해요.
3. API 연결은 공식 문서(docs.mistral.ai)의 안내를 따르세요. 자체 서버 설치는 Mistral 팀에 문의하라고 적혀 있어요.
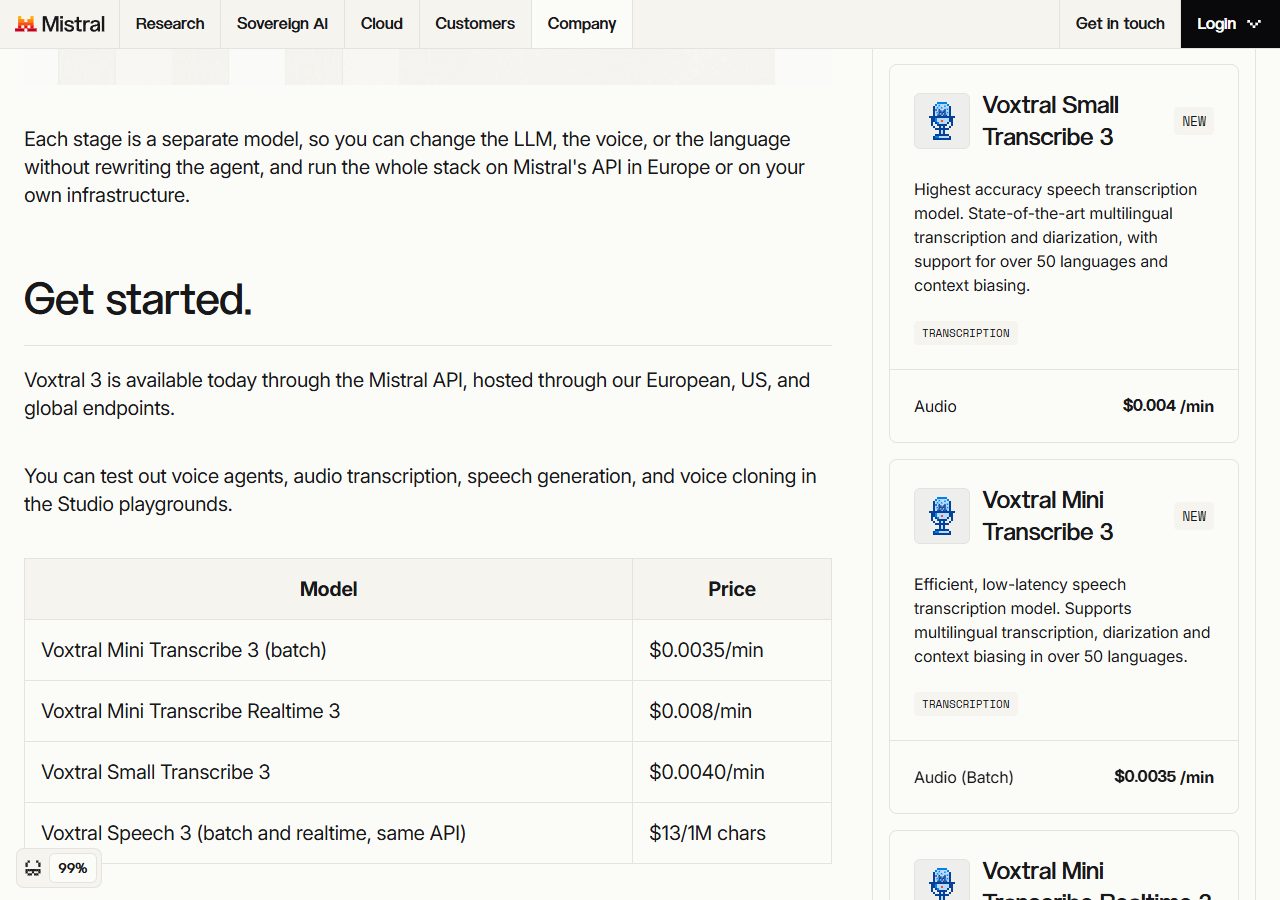
비용: 받아쓰기 Small 분당 $0.004 · Mini $0.0035 · 실시간 $0.008, 음성 합성 100만 자당 $13

인터뷰나 대담 영상의 화자별 자막 초안을 만들 때, 출연자 이름과 전문용어를 키워드로 넣어 받아쓰기를 비교해 보면 좋을 것 같아요. 한국어도 받아쓰기 시험 언어와 음성 프리셋에 들어 있으니, 우리말 품질은 직접 들어 보고 정하는 게 좋을 것 같아요.
Mistral AI가 2026년 10월 20일 음성 모델 새 세대 Voxtral 3를 공개했어요. 받아쓰기(STT) · 음성 합성(TTS) 모델과 함께, 듣기 · 생각 · 도구 호출 · 말하기를 실시간 스트리밍 흐름 하나로 묶은 음성 에이전트 SDK를 냈어요. 원문은 쓰임새로 콜센터 상담원, 서비스 데스크, 가상 비서, 손을 쓰지 않는 코파일럿을 들었어요.
모델과 값 (원문 표 그대로)
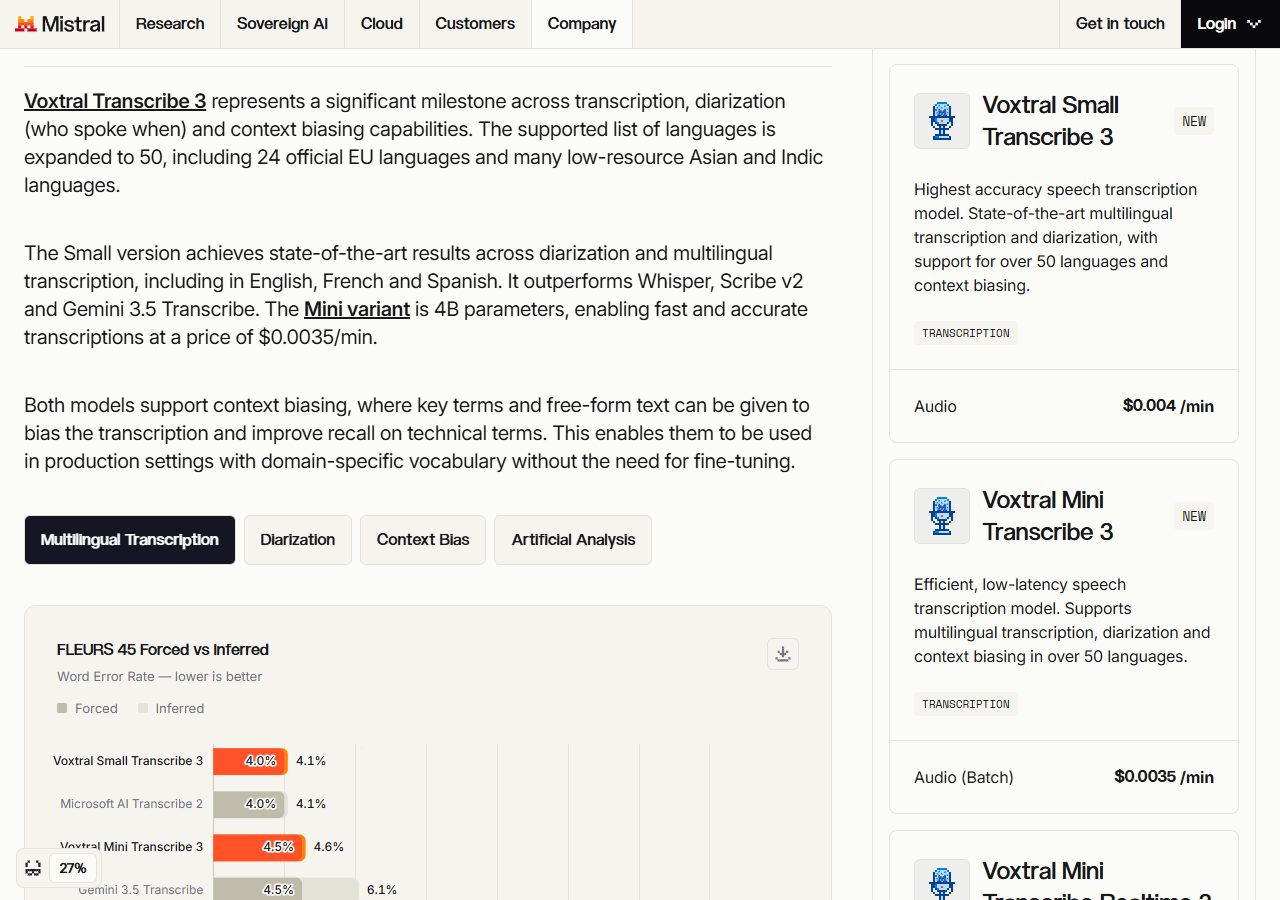
- Voxtral Small Transcribe 3 — 가장 정확한 받아쓰기. 50개 이상 언어, 화자 분리(누가 말했는지), context biasing, 말이 끝났는지 감지. 분당 $0.004
- Voxtral Mini Transcribe 3 — 4B 파라미터, 일괄(batch) 처리. 분당 $0.0035
- Voxtral Mini Transcribe Realtime 3 — 지연 500ms 미만 실시간 받아쓰기, 화자 분리 · context biasing 포함. 분당 $0.008 (지원 언어는 본문엔 35개 이상, 가격 카드엔 40개 이상으로 적혀 있어요)
- Voxtral Speech 3(본문 이름 Voxtral Mini TTS 3.0) — 일괄 · 실시간을 같은 API로. 35개 이상 언어 · 50개 이상 방언. 100만 자당 $13
받아쓰기 숫자 (Mistral 자체 측정)
- FLEURS 45개 언어 평균 오류율: Small 4.0~4.1%, Mini 4.5~4.6%, Whisper large-v3 14.9~16.0% (언어를 지정했을 때 · 자동 감지했을 때). 일본어 · 한국어 · 태국어 · 중국어는 글자 오류율(CER)로 쟀어요. 같은 표의 Microsoft AI Transcribe 2도 4.0~4.1%로 Small과 비슷해요.
- 화자 분리(cpWER, 공개 시험 5개 평균): Small 18.4%, Mini 18.6%, 같은 표 Gemini 3.5 Transcribe 38.4%.
- 키워드 재현율(Earnings 22): Small은 키워드를 넣었을 때 94.6%, 안 넣었을 때 81.4%. 같은 표 Scribe v2는 94.3% · 84.0%로 넣었을 때 결과가 거의 같아요.
- 실시간(FLEURS 35개 언어 평균): Realtime 3은 지연 설정에 따라 2400ms 5.7% · 960ms 6.0% · 480ms 6.4% · 240ms 7.4%예요. 같은 표에서 Gemini 3.5 Realtime Transcribe는 4.2%로 더 낮고, GPT Live Transcribe는 8.4%예요.
음성 합성
- 글의 맥락을 읽고 감정 · 속도 · 강조를 스스로 맞추고, 지시로 직접 조절할 수도 있어요. 맥락 반영 TTS, 어휘 사전, 30분 이상 음성으로 목소리 복제를 지원해요.
- Pro Voice: 30분 음성만으로 화자의 특징 · 감정 폭 · 말투를 여러 언어에 걸쳐 재현한다고 해요.
- 음성 프리셋이 있는 언어 18개에 한국어가 들어 있어요.
- 원문은 100만 자당 $13이 OpenAI TTS-1, Deepgram, ElevenLabs Flash, Gemini Flash의 비슷한 모델보다 싸다고 적었어요. 품질 비교 그래프 4개(Voice Code Bench 300문장 · 발음 조절 300문장 · 11개 언어 377문장 · 영어 표현력 237문장)는 모두 gemini-3.8-flash가 채점한 자체 평가예요.
음성 에이전트 SDK
- LiveKit 기반. Realtime 3이 듣고 말이 끝난 때를 감지하면, Mistral Small 같은 일반 모델이 추론 · 도구 호출을 하고, Speech 3가 대화 분위기에 맞춰 대답해요.
- 원문 표현으로 "어떤 단계도 앞 단계를 기다리지 않아" 한 차례가 1초 안에 끝나고, 상대가 끼어들면 말을 멈춰요.
- 본인 확인 · 요금 조회 · 예약 같은 일을 함수 호출 · 웹 검색 · 내 시스템 검색으로 처리해요. 전화는 SIP, 브라우저 · 앱은 WebRTC로 연결돼요.
쓰는 곳
Mistral API(유럽 · 미국 · 글로벌 엔드포인트)로 오늘부터 쓸 수 있고, Studio 플레이그라운드에서 음성 에이전트 · 받아쓰기 · 음성 생성 · 목소리 복제를 시험할 수 있어요. 자체 서버나 프라이빗 클라우드에 통째로 설치하려면 Mistral 팀에 문의하라고 적었어요.
- 두 사람이 음성 에이전트 하나와 동시에 대화하고, 에이전트가 지금 누가 말하는지 실시간으로 구분(화자 분리)해요.
- 에이전트는 세 단계가 동시에 흐른다고 설명해요: Voxtral 받아쓰기가 듣고 차례를 감지, 영상 속에선 Mistral Large가 추론, 최신 Voxtral 음성 모델이 대답.
- 말 끊기 처리, 영어 · 프랑스어 · 독일어 이어 말하기, 웹 검색 도구 호출을 보여 주고, 차례 사이 간격은 1초 미만을 목표로 한다고 말해요.