프론트엔드 버그 캡처만 보고 코드를 고친다 — Claude Opus 5.5가 시각 코딩 벤치마크에서 2위를 9점 차로 이겼어요
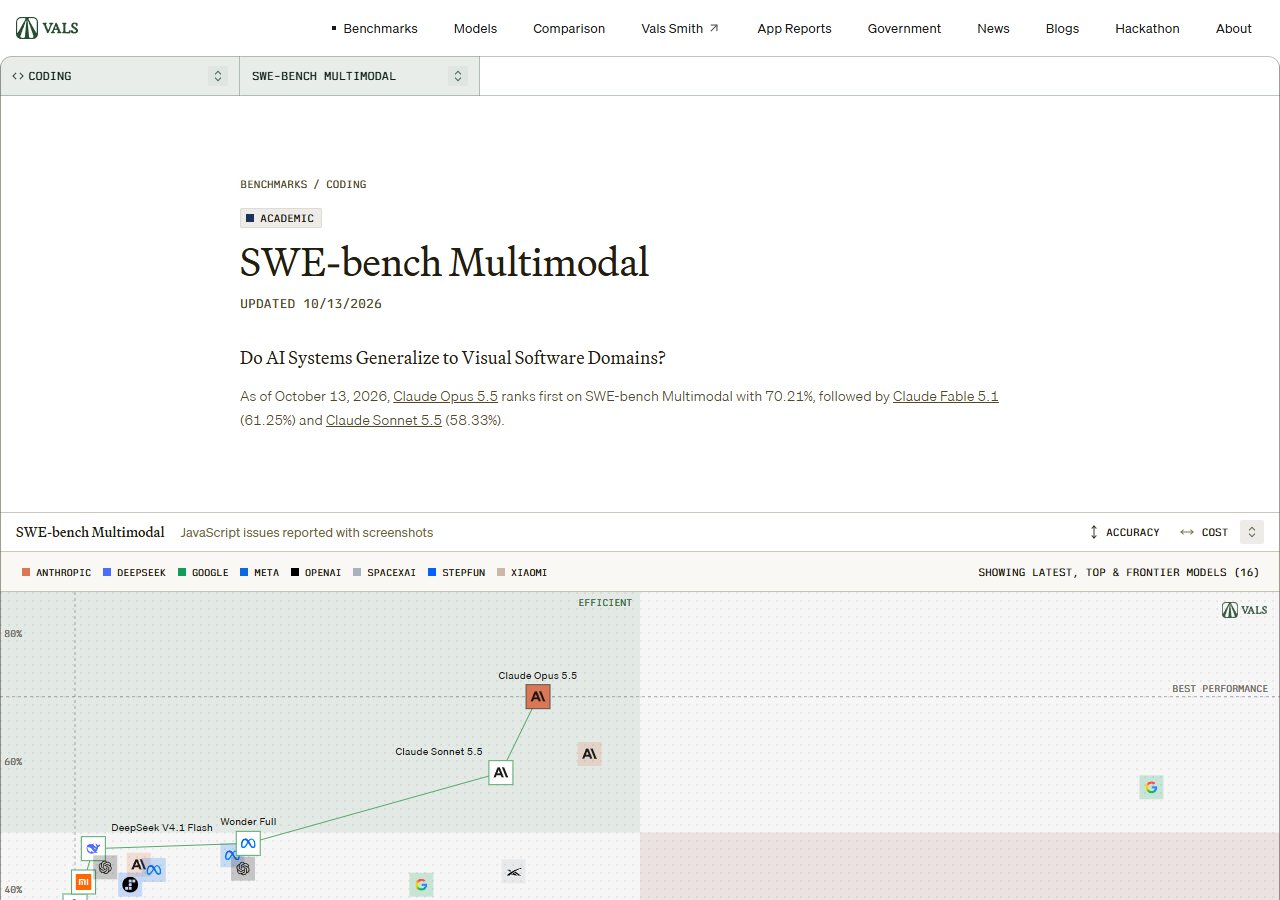
Vals AI가 공개한 SWE-bench Multimodal 결과에서 Claude Opus 5.5가 70.2%로 1위를 기록했어요. 2위 Claude Fable 5.1(61.3%)과의 차이는 약 9점이에요. 스크린샷만 보고 자바스크립트 버그를 고치는 벤치마크예요.
- SWE-bench Multimodal은 스크린샷으로 보고된 자바스크립트 버그를 AI가 코드로 고치는 벤치마크예요. 480개 과제, 11개 저장소로 구성돼요.
- Claude Opus 5.5가 70.21%로 1위, 2위 Claude Fable 5.1(61.25%)과 약 9점 차이예요. 3위는 Claude Sonnet 5.5(58.33%), 4위 Gemini 4 Argon(56.04%)이에요.
- 18개 모델 모두 같은 에이전트 프레임워크(mini-swe-agent)로 테스트했고, 인터넷 접속 없이 평가했어요. 인터넷이 되면 점수가 21~35점 부풀려져요.
프론트엔드 버그 수정에 어떤 모델을 쓸지 고를 때 참고할 수 있어요. Claude Opus 5.5가 시각 정보가 포함된 이슈에서 확실히 강해요.
웹사이트 디자인 깨짐을 스크린샷으로 찍어서 AI에 맡길 때, 시각 이해력이 좋은 모델을 고르는 기준이 돼요.
"이 화면이 이상해요" 같은 캡처를 개발자 대신 AI에 맡기고 싶을 때, 어떤 모델이 제일 잘하는지 알 수 있어요.
웹 페이지 레이아웃이 깨졌을 때 스크린샷 한 장으로 수정 코드를 받는 워크플로에 써 보면 좋을 것 같아요.
AI가 버그 리포트 스크린샷만 보고 코드를 고칠 수 있을까요? Vals AI가 10월 13일 업데이트한 SWE-bench Multimodal 결과에 따르면, Claude Opus 5.5가 이 과제에서 2위를 약 9점 차로 이겼어요.
SWE-bench Multimodal이 뭔가요?
일반 SWE-bench가 텍스트 이슈를 다뤘다면, SWE-bench Multimodal은 시각 정보가 포함된 버그 리포트를 다뤄요. 스크린샷, 디자인 목업, 에러 메시지 이미지 등이 붙은 실제 GitHub 이슈를 AI에 주고, 자바스크립트 저장소에서 코드를 고쳐 테스트를 통과하게 만드는 거예요.
버전 2(2026년 9월) 기준으로 11개 저장소에서 뽑은 480개 과제가 포함돼요. 재현이 안 되거나 채점이 어려운 과제는 제외했어요.
상위 5위 결과
18개 모델을 SWE-agent 팀의 mini-swe-agent(동일 에이전트 프레임워크)로 테스트했어요.
| 순위 | 모델 | 정확도 | 건당 비용 |
|---|---|---|---|
| 1 | Claude Opus 5.5 | 70.21% | $4.92 |
| 2 | Claude Fable 5.1 | 61.25% | $5.46 |
| 3 | Claude Sonnet 5.5 | 58.33% | $4.53 |
| 4 | Gemini 4 Argon | 56.04% | $11.40 |
| 5 | Wonder Full | 47.29% | $1.86 |
GPT-6.1 Sol은 43.54%, Grok 4.7은 42.92%를 기록했어요. 비용 효율로는 DeepSeek V4.1 Flash가 건당 $0.23으로 46.46%를 냈어요.
인터넷 차단이 핵심이에요
이 벤치마크에서 중요한 점이 있어요. 모든 점수는 인터넷 접속 없이 측정한 거예요. 인터넷이 되면 모델이 원본 PR(풀 리퀘스트)의 해결 코드를 찾아올 수 있어서, 점수가 21~35점이나 부풀려진다고 해요.
Anthropic 모델이 1~3위를 싹쓸이
눈에 띄는 건 상위 3위가 모두 Anthropic 모델이라는 점이에요. Opus 5.5, Fable 5.1, Sonnet 5.5가 차례로 1~3위를 차지했어요. 4위 Gemini 4 Argon은 56.04%로 선전했지만, 건당 비용이 $11.40으로 가장 비쌌어요.