
Epoch AI 벤치마크 점검표 — 22개 중 12개가 'Flawed', SWE-bench Verified · HLE · OSWorld도
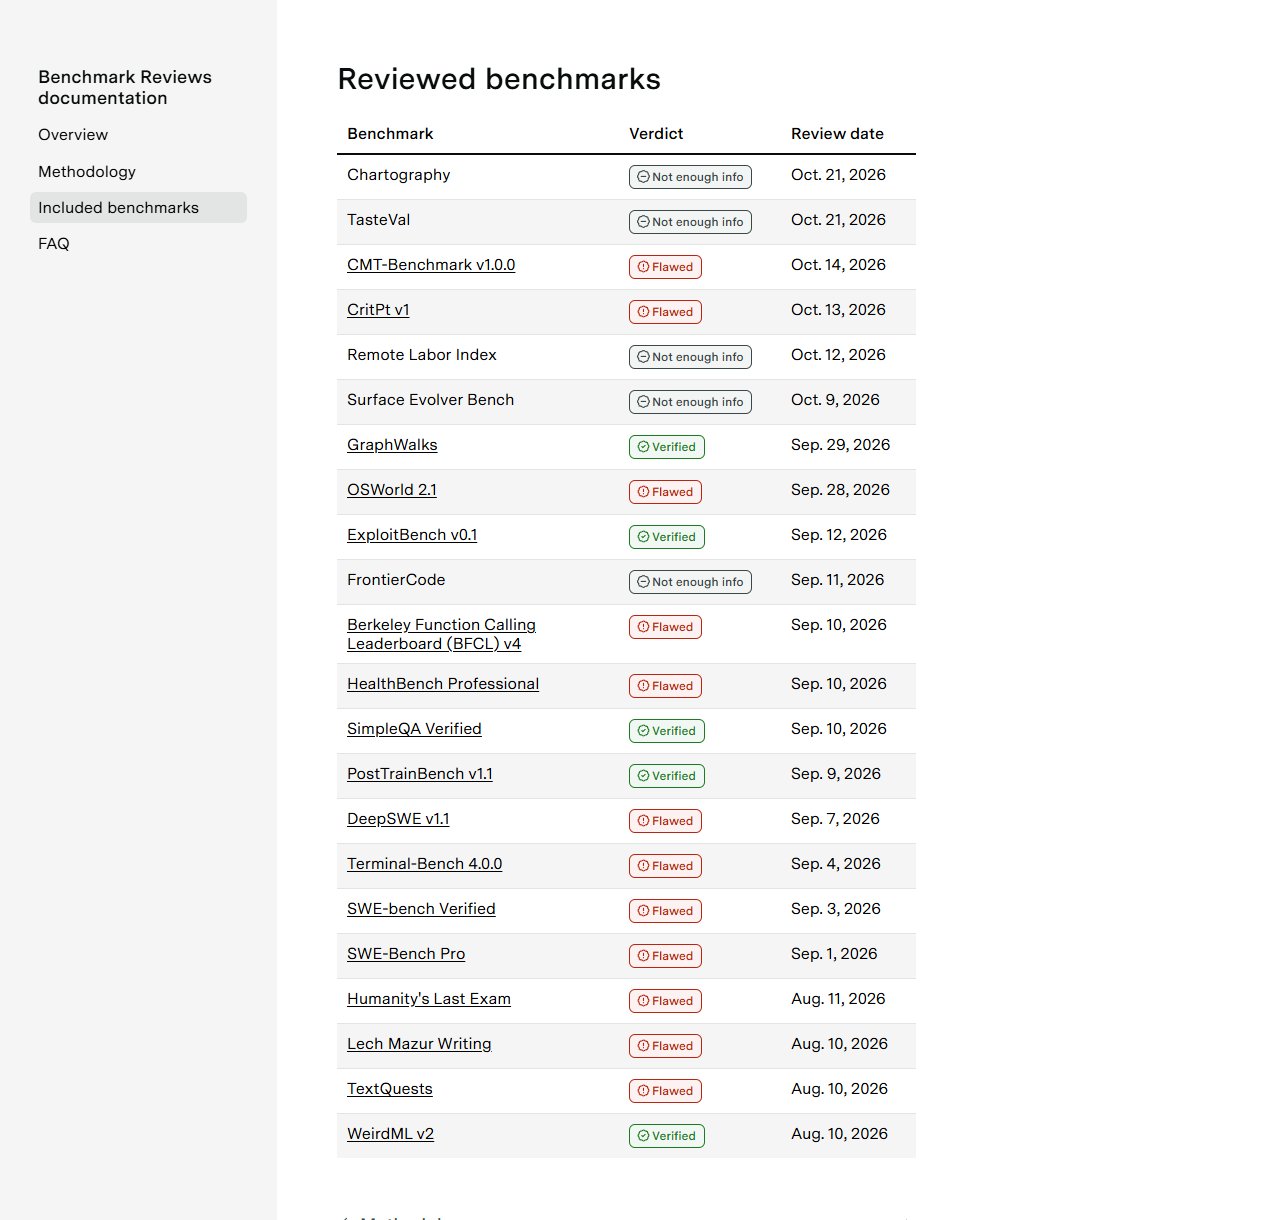
AI 모델 발표마다 나오는 점수표, 그 시험지 자체는 믿을 만할까요? Epoch AI가 바깥 벤치마크를 직접 점검하는 'Benchmark Reviews'를 하고 있어요. 10월 24일 기준 점검표에 오른 22개 중 12개가 'Flawed(결함 있음)' 판정이에요.
- Epoch AI의 'Benchmark Reviews' 점검표(10월 24일 확인)에는 22개 벤치마크가 있어요. Flawed 12개 · Verified 5개 · 정보 부족(Not enough info) 5개예요.
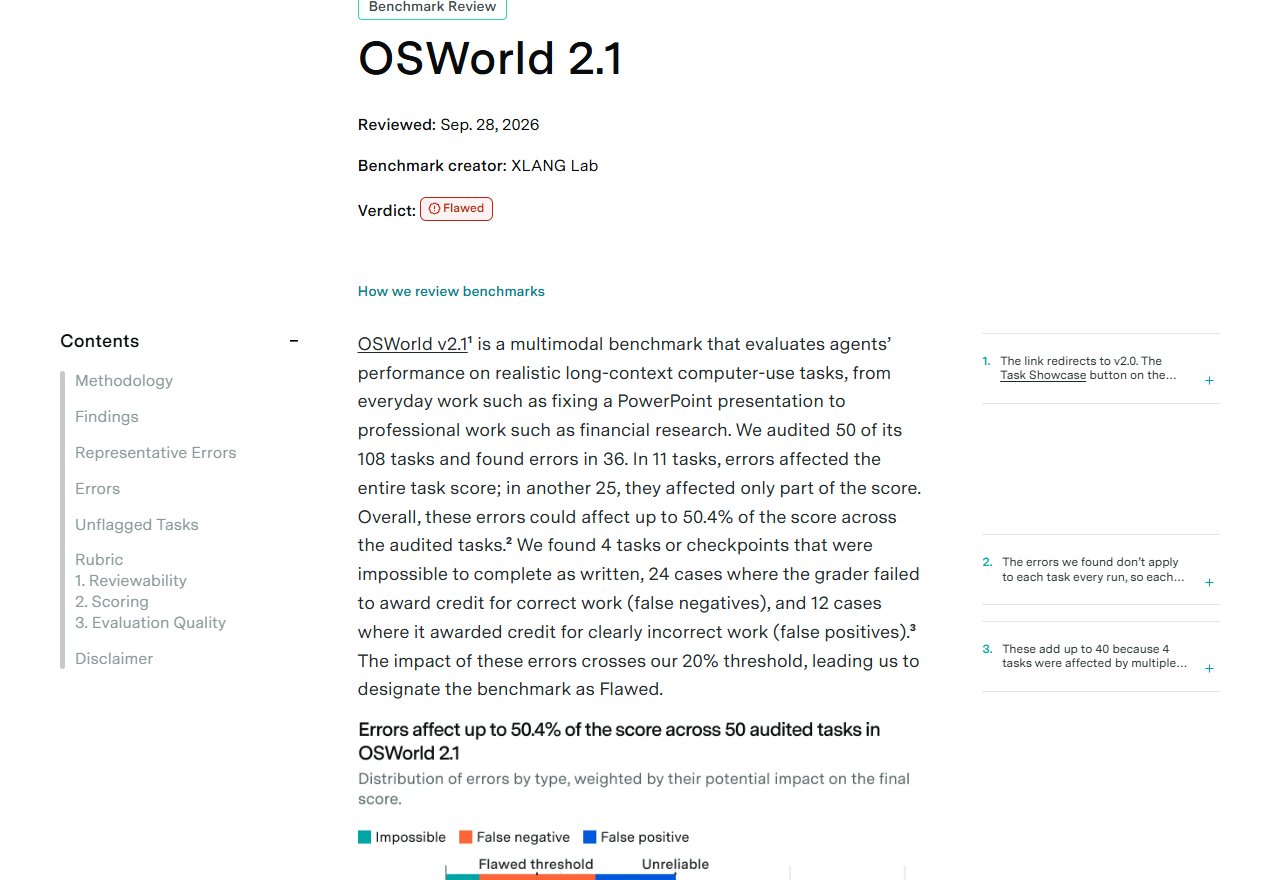
- Flawed는 '결과를 제대로 읽으려면 꼭 알아야 할 큰 결함이 하나 이상 있다'는 뜻이에요. 기본 기준은 점검한 문제에서 오류가 전체 점수의 20% 이상에 영향을 줄 때예요. SWE-bench Verified · SWE-Bench Pro · Humanity's Last Exam · OSWorld 2.1 · Terminal-Bench 4.0.0이 여기에 들어가요.
- 10월 23일 공식 소식 글 'The Epoch Brief'에서 Epoch는 최근 묶음이 새 점검 4건(Verified 1 · Flawed 3)이고, 4개는 정보가 모자라 판정을 못 했다고 밝혔어요. 자기 회사가 만든 벤치마크는 점검하지 않아요.
코딩 에이전트를 고를 때 SWE-bench Verified · Terminal-Bench 점수만 보고 정하지 말고, Epoch 점검 페이지에서 그 벤치마크의 판정과 결함 종류(정답인데 틀렸다고 채점 · 틀렸는데 맞다고 채점)를 먼저 확인해 보세요.
새 모델 소개 글 · 영상에서 'HLE 몇 점 1위' 같은 숫자를 쓸 때, 그 벤치마크가 Flawed 판정인지 한 줄 덧붙이면 더 믿음 가는 콘텐츠가 돼요.
도구를 살 때 회사가 내세운 벤치마크 이름을 점검표에서 찾아보세요. 점수 차이가 작다면 내 작업 샘플 몇 개로 직접 시험하는 쪽이 더 정확해요.
1) epoch.ai의 Benchmark Reviews 'Included benchmarks' 표를 열어요. 2) 내가 보던 벤치마크 이름(예: SWE-bench Verified)을 찾아 판정(Verified · Flawed · Not enough info)을 봐요. 3) 이름을 눌러 점검 페이지 첫 단락에서 결함 비율과 종류를 읽어요. 4) 모델을 비교할 땐 Verified 판정 벤치마크 점수에 더 무게를 둬요.

새 모델 점수를 소개하거나 비교할 때, 그 벤치마크의 Epoch 판정을 같이 적어 두는 습관에 써 보면 좋을 것 같아요.
AI 모델이 나올 때마다 벤치마크(모델 실력을 재는 시험 문제 모음) 점수표가 따라와요. Epoch AI는 바깥에서 만든 벤치마크를 직접 점검해서, 그 점수가 재려는 것을 제대로 재는지 판정하는 Benchmark Reviews를 하고 있어요. 10월 23일 공식 소식 글 'The Epoch Brief'에서 새 묶음을 알렸고, 이 일은 선임 연구원 Michelle Campeau가 이끈대요.
판정은 세 가지
- Verified: 설명대로 읽어도 되는 벤치마크. 오류가 있어도 결과를 크게 바꾸지 않아요.
- Flawed: 결과를 제대로 읽으려면 꼭 알아야 할 큰 결함이 하나 이상 있어요.
- Not enough information: 점검할 만큼 정보가 공개되지 않았어요.
Epoch 문서의 기본 기준은, 점검한 문제에서 오류가 전체 점수의 20% 이상에 영향을 주거나, 채점을 크게 망가뜨리는 문제가 있으면 Flawed예요. 오류 종류로는 '써 있는 대로는 풀 수 없음' · 거짓 음성(맞게 했는데 틀렸다고 채점) · 거짓 양성(틀렸는데 맞다고 채점, 지름길로 점수 따기 포함)을 들어요. Epoch는 이해 충돌 때문에 자기가 만든 벤치마크는 점검하지 않는다고 적었어요.
점검표 — 22개 중 12개 Flawed
'Included benchmarks' 페이지의 표(10월 24일 확인)에는 8월 10일부터 10월 21일까지 점검한 22개가 있어요. Flawed 12개 · Verified 5개 · Not enough info 5개예요.
- Flawed: CMT-Benchmark v1.0.0 · CritPt v1 · OSWorld 2.1 · BFCL v4 · HealthBench Professional · DeepSWE v1.1 · Terminal-Bench 4.0.0 · SWE-bench Verified · SWE-Bench Pro · Humanity's Last Exam · Lech Mazur Writing · TextQuests
- Verified: GraphWalks · ExploitBench v0.1 · SimpleQA Verified · PostTrainBench v1.1 · WeirdML v2
- Not enough info: Chartography · TasteVal · Remote Labor Index · Surface Evolver Bench · FrontierCode
10월 23일 The Epoch Brief는 최근 묶음을 '새 점검 4건: Verified 1 · Flawed 3, 그리고 4개는 정보가 모자라 판정 못 함'이라고 정리했어요.
자주 보던 벤치마크는 어떤 결함?
각 점검 페이지 첫 단락에 적힌 내용이에요.
- SWE-bench Verified(9월 3일): OpenAI가 2월 23일 낸 점검에서 문제의 27.6%를 살펴보니 그중 59.4%가 맞는 답도 떨어뜨리는 테스트를 갖고 있었대요. Epoch는 '20% 넘는 문제에 채점 문제가 있다고 꽤 확신한다'며 Flawed로 봤어요. 문제와 풀이가 100% 공개돼 있어, 모델이 학습 때 이미 봤을(오염) 위험도 높다고 봤어요.
- Humanity's Last Exam(8월 11일): 무작위로 고른 48문제 중 22문제(46%)에 정답을 바꿀 만한 큰 오류가 있었대요.
- OSWorld 2.1(9월 28일): 컴퓨터 사용 에이전트 시험이에요. 108개 과제 중 50개를 점검해 36개에서 오류를 찾았고, 이 오류가 점검한 과제 점수의 최대 50.4%에 영향을 줄 수 있대요. 거짓 음성 24건 · 거짓 양성 12건 · 풀 수 없는 과제나 체크포인트 4건이에요.
- Terminal-Bench 4.0.0(9월 4일): 66개 과제 중 30개(45.5%)에 공개적으로 지적된 채점 결함이 있대요.
- SWE-Bench Pro(9월 1일): 바깥 점검들이 과제의 30% 이상이 망가졌다고 추정했대요.
- CMT-Benchmark v1.0.0(10월 14일): 물리 연구자들의 점검(Ansari et al. 2026)에서 문제의 60%에 채점 결함이 나왔대요.
반대로 GraphWalks(OpenAI · 9월 29일)는 Verified예요. 독립적으로 푼 결과가 1,150개 과제 모두에서 적힌 정답과 같았대요.
Epoch 자기 벤치마크는?
The Epoch Brief에 따르면 Epoch는 자기 벤치마크를 바깥 업체 Generality Labs에 맡겨 따로 점검받고 있고, 지금까지 Chess Puzzles와 EBR-bench 점검이 끝났대요. 점검표 각주에는 FrontierMath v1 점검에서 문제의 42%에 오류가 있었다는 내용도 적혀 있어요.
- Epoch AI — Benchmark Reviews: Included benchmarks
- Epoch AI — Benchmark Reviews documentation (Overview)
- Epoch AI — The Epoch Brief, October 23, 2026
- Epoch AI — SWE-bench Verified review
- Epoch AI — Humanity's Last Exam review
- Epoch AI — OSWorld 2.1 review
- Epoch AI — Terminal-Bench 4.0.0 review
- Epoch AI — SWE-Bench Pro review
- Epoch AI — CMT-Benchmark review
- Epoch AI — GraphWalks review