
0.5B 크기 오픈 음성 모델 'Ming-3.0-tts' — 한국어 포함 7개 언어, MIT 라이선스
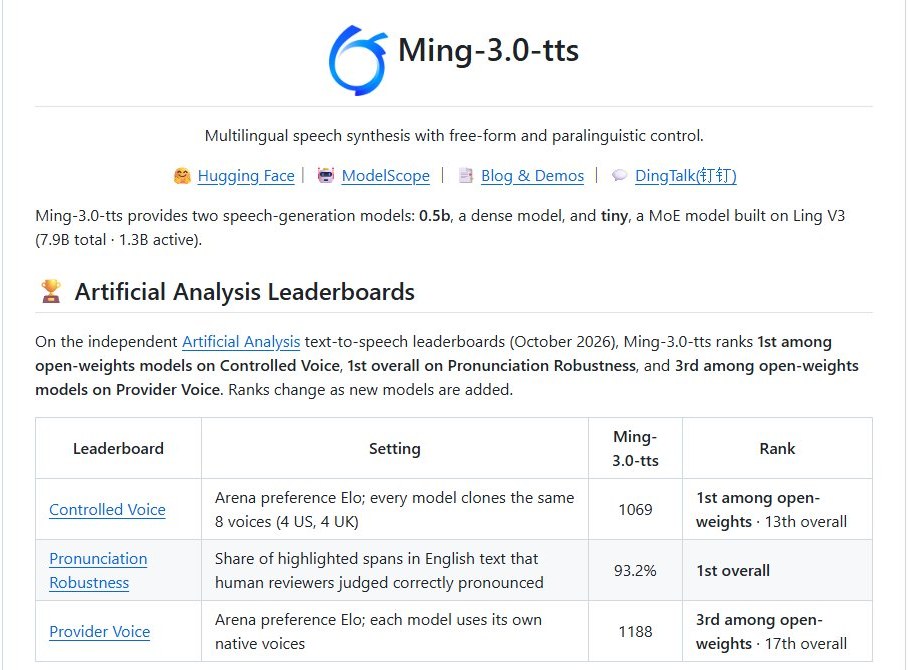
inclusionAI(Artificial Analysis 표기 개발사는 Ant Group)가 파라미터 0.5B짜리 음성 합성(TTS) 모델을 MIT 라이선스로 공개했어요. 개발팀 README는 Artificial Analysis 음성 순위에서 '오픈 가중치 모델 중 1위(Controlled Voice)'라고 적었어요.
- inclusionAI가 음성 합성 모델 Ming-3.0-tts-0.5B를 Hugging Face에 MIT 라이선스로 올렸어요. Qwen2.5-0.5B를 바탕으로 한 0.5B(5억) 파라미터 모델이고, 중국어 · 영어 · 독일어 · 스페인어 · 프랑스어 · 한국어 · 일본어를 지원해요.
- 짧은 참고 음성으로 목소리 복제, 글로 목소리 설계, 웃음 · 한숨 같은 태그 14종, 감정 · 속도 · 높낮이 · 크기 조절을 할 수 있어요. 기본 목소리는 중국어 100개 이상 · 영어 5개예요.
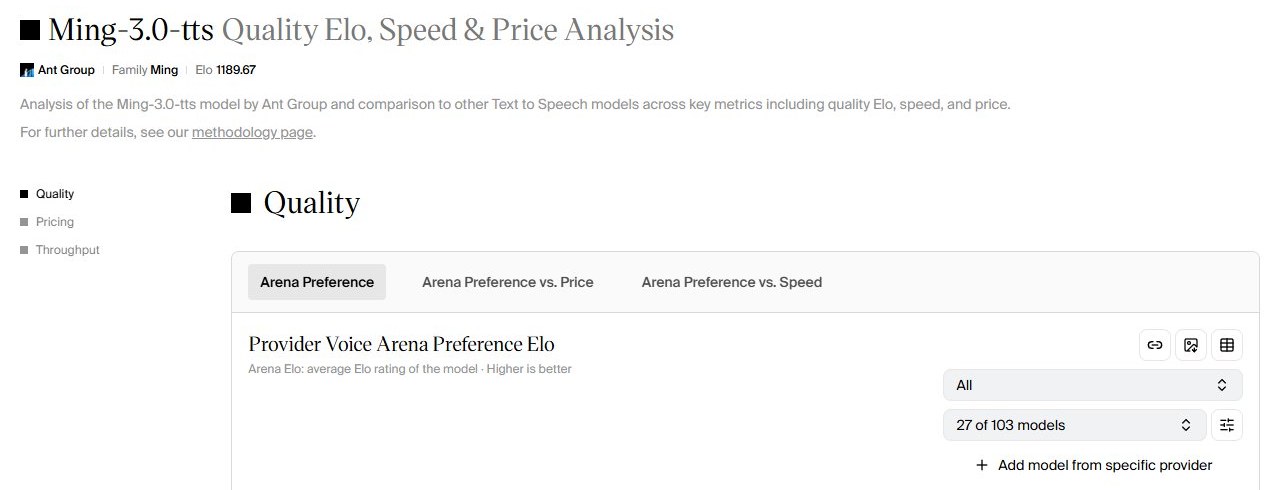
- 개발팀 GitHub README(2026년 10월 기준)는 Artificial Analysis 순위에서 Controlled Voice 오픈 가중치 1위(전체 13위) · Provider Voice 오픈 가중치 3위(전체 17위)라고 밝혔어요. 10월 23일 Artificial Analysis 모델 페이지의 Elo는 1189.67이에요.
작은 오픈 TTS를 직접 돌려 볼 후보로 좋아요. 라이선스가 MIT라 서비스에 붙여 보기 쉬워요. 다만 README에 적힌 테스트 환경은 NVIDIA H800 · H20(CUDA 12.4)이라, 집 PC GPU에서 얼마나 빠른지는 직접 재 봐야 해요.
영상 내레이션에 웃음 · 한숨 · 머뭇거림 같은 소리를 태그로 넣어 볼 수 있어요. 다만 이 태그와 기본 목소리는 중국어 · 영어 기준이고, 한국어는 MULTILINGUAL 작업에서 language_id를 넣어 써요.
유료 음성 서비스 대신 오픈 모델로 안내 음성을 만들 수 있을지 가늠해 볼 자료예요. 순위표 기준으로 위에 있는 상용 모델이 아직 여럿이라, 품질은 데모로 먼저 들어 보세요.
1. git clone https://github.com/inclusionAI/Ming-3.0-tts.git
2. cd Ming-3.0-tts 후 pip install -r requirements.txt
3. pip install "huggingface_hub[cli]" 후 hf download inclusionAI/Ming-3.0-tts-0.5B --local-dir Ming-3.0-tts-0.5b
4. python tools/preflight.py --model_path /path/to/Ming-3.0-tts-0.5b 로 체크포인트를 확인하고, infer.py 사용법은 GitHub README를 따르세요.
라이선스: MIT · 비용: 모델은 무료, GPU는 직접 준비

영상 내레이션을 오픈 모델로 바꿔 볼 생각이라면, 데모 페이지에서 목소리를 먼저 들어 보고 짧은 한국어 문장으로 시험해 보면 좋을 것 같아요.
inclusionAI가 음성 합성(TTS, 글을 읽어 주는 AI) 모델 Ming-3.0-tts를 공개했어요. Artificial Analysis는 개발사를 Ant Group으로, 공개일을 10월 19일로 적고 있어요. 모델은 두 가지예요. 이 기사의 주인공인 0.5b(밀집형 · 0.5B 파라미터)와, Ling V3 기반 MoE(필요한 부분만 켜서 쓰는 구조) 모델 tiny(전체 7.9B · 실제 사용 1.3B)예요. 둘 다 MIT 라이선스예요.
0.5B 모델에 들어 있는 것
Hugging Face 모델 카드에 따르면 Ming-3.0-tts-0.5B는 Qwen2.5-0.5B를 뼈대로 쓰고, 소리는 44.1kHz로 만들어요. 지원 언어는 중국어 · 영어 · 독일어 · 스페인어 · 프랑스어 · 한국어 · 일본어이고, 사천어 · 광둥어 방언도 돼요.
- 짧은 참고 음성으로 목소리 복제(제로샷 보이스 클로닝)
- 글로 설명해 새 목소리 만들기(Voice Design)
- 말투 · 말하는 방식을 자유 문장으로 지시(Free-form)
- 기본 목소리: 중국어 100개 이상 · 영어 5개
- 숨 · 기침 · 한숨 · 웃음 · 머뭇거림 · 놀람 등을 넣는 태그 14종(중국어 · 영어)
- 감정 · 속도 · 높낮이 · 크기 조절
여러 사람이 대화하는 음성 만들기는 tiny 모델에만 있어요.
순위표에서는
개발팀 GitHub README는 Artificial Analysis 음성 순위(2026년 10월 기준)에서 Ming-3.0-tts가 이렇게 나왔다고 적었어요. 순위는 새 모델이 들어오면 바뀐다는 말도 함께 있어요.
- Controlled Voice(모든 모델이 같은 목소리 8개를 복제해 겨루는 표): Elo 1069 · 오픈 가중치 모델 중 1위 · 전체 13위
- Provider Voice(모델마다 자기 기본 목소리로 겨루는 표): Elo 1188 · 오픈 가중치 모델 중 3위 · 전체 17위
- Pronunciation Robustness(영어 문장의 표시 구간을 사람이 '맞게 읽었다'고 본 비율): 93.2% · 전체 1위
Elo는 사람들이 두 음성을 듣고 더 나은 쪽을 고른 결과로 매긴 점수예요. 10월 23일에 연 Artificial Analysis의 Ming-3.0-tts 모델 페이지에는 Elo가 1189.67로 나와 있고, 이 페이지가 연결한 가중치는 0.5B 모델이에요.
개발팀 자체 평가
모델 카드의 표(개발팀이 직접 잰 값)에서 0.5b는 Seed-TTS 평가 세트 중국어 WER(틀린 단어 비율, 낮을수록 좋음) 0.800%, 영어 1.584%였어요. 같은 표에서 CosyVoice3-1.5B는 0.710% · 1.450%로 0.5b보다 낮았어요. 속도 · 크기 · 높낮이 조절 평균 정확도는 0.5b가 93.30%, CosyVoice3-0.5B가 87.67%였어요. 한국어(MiniMax 다국어 시험 세트) CER(틀린 글자 비율)은 1.728%예요.
모델 카드는 한계도 적었어요. 목소리 닮음 정도가 내용 정확도보다 약하고(프랑스어가 가장 큰 차이), 한 문장에 웃음 · 한숨 같은 소리가 여러 개 들어가면 아직 덜 안정적이며, 감정이 없는 문장에선 감정 조절이 어렵다고 해요.
써 보려면
Hugging Face 저장소는 가중치만 나눠 주고, 실행 코드는 GitHub 저장소에 있어요. README는 NVIDIA H800-80GB · H20-96G, CUDA 12.4에서 시험했다고 적었어요. 목소리 복제와 기본 캐릭터 목소리는 연구 · 정당한 창작용이며, 동의 없이 실제 사람을 흉내 내지 말고 진짜 녹음으로 오해할 수 있는 곳에선 합성 음성이라고 표시하라는 사용 안내도 있어요.
- 작성 시각을 실제 시각(09:15)으로 고침