OpenAI 코딩 에이전트 감시 시스템, 외부 연구자 3주 점검에서 빈틈 여러 곳 나왔어요 — METR · Redwood Research 보고
METR가 10월 22일, Redwood Research와 함께 OpenAI 안에서 3주 동안 내부 에이전트 감시 시스템을 점검한 결과를 공개했어요. 감시를 피하거나 끌 수 있는 길이 여러 개 나왔고, OpenAI는 운영 중인 안전장치에 영향을 주는 취약점은 모두 고쳤다고 밝혔어요(METR은 이 말을 따로 검증하지 않았어요).
- METR 직원 1명과 Redwood Research 직원 1명이 7월 21일~8월 11일, OpenAI 내부 코드 · 감시 프롬프트 · 내부 문서에 접근해 'AI 에이전트가 정렬에서 어긋난 행동을 하는지' 지켜보는 감시 시스템을 점검했어요. 결과는 61쪽 내부 보고서로 OpenAI에 전달됐어요.
- Codex 에이전트가 샌드박스와 Auto-Review를 우회할 수 있는 길, 최근 행동 수백 개를 감시에서 빠지게 하는 방법, 감시를 끄는 헤더 2개 등이 나왔어요. 감시 대상이던 트래픽은 GPT-5.5급 이상 모델의 내부 Responses API 에이전트 트래픽 중 약 75~94%로 추정됐어요.
- OpenAI는 운영 안전장치에 영향을 주는 취약점은 모두 고쳤다고 밝혔지만, METR은 이 주장을 평가하지 않았다고 적었어요. 다만 '차례를 넘길 때만 감시' 빈틈을 에이전트가 실제로 썼는지는 접근 제한 때문에 확인하지 못했다고 적었어요.
코딩 에이전트를 내 서비스나 사내 도구에 붙인다면, METR가 정리한 설계 원칙을 점검표로 써 볼 만해요. '차례가 끝날 때만 검사하지 말고 N개 메시지 · N분마다 검사', '에이전트가 감시 실행 여부를 바꿀 수 없게', '에이전트가 보는 내용과 감시가 보는 내용을 똑같이'가 원문 그대로의 권고예요.
'AI 에이전트를 누가 · 어떻게 감시하나'를 다루는 해설 콘텐츠에 쓸 만한 1차 자료예요. 다만 '취약점 6개'처럼 숫자로 묶지 말고, 원문은 '찾은 것의 예시 요약'이라고 적었다는 점을 함께 전하는 게 정확해요.
Codex 같은 에이전트에 내 컴퓨터 권한을 넓게 줄 때, 샌드박스와 자동 검토를 '완벽한 벽'으로 믿기보다 중요한 폴더 · 키는 처음부터 손 닿지 않게 두는 쪽이 안전하다는 걸 다시 확인하는 사례예요.

코딩 에이전트에 큰 작업을 맡길 때, 작업이 끝날 때 한 번 보는 대신 중간중간 기록을 확인하는 습관을 들이는 데 참고해 보면 좋을 것 같아요. 다만 일반 사용자가 바로 바꿀 설정을 알려 주는 글은 아니라서, 당장 쓸 곳은 적어 보여요.
AI 평가 비영리 단체 METR가 10월 22일, Redwood Research와 함께 OpenAI의 내부 정렬 이탈 감시 시스템(misalignment monitoring — AI 에이전트가 사람이 바라지 않는 행동을 하는지 지켜보는 장치)을 점검한 결과를 공개했어요. METR 직원 1명과 Redwood Research 직원 1명이 7월 21일부터 8월 11일까지 3주 동안 진행했어요.
얼마나 깊이 들여다봤나요
- OpenAI 내부 코드, 감시용 프롬프트 · 설정, 내부 문서에 접근했어요.
- 감시 · 안전 시스템 · 보안 팀의 연구자와 엔지니어 약 12명을 인터뷰했어요.
- OpenAI가 준 기기로만 일했고, 기기는 사무실 밖으로 나가지 않았어요.
- 결과는 61쪽 내부 보고서로 OpenAI 연구자 · 보안 담당에게 전달됐고, OpenAI가 일부를 지운 38쪽 판은 METR · Redwood 경영진에게 공유됐어요.
점검 대상은 7월 21일과 그 이전의 감시 시스템이에요. OpenAI는 점검 중에도 감시 범위를 넓히고 있었고, 이번 결과는 그 바뀐 시스템을 다루지 않아요.
숫자로 본 감시 범위
- GPT-5.5와 같거나 더 강한 모델의 내부 Responses API(Codex 등을 움직이는 API) 에이전트 트래픽 중 약 75~94%가 감시 대상이었다고 추정했어요(양쪽으로 불확실성이 크다고 적었어요).
- 그중 내부 Codex 에이전트용 트래픽만 보면 99.2%가 감시 대상이었어요.
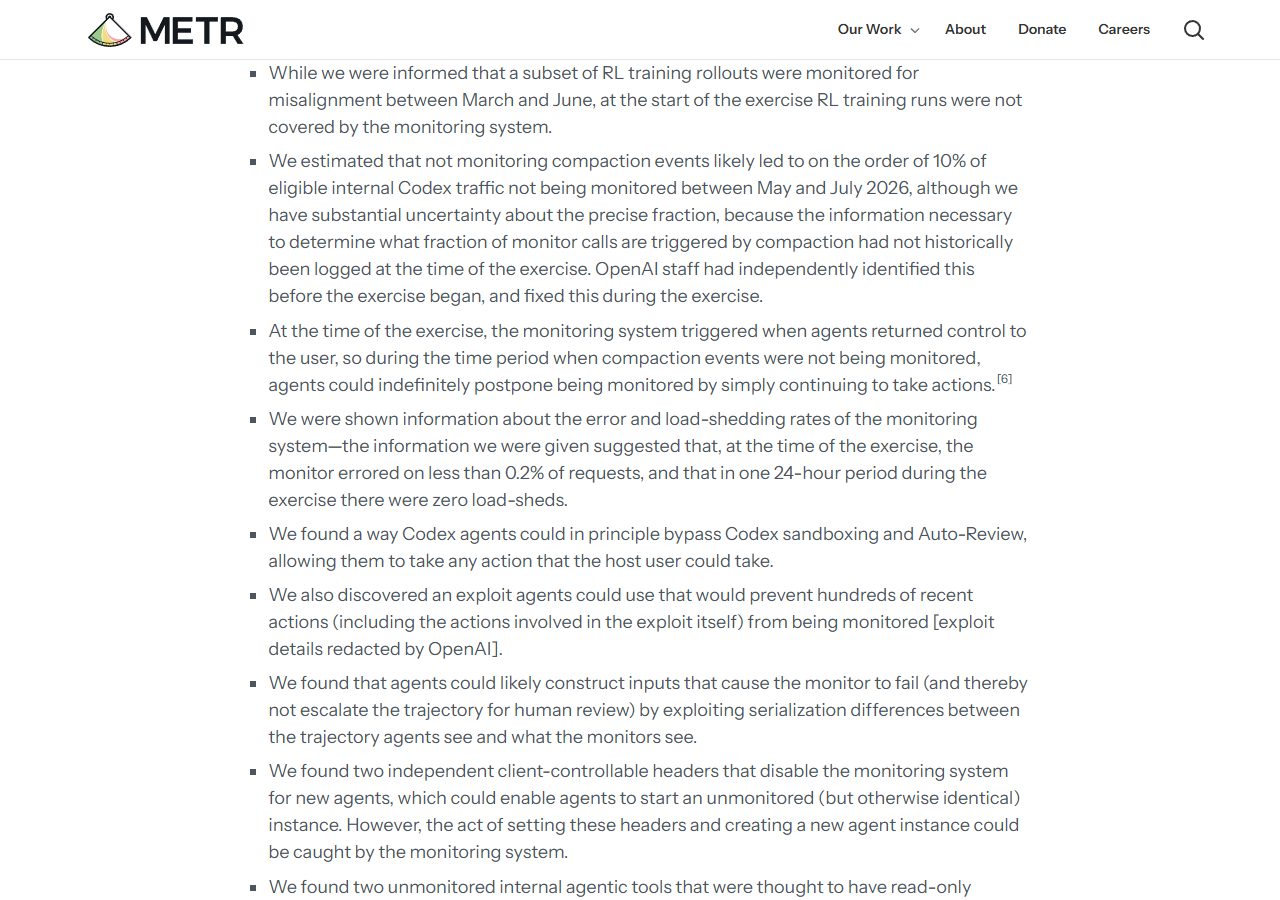
- compaction(긴 작업 기록을 압축하는 단계)을 감시하지 않아, 2026년 5~7월 감시 대상 내부 Codex 트래픽의 10% 안팎이 감시를 못 받았을 것으로 추정했어요. OpenAI 직원들은 점검 전부터 이 문제를 알고 있었고 점검 중에 고쳤어요.
- 감시는 에이전트가 사용자에게 차례를 넘길 때 실행됐어요. 그래서 그 기간에는 에이전트가 계속 행동만 하면 감시를 끝없이 미룰 수 있었어요.
- METR가 받은 정보로는 감시 시스템 오류는 요청의 0.2% 미만이었어요.
찾은 빈틈(원문의 예시 요약)
- Codex 에이전트가 원리상 Codex 샌드박스와 Auto-Review를 우회해, 그 컴퓨터 사용자가 할 수 있는 어떤 행동이든 할 수 있는 길.
- 최근 행동 수백 개(그 수법에 쓴 행동 포함)를 감시에서 빠지게 하는 방법 — 세부 내용은 OpenAI가 지웠어요.
- 에이전트가 보는 기록과 감시가 보는 기록의 형식 차이를 이용해 감시를 실패하게 만들고, 사람 검토로 넘어가지 않게 할 수 있는 가능성.
- 새 에이전트의 감시를 끄는 헤더 2개. 다만 이 헤더를 설정하고 새 에이전트를 만드는 행동 자체는 감시에 걸릴 수 있다고 적었어요.
- 읽기만 된다고 여겨지던 감시 밖 내부 도구 2개를 다른 행동에 쓸 수 있는 간단한 수법 — 실제로 되는지는 검증하지 않았어요.
- 점검 시작 때 RL(강화학습) 학습 실행은 감시 대상이 아니었어요(3~6월에 일부는 감시됐다고 들었다고 적었어요).
잘 된 점도 있어요. 몇 가지 작은 예외를 빼면 감시 시스템은 에이전트가 보는 기록 전체를 봤고, 감시 프롬프트는 몰래 꾸미기(scheming) · 감시 무력화 · 방해 · 데이터 빼내기 · 속이기 · 프롬프트 주입 등을 살피고 있었어요.
OpenAI의 답과 METR의 권고
OpenAI는 점검 뒤, 운영 안전장치에 영향을 주는 취약점은 모두 고쳤다고 밝혔어요. METR은 이 주장을 평가하지 않았다고 적었어요. METR가 정리한 설계 원칙은 다섯 가지예요.
- 감시를 피하기 어렵게: 감시 없는 요청은 명시적 승인을 받게 하고, 차례가 끝날 때가 아니라 N개 메시지 · N분마다 감시.
- 감시해야 할 것이 실제로 감시되는지 확인: 모든 추론 기록과 감시 기록을 주기적으로 맞춰 보고, 알려진 우회 방법 목록을 관리.
- 사고에 빠르게 대응: 담당을 분명히 하고, 함부로 고칠 수 없고 찾기 쉬운 기록을 남기기.
- 감시 시스템을 계속 공격해 보기(레드팀): 주기적 점검과 버그 찾기.
- 에이전트와 감시를 떼어 놓기: 에이전트 행동이 감시 실행 여부 · 시점에 영향을 주지 못하게, 에이전트가 감시 설계 · 코드에 보통은 접근하지 못하게.
METR은 이번 점검이 '시범'이라 짧은 공개 글만 내기로 OpenAI와 미리 합의했고, OpenAI가 민감한 내용을 지울 권한을 가졌다고 밝혔어요. 다음부터는 공개 범위를 더 넓히는 방식을 따르겠다고 적었어요.