'무엇을'보다 '왜'를 추천 — Sakana AI, 추천 이유를 진화시키는 QD-Rec 공개
후보 하나와 그걸 고를 이유(가설)를 한 쌍으로 묶고, LLM이 잘된 이유를 다른 후보에 옮겨 붙이며 추천 목록을 키워요. 인수합병·고객 타깃팅·논문 추천 세 분야에서 실험했고 코드는 Apache-2.0으로 열려 있어요.
- Sakana AI가 10월 20일 추천 방법 QD-Rec을 공개했어요. 추천 단위는 '후보 + 그걸 고를 이유(가설)' 한 쌍이고, 순위표 대신 질이 좋고 서로 다른 이유를 가진 추천 묶음(아카이브)을 키워요.
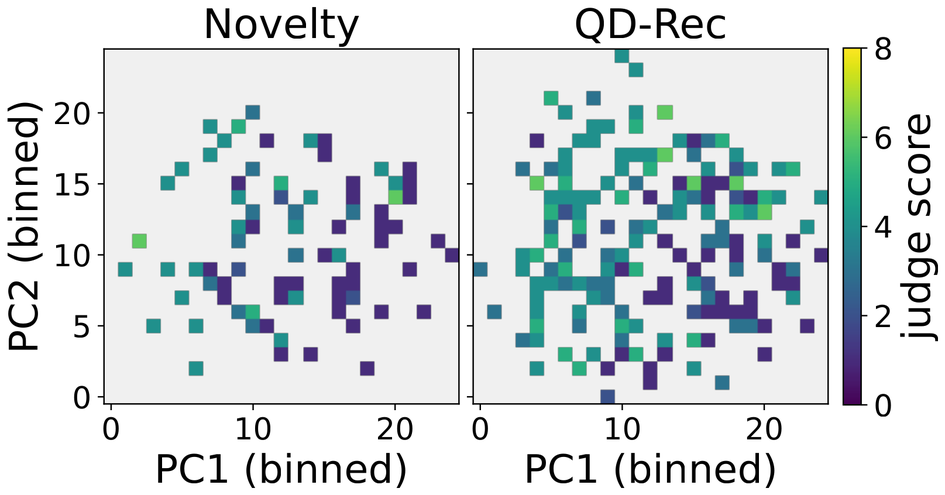
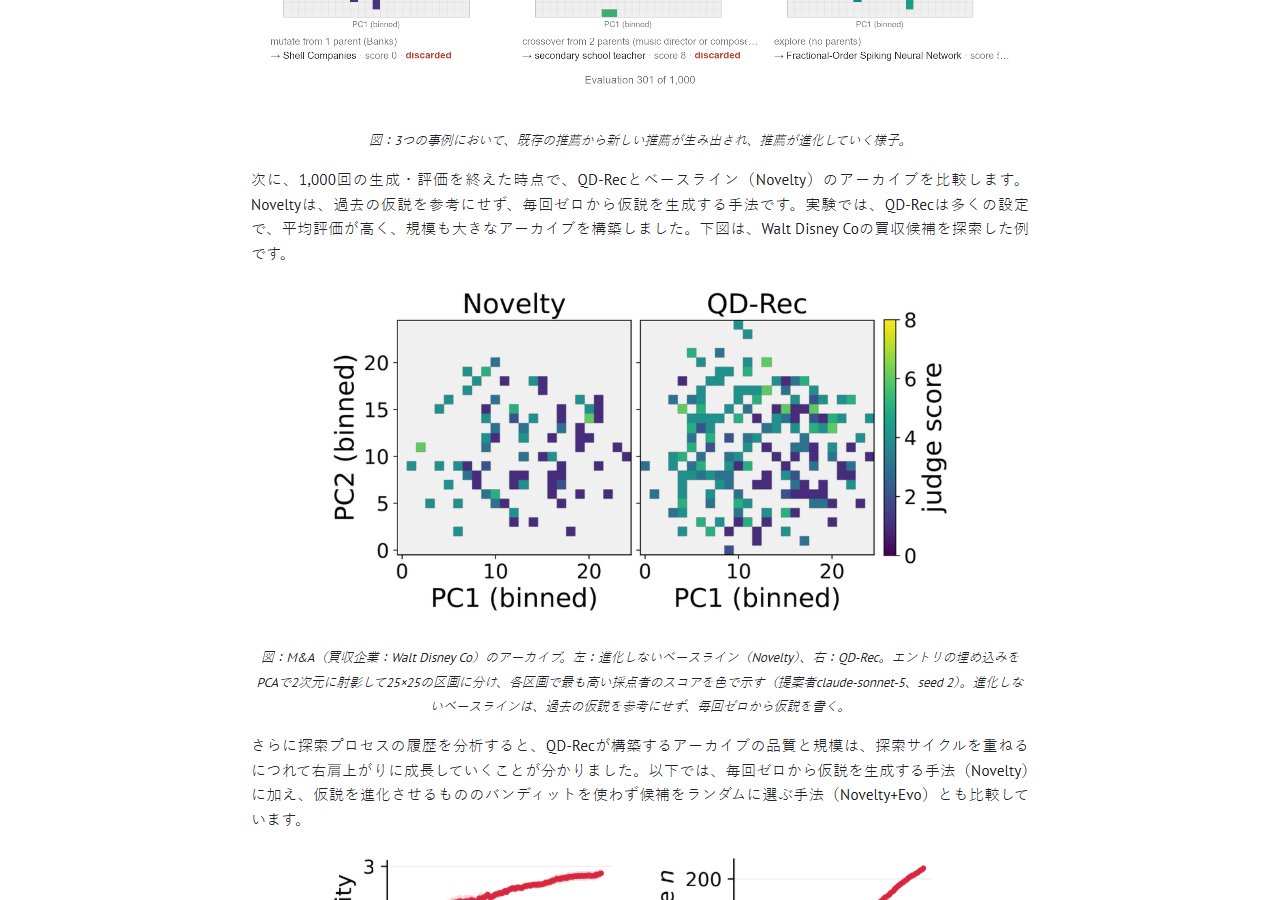
- 미국 기업 약 6,300곳(M&A), 가상 고객 프로필 10,000개(마케팅), AI 학회 논문 약 17,500편(논문 추천)으로 실험했고, 1,000번 생성·평가 뒤 '매번 처음부터 쓰는' 비교 방법과 같거나 더 나은 점수를 냈고, 대부분의 설정에서 아카이브가 가장 컸어요(예: 디즈니 M&A · Sonnet 5 제안 기준 평균 품질 2.91 대 2.40).
- 코드는 GitHub에 Apache-2.0으로 공개됐어요. OpenRouter 키 하나로 돌고, 기본 모델은 openai/gpt-6-luna예요(블로그 실험은 제안 claude-sonnet-5 · 채점 gpt-5.6-terra).
후보 목록(텍스트)과 프로필만 있으면 다른 분야에 옮길 수 있다고 README에 적혀 있어요. 네 가지 예제 앱 중 하나를 복사해 후보·프로필·프롬프트를 바꾸면 내 데이터로 실험해 볼 수 있어요.
고객 타깃팅 예제가 '이 사람에게 왜 이 상품이 맞는지' 이유를 여러 갈래로 써 줘요. 광고 문구를 대상별로 다르게 쓰기 전에 이유 후보를 모아 보는 데 참고할 수 있어요.
점수 하나로 줄 세우는 대신 '고를 이유가 서로 다른' 후보 묶음을 받는 방식이라, 협업처·제휴처 후보를 비교할 때의 생각 틀로 쓸 만해요. 다만 블로그도 생성 예시는 투자 조언이 아니라고 밝혔어요.
1. GitHub에서 SakanaAI/QD-Rec 받기 → uv sync (uv · Python 3.10 이상 필요)
2. cp .env.example .env 후 .env 에 OPENROUTER_API_KEY 넣기
3. 고객 예제(가상의 온라인 학습 서비스 SkillForge) 순서대로:
uv run python -m apps.customers.download_personas
uv run python -m apps.customers.create_embeddings
uv run python -m apps.customers.seed --profile SkillForge
uv run python -m apps.customers.qd_rec --profile SkillForge --iterations 100
4. 결과 대시보드 열기: uv run python -m shared.view_archive --open
라이선스 Apache-2.0 · 비용은 OpenRouter 모델 사용료(README 기본 모델은 '빠르고 저렴한 시험용' gpt-6-luna)

상품 하나를 누구에게 왜 팔지 이유를 여러 갈래로 모아 보고 싶을 때, 고객 예제를 내 상품 설명으로 바꿔 100번만 돌려 보면 좋을 것 같아요. 결과는 채점 AI 점수라서 마지막 판단은 사람이 하는 게 맞아 보여요.
Sakana AI가 10월 20일 추천 방법 QD-Rec을 공개했어요. 회사 블로그(일본어)와 영어 기술 글, 논문, 코드를 함께 냈어요. 논문은 10월 16일 arXiv에 처음 올라왔어요.
왜 '이유'를 추천하나
어느 회사를 인수 후보로 볼지, 새 상품을 어느 고객에게 권할지처럼 정해진 후보 중 하나를 고르는 일에서는 점수 순위표만으로는 부족할 때가 있다고 Sakana AI는 설명해요. 같은 후보라도 고를 이유가 여러 가지일 수 있어서예요. 그래서 QD-Rec은 후보 + 고를 이유(가설)를 추천 한 단위로 삼아요.
이름의 QD는 Quality-Diversity(질과 다양성, 가장 좋은 답 하나가 아니라 서로 다른 좋은 답 여러 개를 찾는 탐색 방식)예요.
세 단계를 되풀이해요
- 후보 고르기 — 지난 채점 결과를 보고, 좋은 이유가 나올 것 같은 후보와 아직 안 본 후보를 섞어 골라요. 여기에 밴디트(bandit, 시도하며 배우는 선택 기법)를 써요.
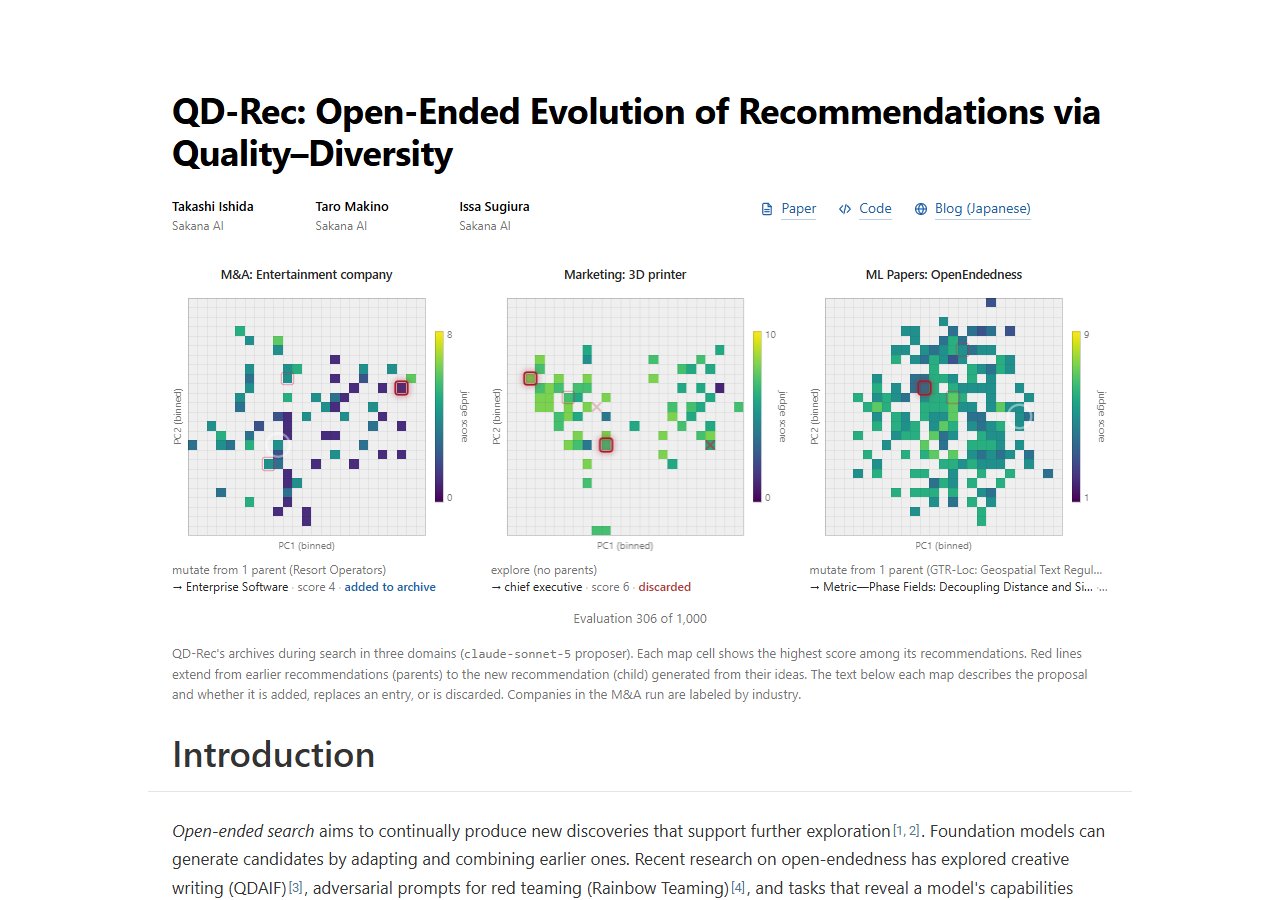
- 이유 쓰기 — 제안 역할 LLM이 보관함(아카이브)의 예전 이유를 '부모'로 삼아, 새 후보에 맞게 조금 바꾸거나(mutate) 여러 개를 섞거나(crossover) 예시에 없는 방향을 써요(explore).
- 보관함 고치기 — 채점 역할 AI(또는 사람)가 새 이유를 매겨요. 완전히 새로운 관점이면 바로 보관함에 들어가고, 아니면 가장 비슷한 기존 이유 하나와만 1대1로 겨뤄 이기면 그 자리를 차지해요.
세 분야 실험
- M&A — 2024년 8월 기준 미국 기업 약 6,300곳(사업 설명 평균 약 123단어 + 재무 7개 항목)에서 Walt Disney Co와 JPMorgan Chase & Co의 인수 후보와 이유 찾기
- 마케팅 — 가상의 캘리포니아 고객 프로필 10,000개(평균 약 685단어, NVIDIA Nemotron-Personas-USA)에서 3D 프린터·온라인 학습 서비스의 고객 찾기
- 논문 추천 — ICLR 2026 · ICML 2026 · NeurIPS 2025 채택 논문 약 17,500편(제목과 초록)에서 연구자 프로필에 맞는 논문 찾기
각 실험은 처음 추천 10개로 시작해 1,000번 생성·평가했고, 설정마다 시드 5개로 되풀이했어요. 비교 대상은 매번 처음부터 이유를 쓰는 Novelty와, 이유는 진화시키되 후보를 무작위로 고르는 Novelty+Evo예요. 논문은 QD-Rec이 "대부분의 설정에서" 평균 점수가 가장 높고 보관함이 가장 컸다고 밝혔어요. 모든 설정에서 그런 것은 아니에요.
생성 예: 1점짜리 이유가 디딤돌이 돼요
블로그 예시(제안 claude-sonnet-5, 채점 gpt-5.6-terra)에서, 처음부터 쓴 방법은 JPMorgan의 Liberty TripAdvisor Holdings 인수에 반대 논리를 써서 10점 만점에 1점을 받았어요. QD-Rec은 Southwest Airlines 인수 이유(역시 1점)에서 '여행 구매 흐름에 대출·결제·포인트를 붙인다'는 생각만 가져와 Liberty TripAdvisor에 옮겼고, 5점을 받았어요.
고객 예시에서는 29세 간호사(가상 인물)에게 온라인 학습 서비스를 권하는 이유가 처음부터 쓴 방법으론 2점이었는데, 46세 유치원 교사에게 쓴 7점짜리 이유의 논리를 옮겨 7점이 됐어요.
X 게시물 보기 · https://x.com/sakanaailabs/status/2112507110290502109
주의할 점
Sakana AI는 이 인수안들이 방법을 평가하려고 모델이 만든 가설이며 투자 조언이 아니라고 밝혔어요. 예시 안의 "1억 명이 넘는 회원" 같은 내용은 확인되지 않았고, 데이터 시점(2024년 8월) 뒤인 2025년 4월에 Liberty TripAdvisor Holdings가 Tripadvisor에 인수됐다고도 적었어요. LLM 채점은 내용을 좋게 하지 않고 채점자의 약점을 파고드는 위험이 있어, 사람이 채점하거나 사람과 LLM이 나눠 맡는 방법도 제안했어요.
코드와 여러 분야의 예제는 GitHub(SakanaAI/QD-Rec)에 Apache-2.0으로 공개됐어요. 모든 모델은 OpenRouter로 돌아서 OPENROUTER_API_KEY 하나만 있으면 되고, M&A 실험에 쓴 데이터(LSEG Workspace)는 유료 구독이 필요해 저장소엔 형식 예시만 들어 있어요.