PDF 속 표 · 차트를 그대로 옮기는 4B 모델 — LlamaIndex 'OCRia-1', 한 쪽 2.2초
LlamaIndex가 10월 22일 문서 읽기(파싱) 전용 모델 OCRia-1을 공개했어요. 표 · 차트 · 서식을 살려 Markdown으로 옮기고, 지금 LlamaParse와 OpenDocRouter에서 쓸 수 있어요. 모델 파일은 아직 공개 전이에요.
- OCRia-1은 40억(4B) 파라미터 비전-언어 모델(VLM · 그림과 글을 함께 읽는 AI)이에요. 문서 한 쪽을 Markdown으로 옮기면서 표는 HTML 표로, 차트는 데이터 표로, 수식은 LaTeX로 적어요. LlamaParse에 이미 들어가 있어요.
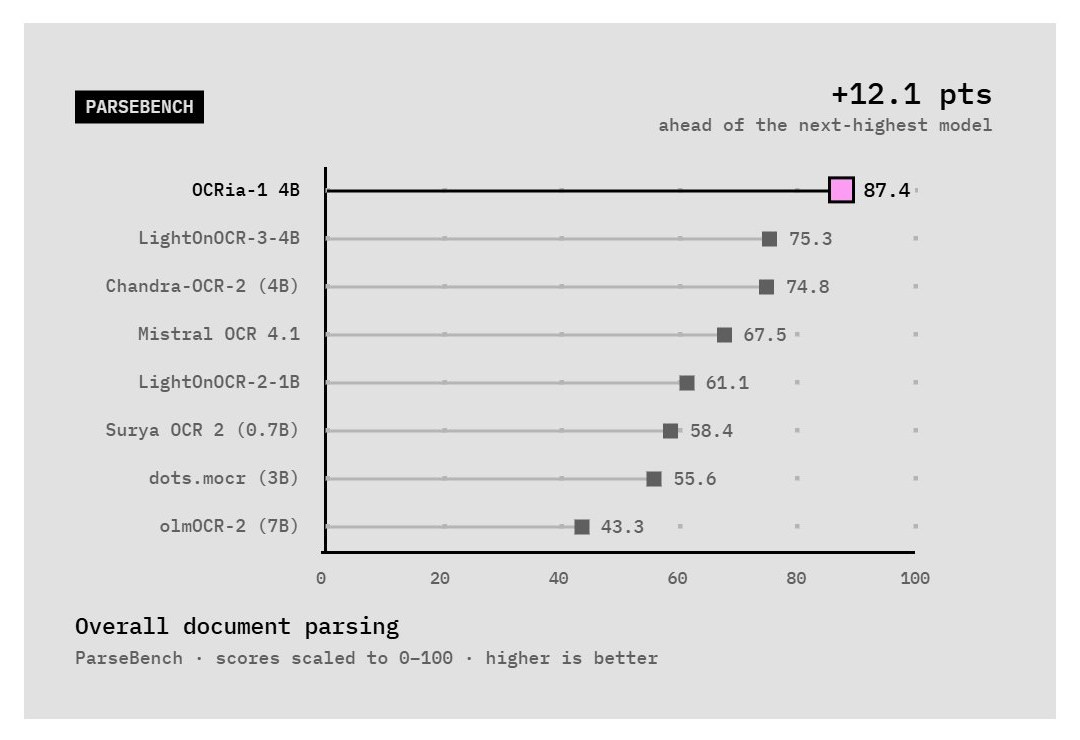
- LlamaIndex 블로그 기준 ParseBench(문서 파싱 시험) 종합 87.4점으로, 350억(35B) 파라미터 이하 파싱 모델 중 1위 · 다음 모델(LightOnOCR-3-4B 75.3)보다 12.1점 높아요. 차트 항목은 85.1 대 66.1이에요.
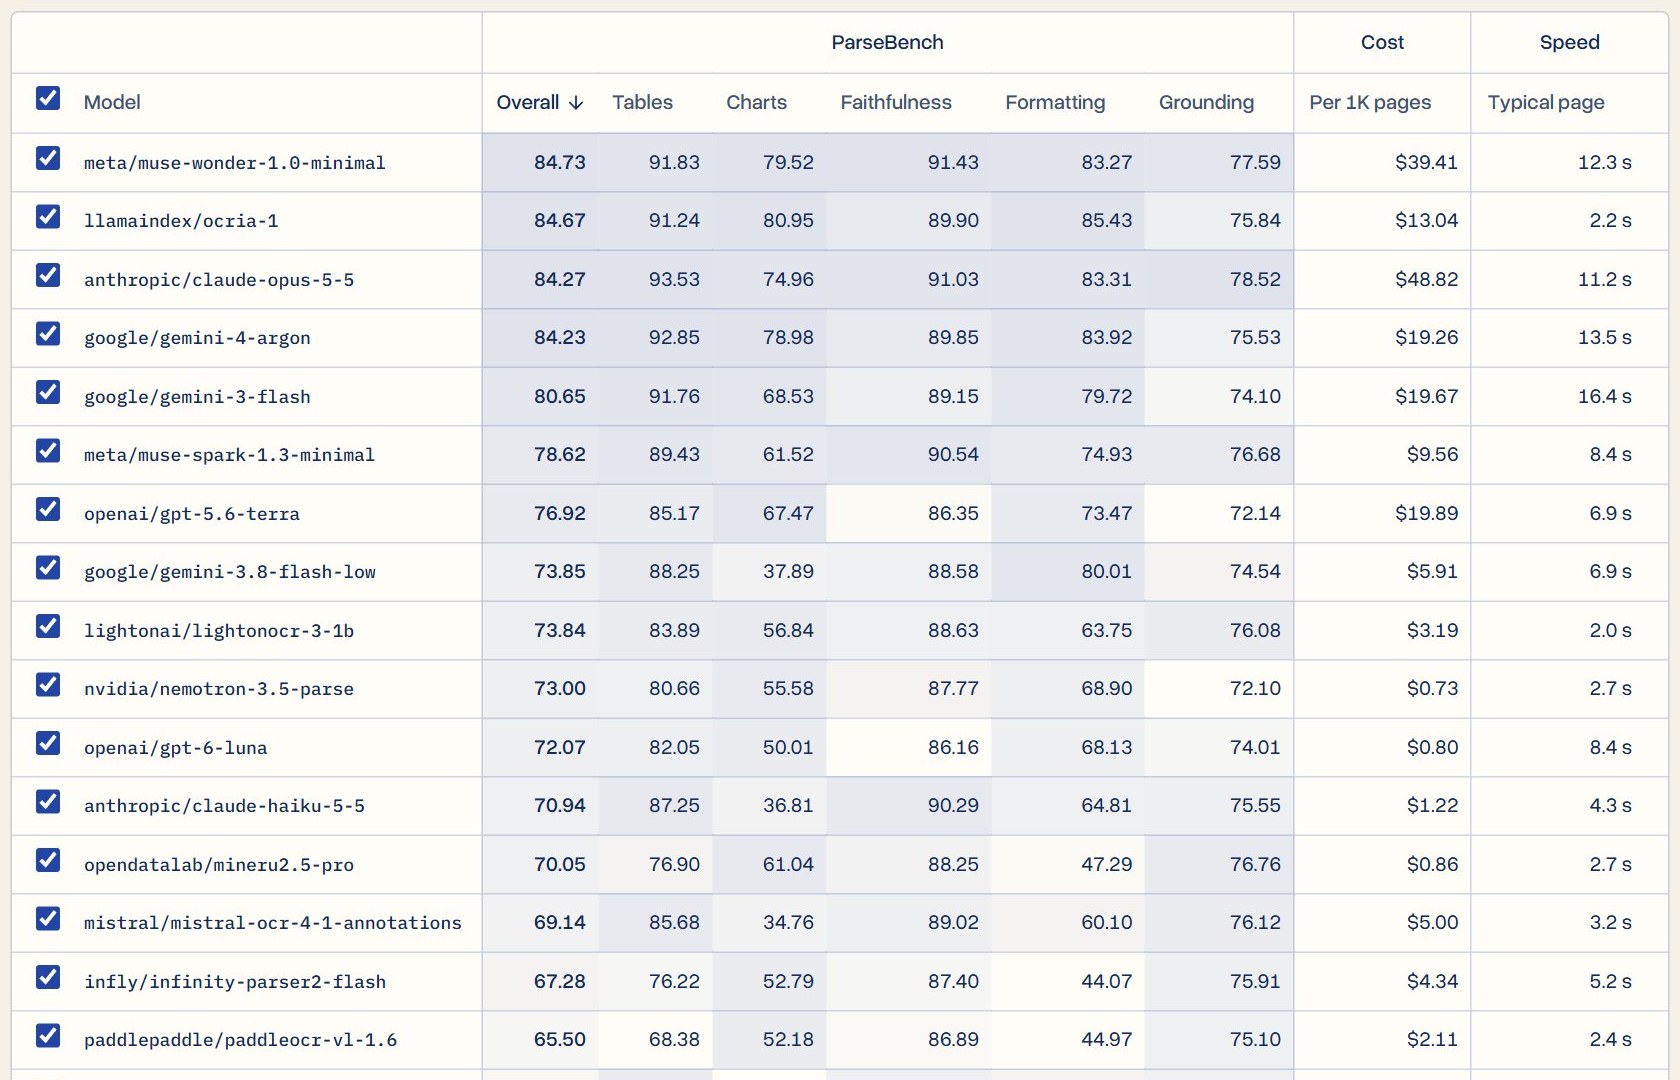
- 다만 Claude · Gemini 같은 큰 모델까지 함께 잰 OpenDocRouter 표(10월 25일 기준 · 5개 항목 평균)에선 84.67로 2위예요(1위 meta/muse-wonder-1.0-minimal 84.73). 모델 파일은 「곧 공개할 계획」이라고만 했어요.
OpenDocRouter에서 model만 llamaindex/ocria-1로 바꿔, 지금 쓰는 Gemini · Claude 파싱과 같은 PDF로 표 · 차트 결과와 시간을 나란히 비교해 볼 수 있어요.
보고서 PDF 속 막대 · 꺾은선 차트를 숫자 표로 뽑아, 카드뉴스나 인포그래픽을 다시 그릴 재료로 쓰기 좋아요.
은행 거래 내역 · 견적서처럼 칸이 합쳐진 표가 많은 PDF를 정리할 때 후보로 올려 둘 만해요. 다만 API 사용이라 개발 도움이 조금 필요해요.
1) OpenDocRouter 모델 표에서 llamaindex/ocria-1의 가격 · 속도를 확인한다 2) 파싱 요청의 model에 llamaindex/ocria-1을 넣는다(요청 방법은 공식 문서의 안내를 따르세요) 3) 표 · 차트가 많은 내 PDF 몇 쪽을 다른 모델과 같이 돌려 결과를 비교한다

차트가 많은 리포트 PDF에서 숫자를 뽑아 카드뉴스 · 인포그래픽으로 다시 만들 때 써 보면 좋을 것 같아요.
LlamaIndex가 블로그에서 문서 파싱 모델 OCRia-1을 공개했어요. 문서 파싱은 PDF · 스캔 이미지를 AI가 읽을 수 있는 글로 바꾸는 일이에요. OCRia-1은 4B 크기의 비전-언어 모델(VLM)이고, 블로그는 LlamaIndex의 문서 읽기 서비스 LlamaParse가 지금 이 모델로 돌아간다고 적었어요.
무엇을 잘하나요
기술 보고서를 보면 OCRia-1은 Qwen3.5-4B를 바탕으로 만들었어요. 한 쪽을 Markdown으로 옮기면서 표는 HTML 표(합친 칸 · 여러 줄 머리글까지), 차트는 데이터 점을 담은 표, 수식은 LaTeX로 적어요. 위첨자 · 아래첨자 · 취소선 · 체크박스 같은 서식도 남겨요.
- 종합: ParseBench 87.4 — 35B 이하 파싱 모델 중 가장 높고, 다음 모델(LightOnOCR-3-4B 75.3)보다 12.1점 앞서요(텍스트 · 서식 · 표 · 차트 4개 항목 기준).
- 차트: 85.1 — 다음 모델 66.1보다 19.0점 높아요. 숫자가 맞는 행 · 열 머리글 아래 있어야 점수를 받는 방식이에요.
- 서식: 83.4 — 다음 시스템은 67.9예요.
- 표: ParseBench · olmOCR-bench · PulseBench-Tab · fr-bench-pdf2md 네 시험의 표 항목에서 모두 1위라고 밝혔어요(블로그가 고른 비교 모델 기준).
큰 모델들과 나란히 보면
LlamaIndex가 만든 문서 파싱 API OpenDocRouter의 모델 표에는 Claude · Gemini · GPT 같은 범용 모델도 함께 올라 있어요. 10월 25일 기준 이 표(ParseBench 5개 항목 평균)에서 OCRia-1(llamaindex/ocria-1)은 84.67로 2위예요. 1위는 meta/muse-wonder-1.0-minimal(84.73), 3위 anthropic/claude-opus-5-5(84.27), 4위 google/gemini-4-argon(84.23)이에요.
눈에 띄는 건 속도와 가격이에요. 같은 표에서 OCRia-1은 보통 한 쪽에 2.2초, 1,000쪽에 $13.04예요. google/gemini-4-argon은 13.5초 · $19.26, google/gemini-3-flash는 16.4초 · $19.67, anthropic/claude-opus-5-5는 11.2초 · $48.82예요. 점수는 낮지만 더 싼 모델도 있어요(mistral/mistral-ocr-4-1 62.22점 · 1.7초 · $4.00). 1,000쪽 가격은 ParseBench 문서 기준 추정이라, 내 문서는 더 들거나 덜 들 수 있어요.
얼마나 빠르게 돌아가나
기술 보고서 기준으로 B200 GPU 한 장에서 동시 요청 64개를 넣으면 초당 약 10쪽(10.21쪽)을 읽어요. 하루로 치면 GPU 한 장이 약 86만 쪽이에요. 학습엔 표 · 차트 · 수식 · 여러 언어 · 읽기 어려운 스캔처럼 어려운 문서 10만 쪽 넘게 썼고, 지도 학습(SFT)과 검증 가능한 보상 강화학습(RLVR)을 함께 썼다고 해요.
알아 둘 점
모델 파일(가중치)은 아직 풀리지 않았어요. 보고서는 「OCRia-1의 한 버전을 곧 공개할 계획」이라고만 적었어요. 지금은 LlamaParse나 OpenDocRouter를 통해서만 써 볼 수 있어요.